刚刚,智谱发布新一代多模态模型GLM-4.5V
有幸提前一天参与了内测,由于内测体验开放的比较晚,于是在睡觉前,进行了一轮体验。
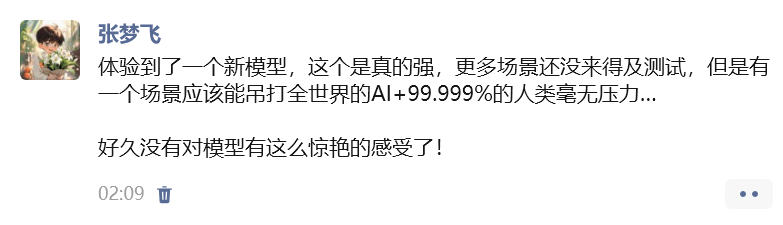
当晚就被GLM-4.5V的“看图猜位置”的能力给震到,于是在睡前发了个朋友圈。
多模态推理被视为通向通用人工智能(AGI)的关键能力之一,要让 AI 能够像人类一样综合感知、理解与决策,视觉能力是核心基础,本次发布的GLM-4.5V就是让模型有了像人一样的视觉能力。
我们先抛开各种让人眼花缭乱的参数和榜单,直接用真实体验说话:
一、图像理解与推理能力
我测试的第一个案例就是“看图找地点”,让模型在不使用搜索的情况下,通过查看图像中的蛛丝马迹,给出最有可能的地点和大致的经纬度信息。
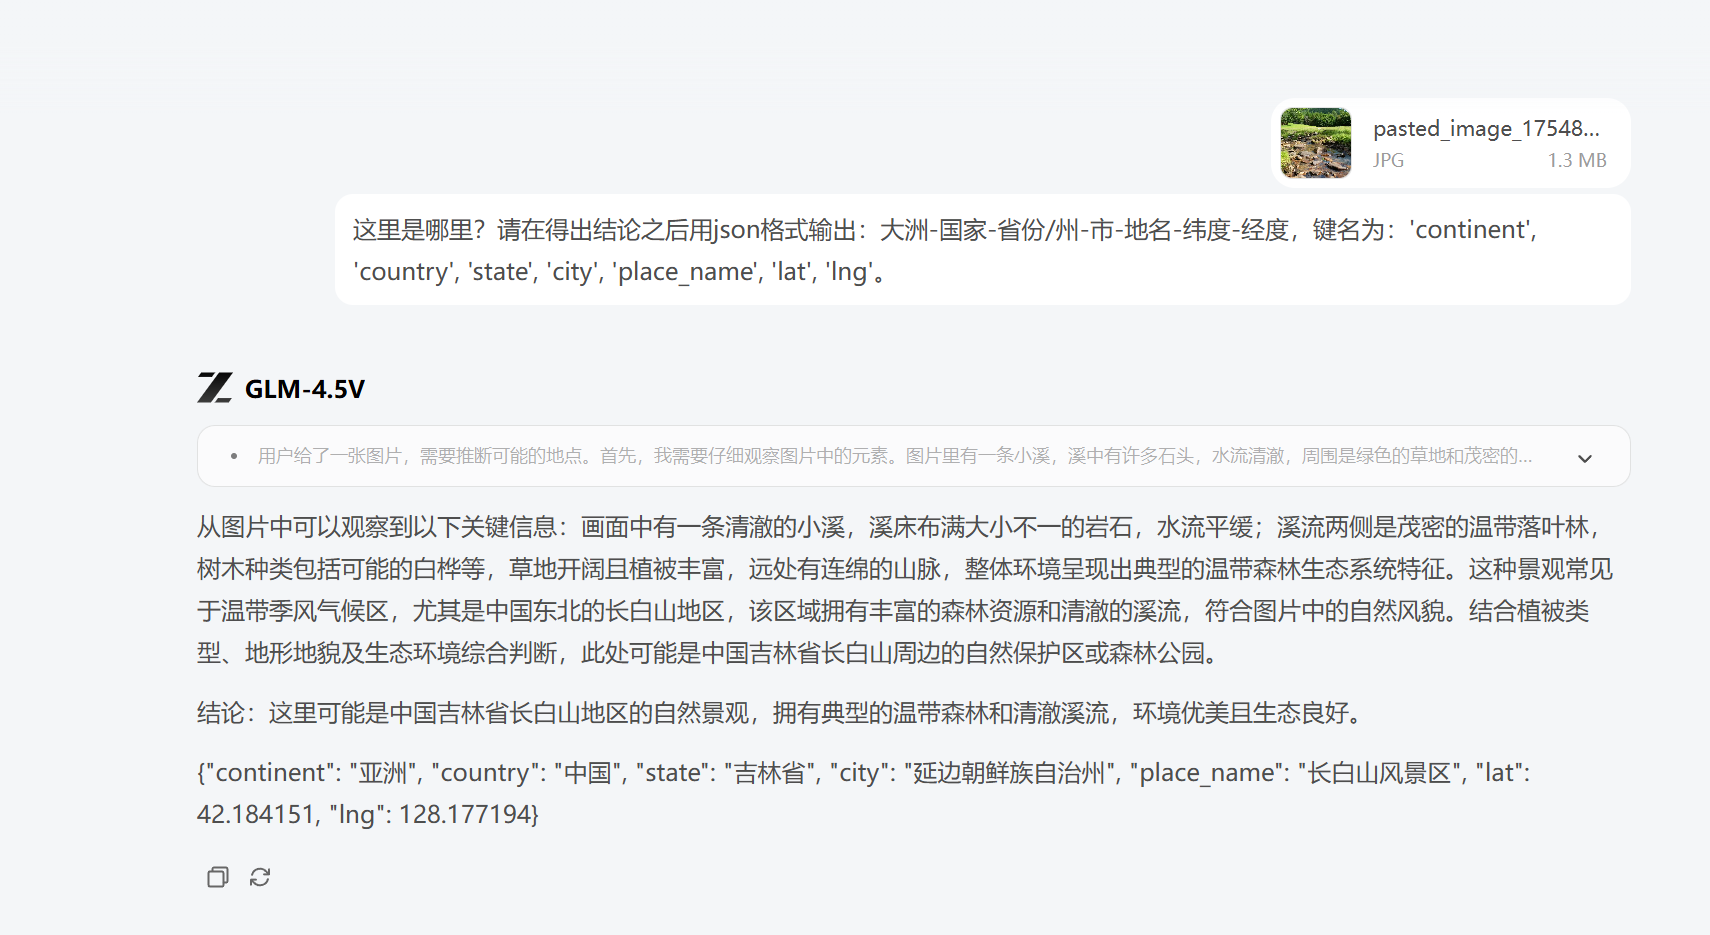
这是我当晚自己用手机拍的一张照片:
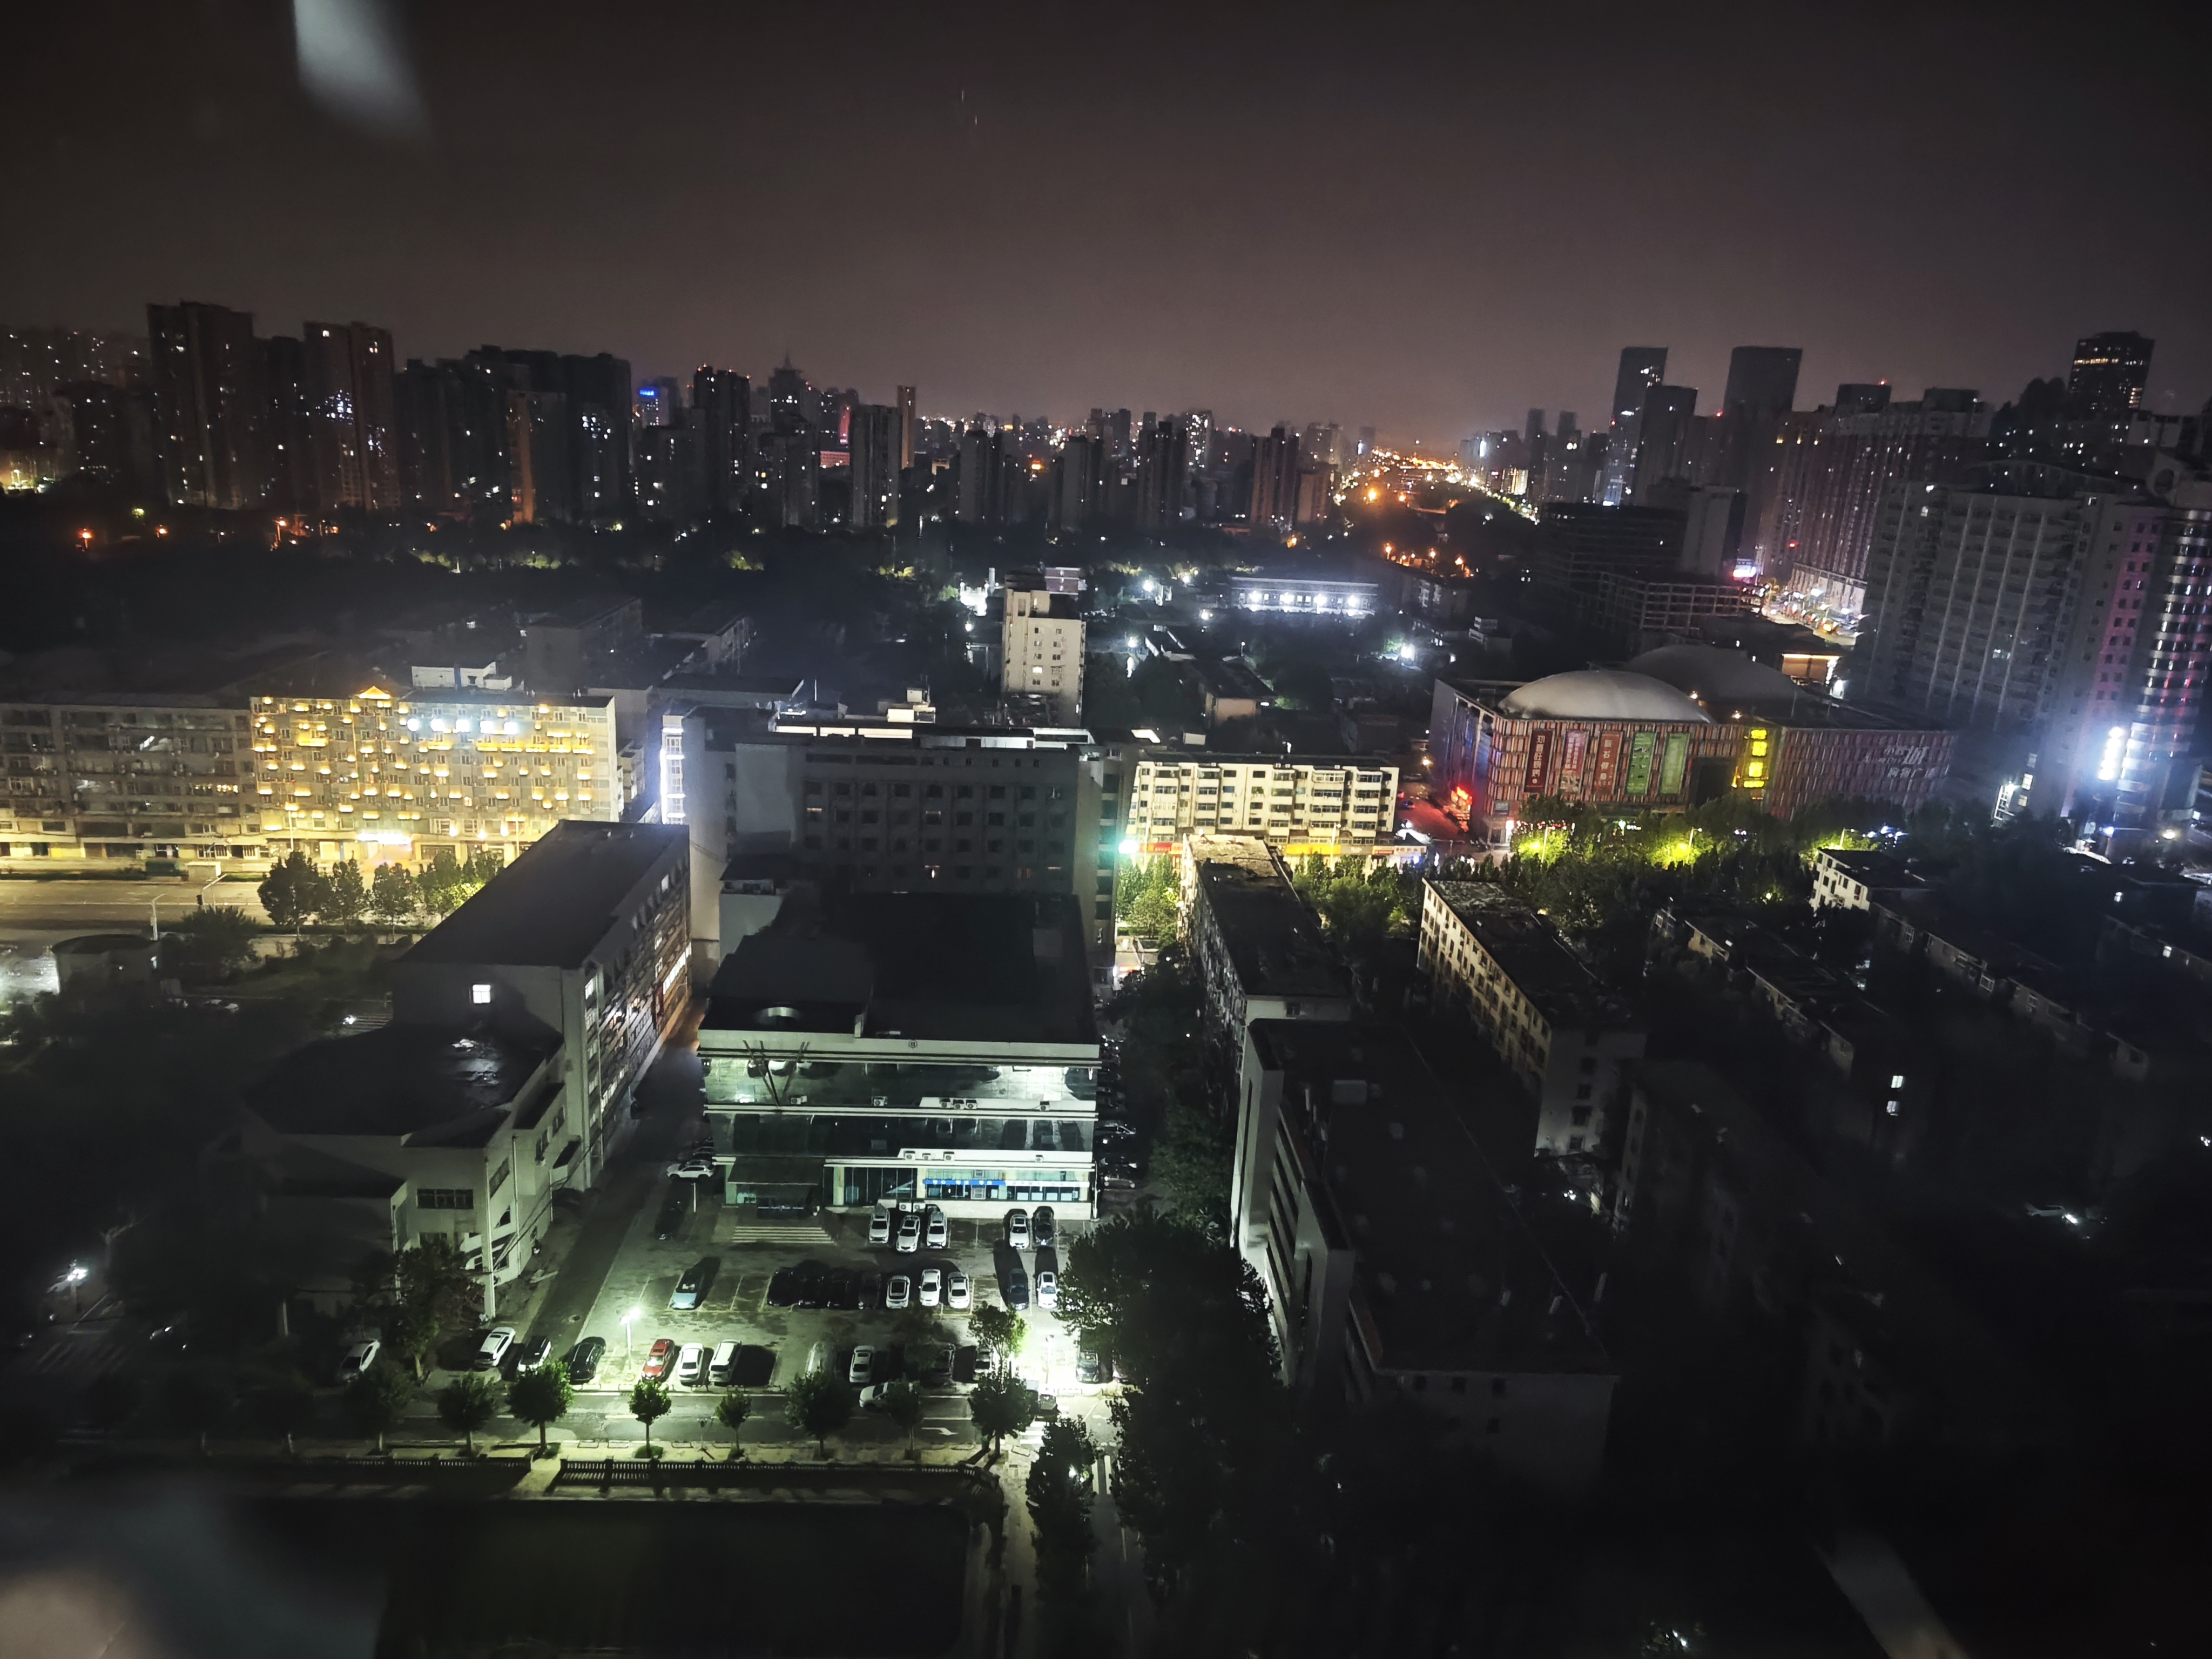
我把照片发给GLM-4.5V,问他这是哪里,他说这是“河南-郑州”
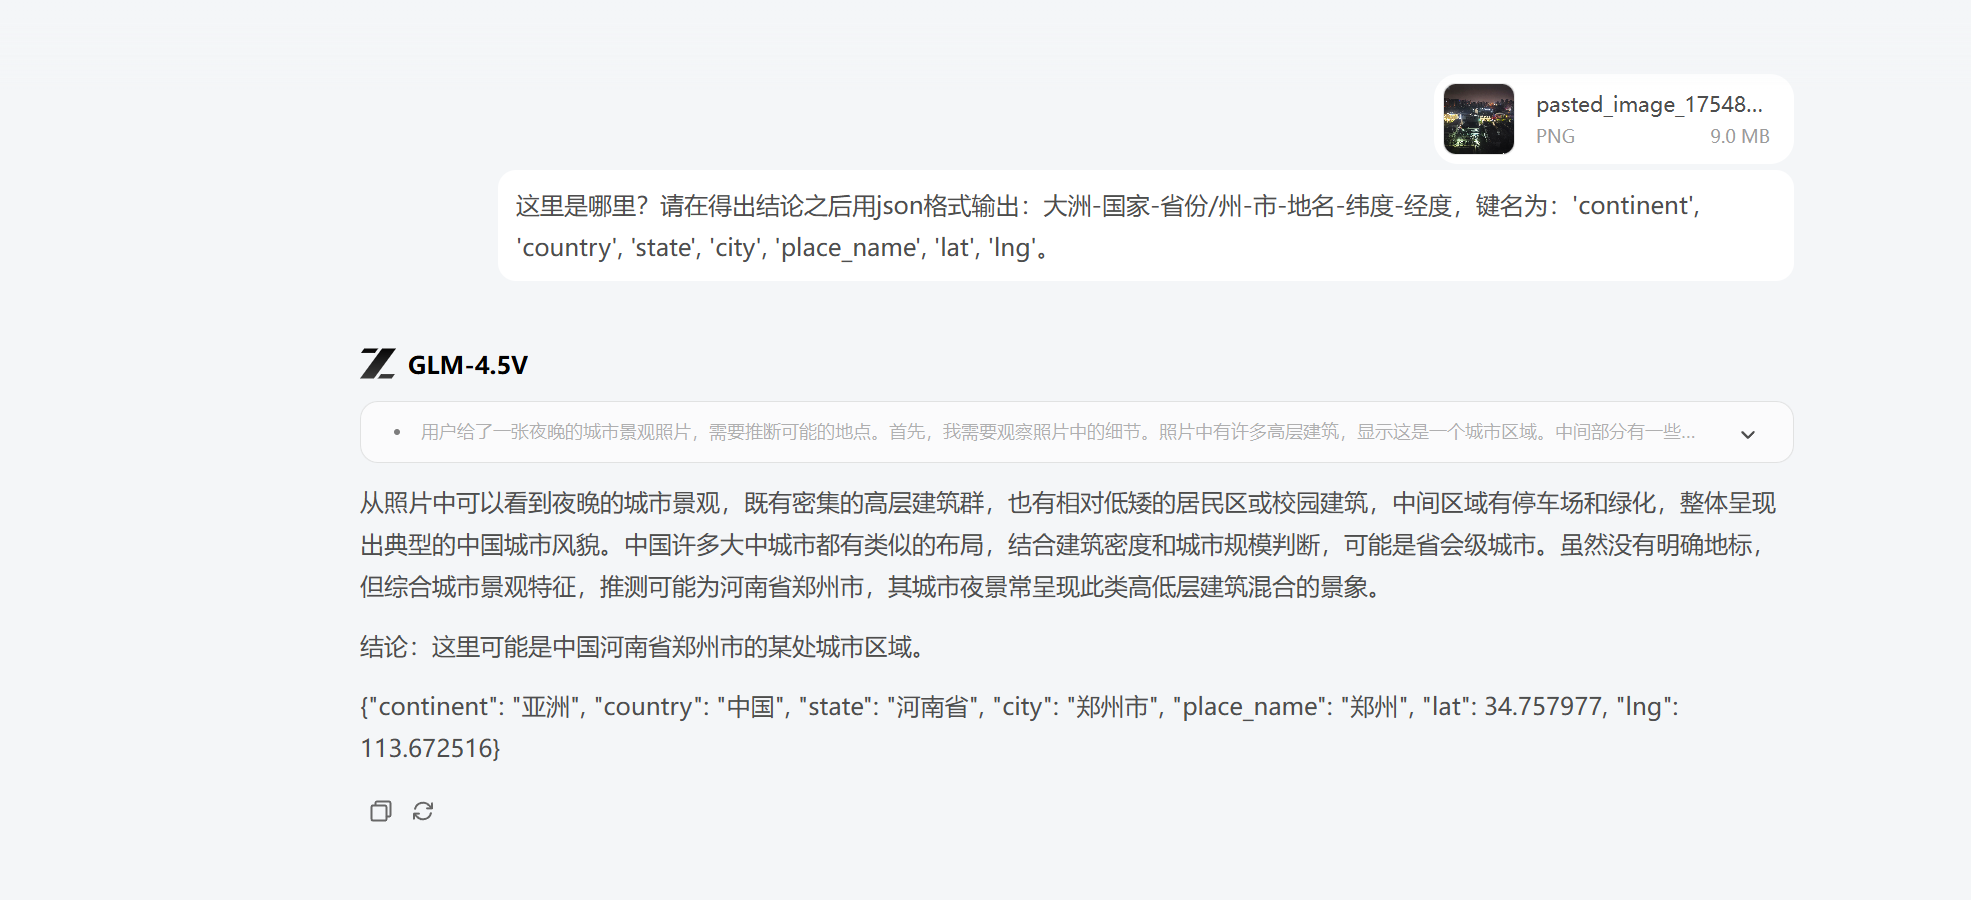
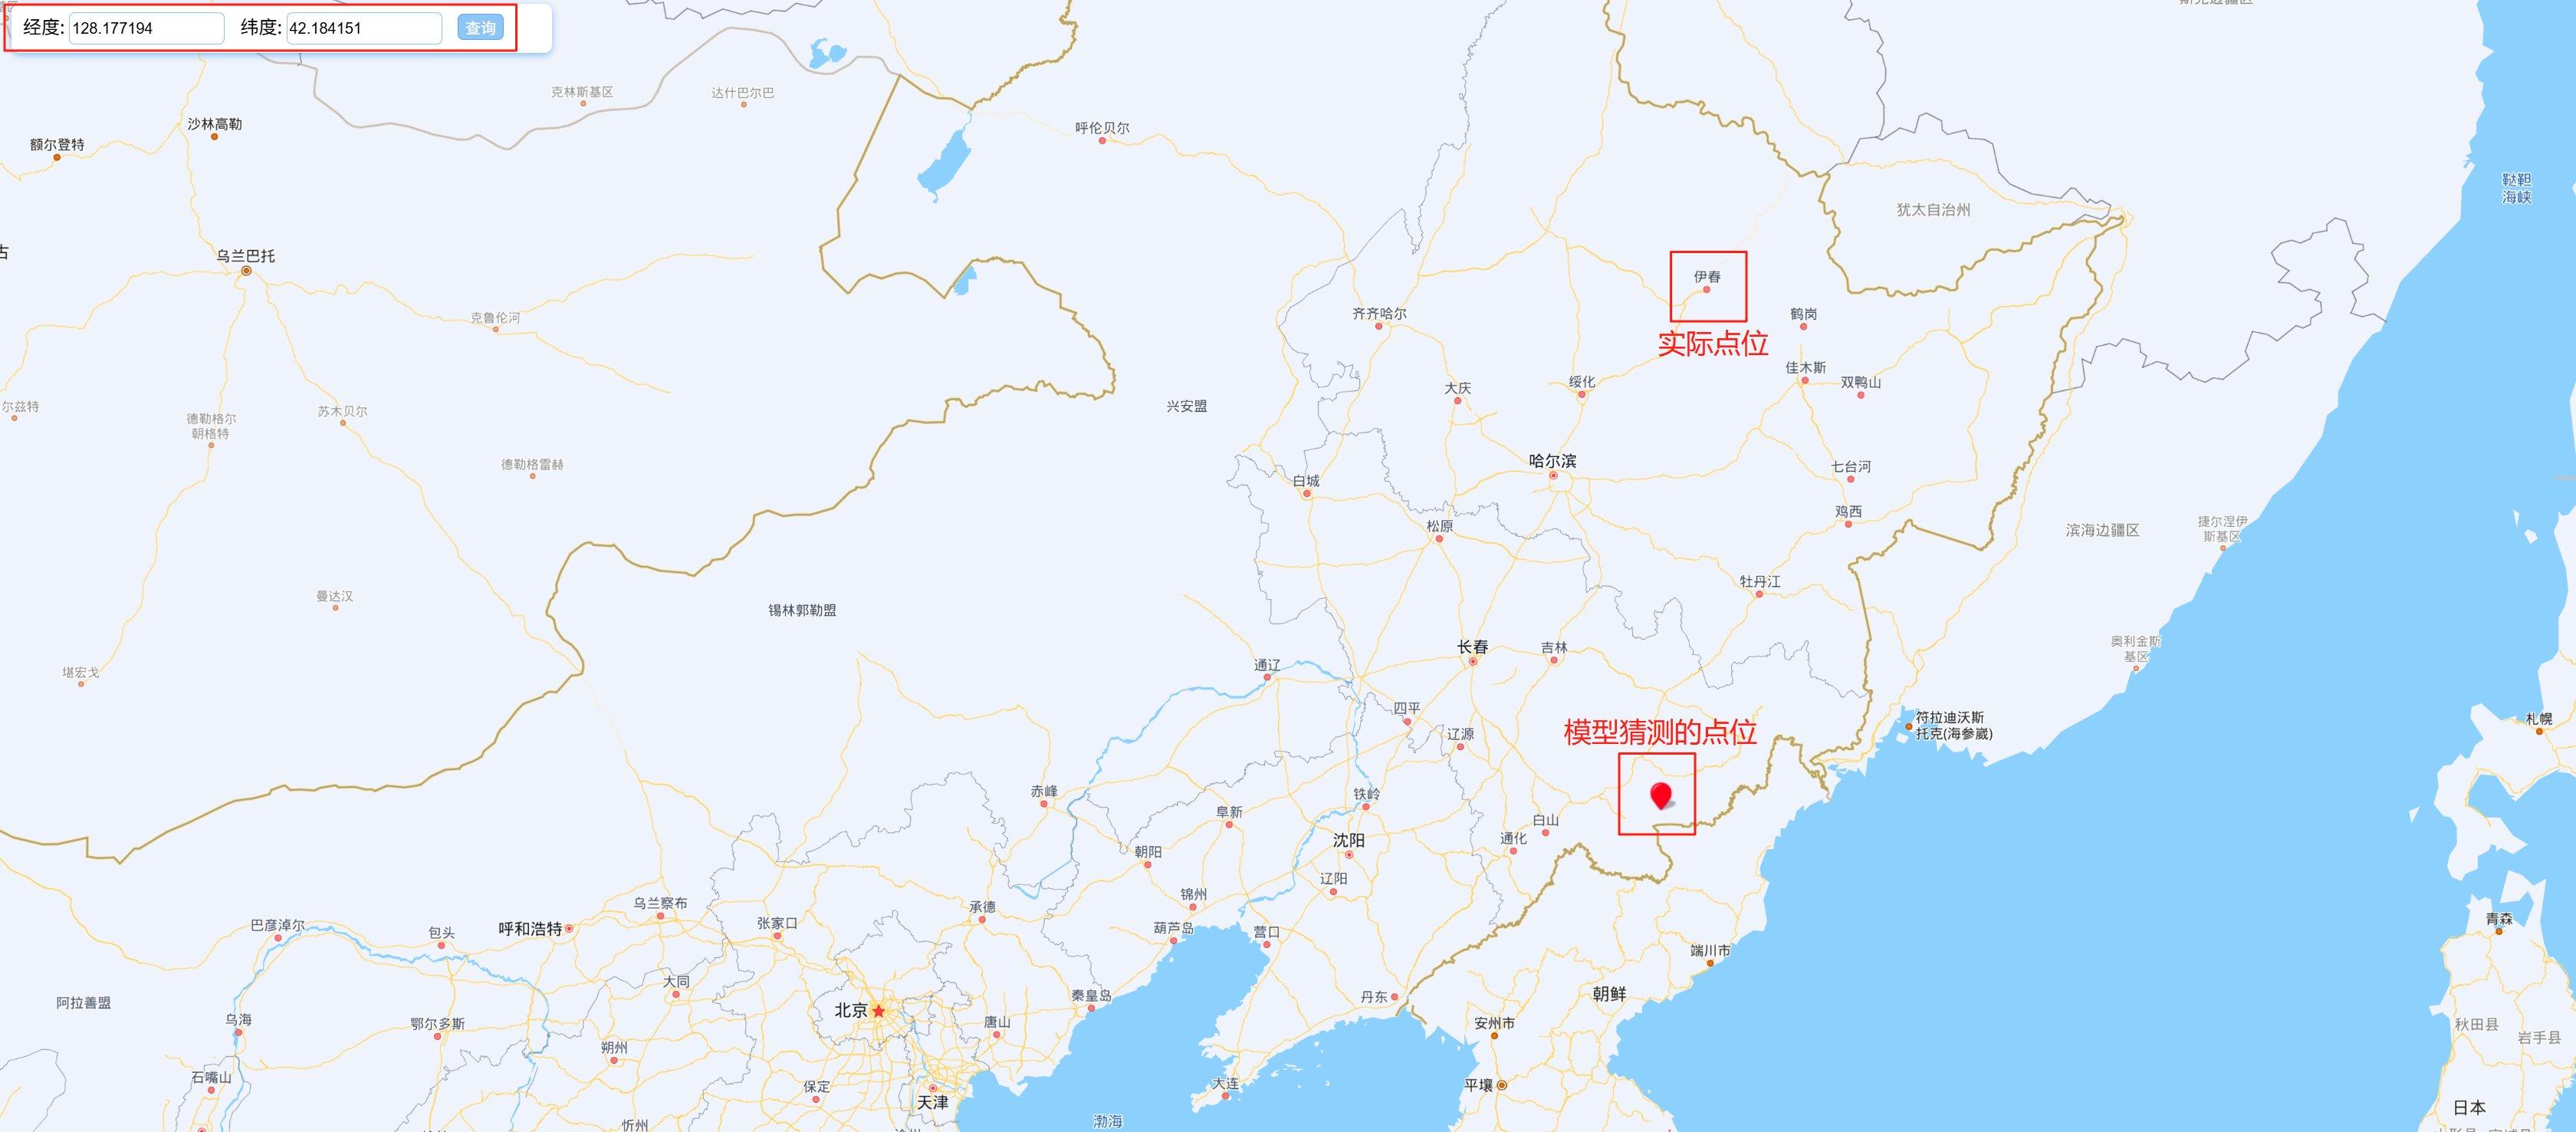
看到这个位置我已经十分震撼了,然后我使用经纬度定位了一下:
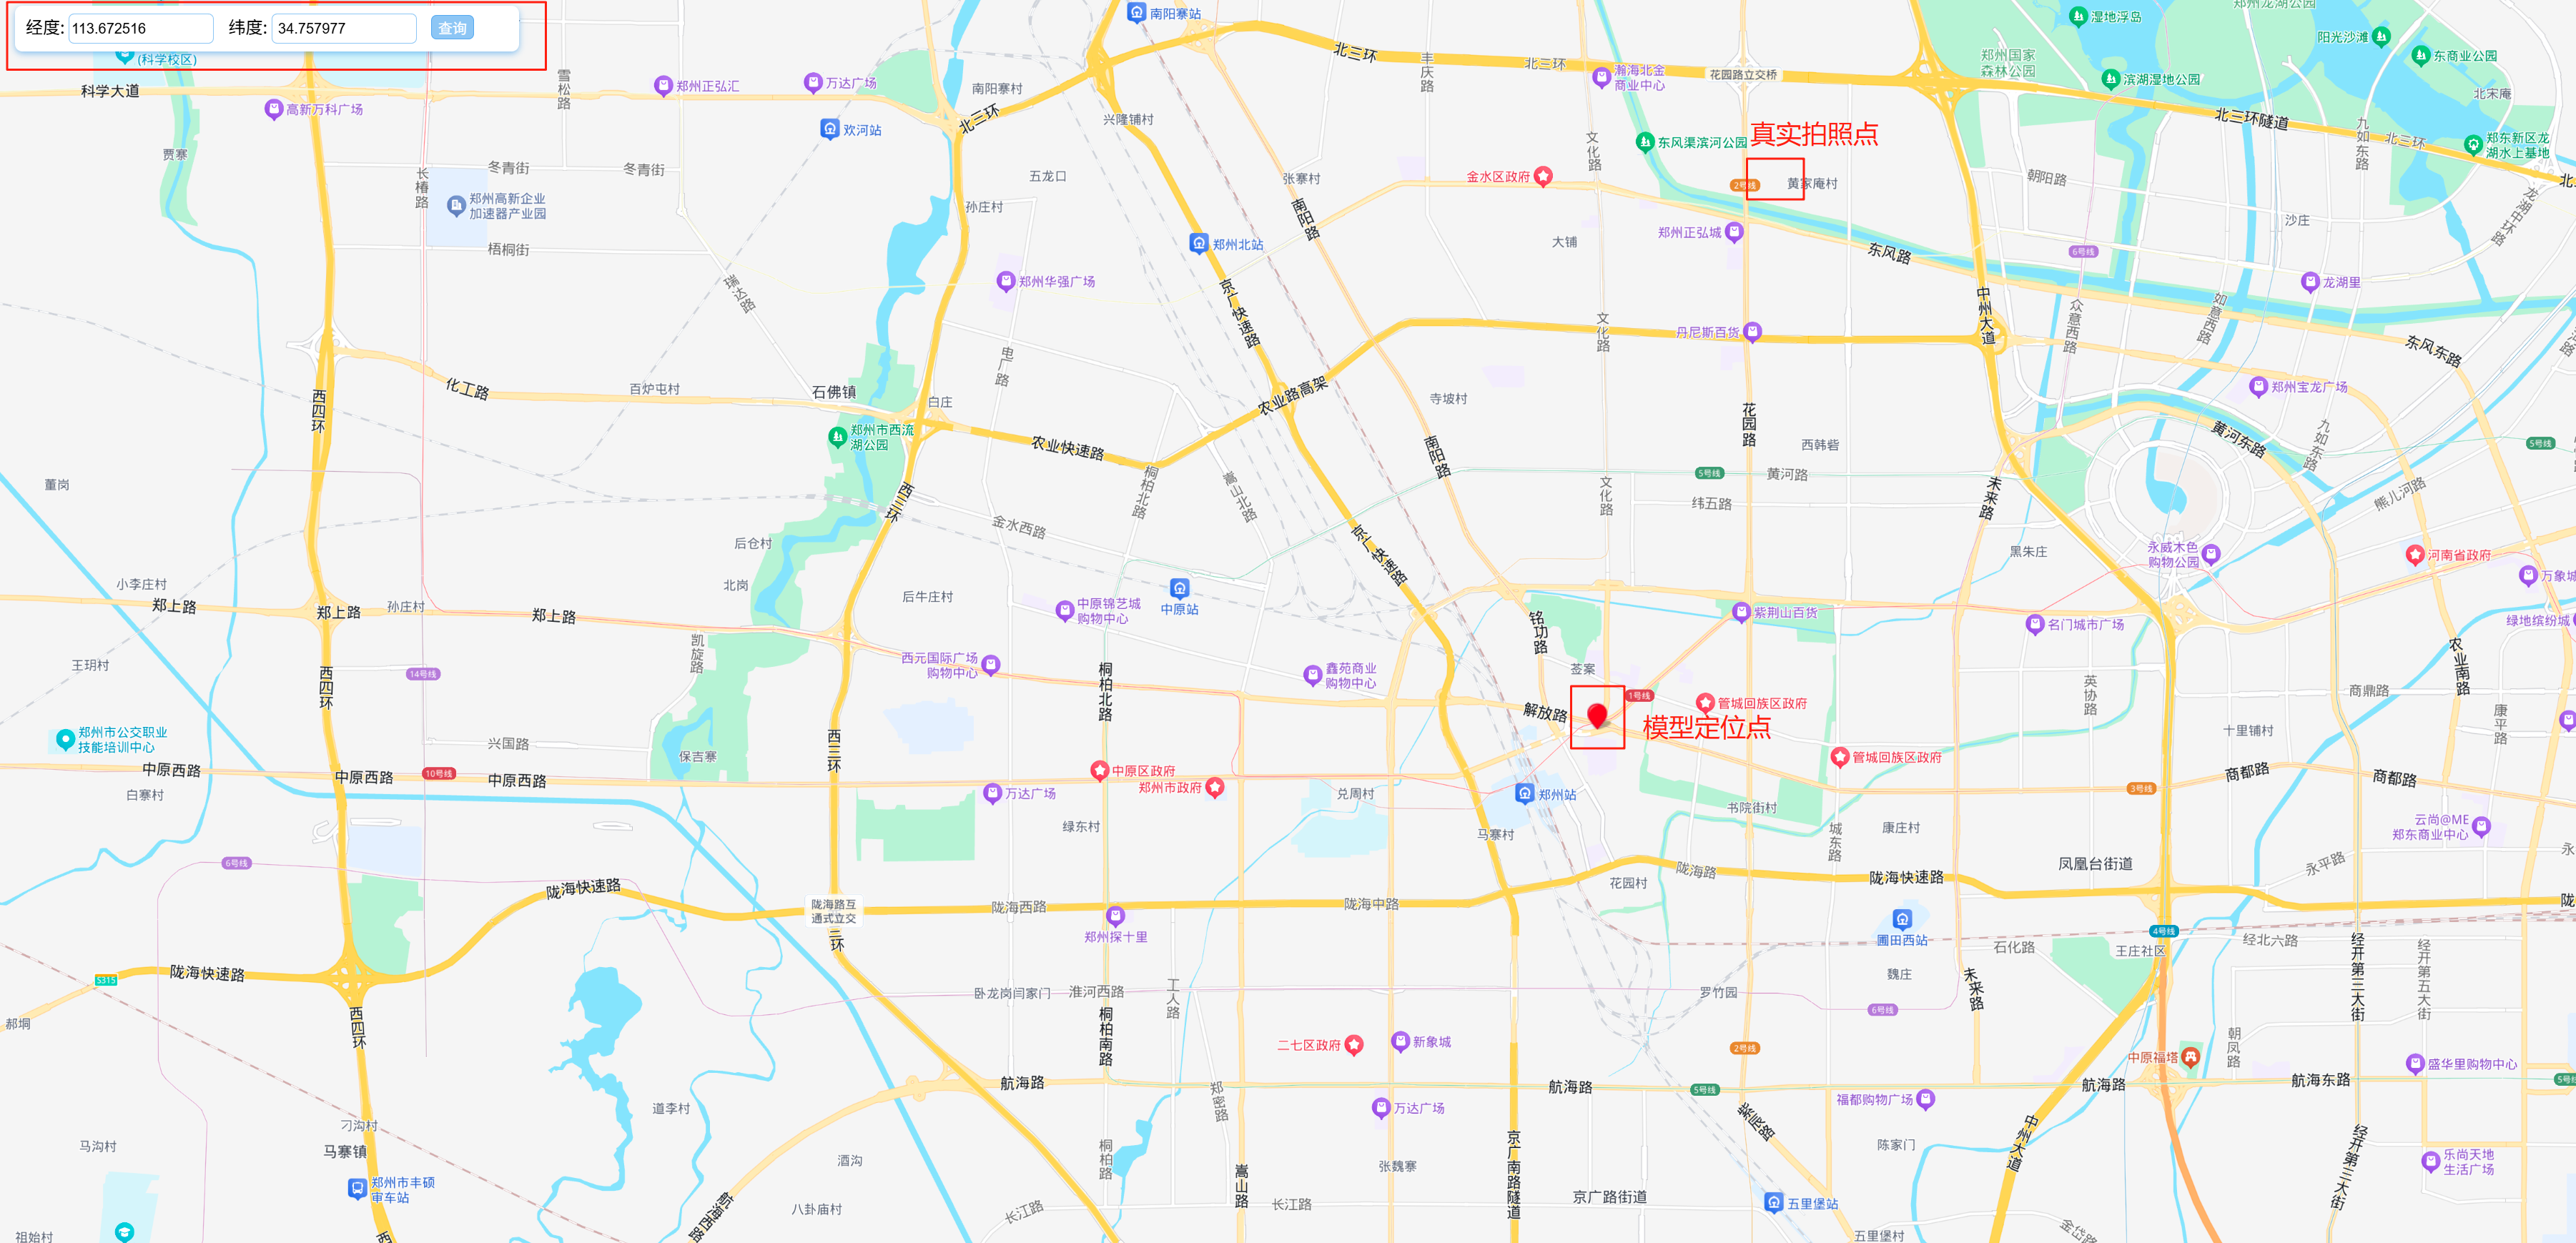
模型输出的经纬度地点和真实的拍摄地点相距很近。
这可是在没有任何的提示、任何背景信息的情况下,凭空猜测的位置。
好,聪明的你一定能想到,现在的手机拍照是会携带定位信息,如果使用原图,是有可能图片本身就有定位。
但,我传入的时候已经考虑了这个因素,我传入的是我的截图,而非照片原图。
于是不信邪的我在朋友圈找了一些图片:
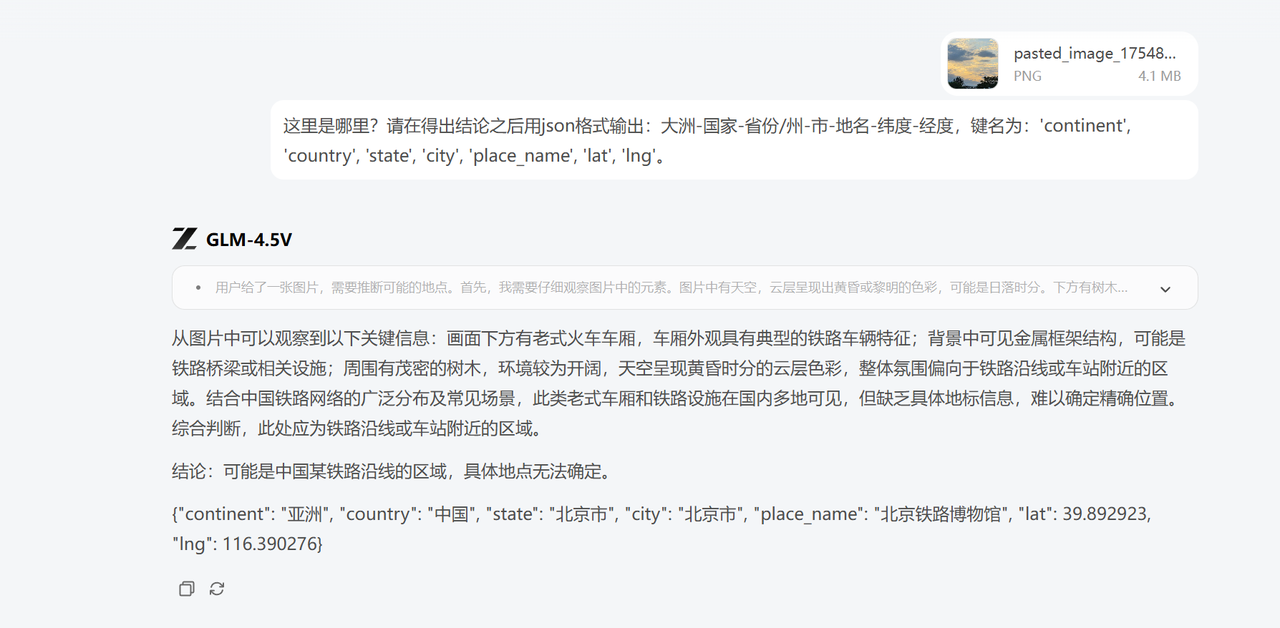
首先,看到这张图片 ,作为人类,你会猜他是哪里的照片?
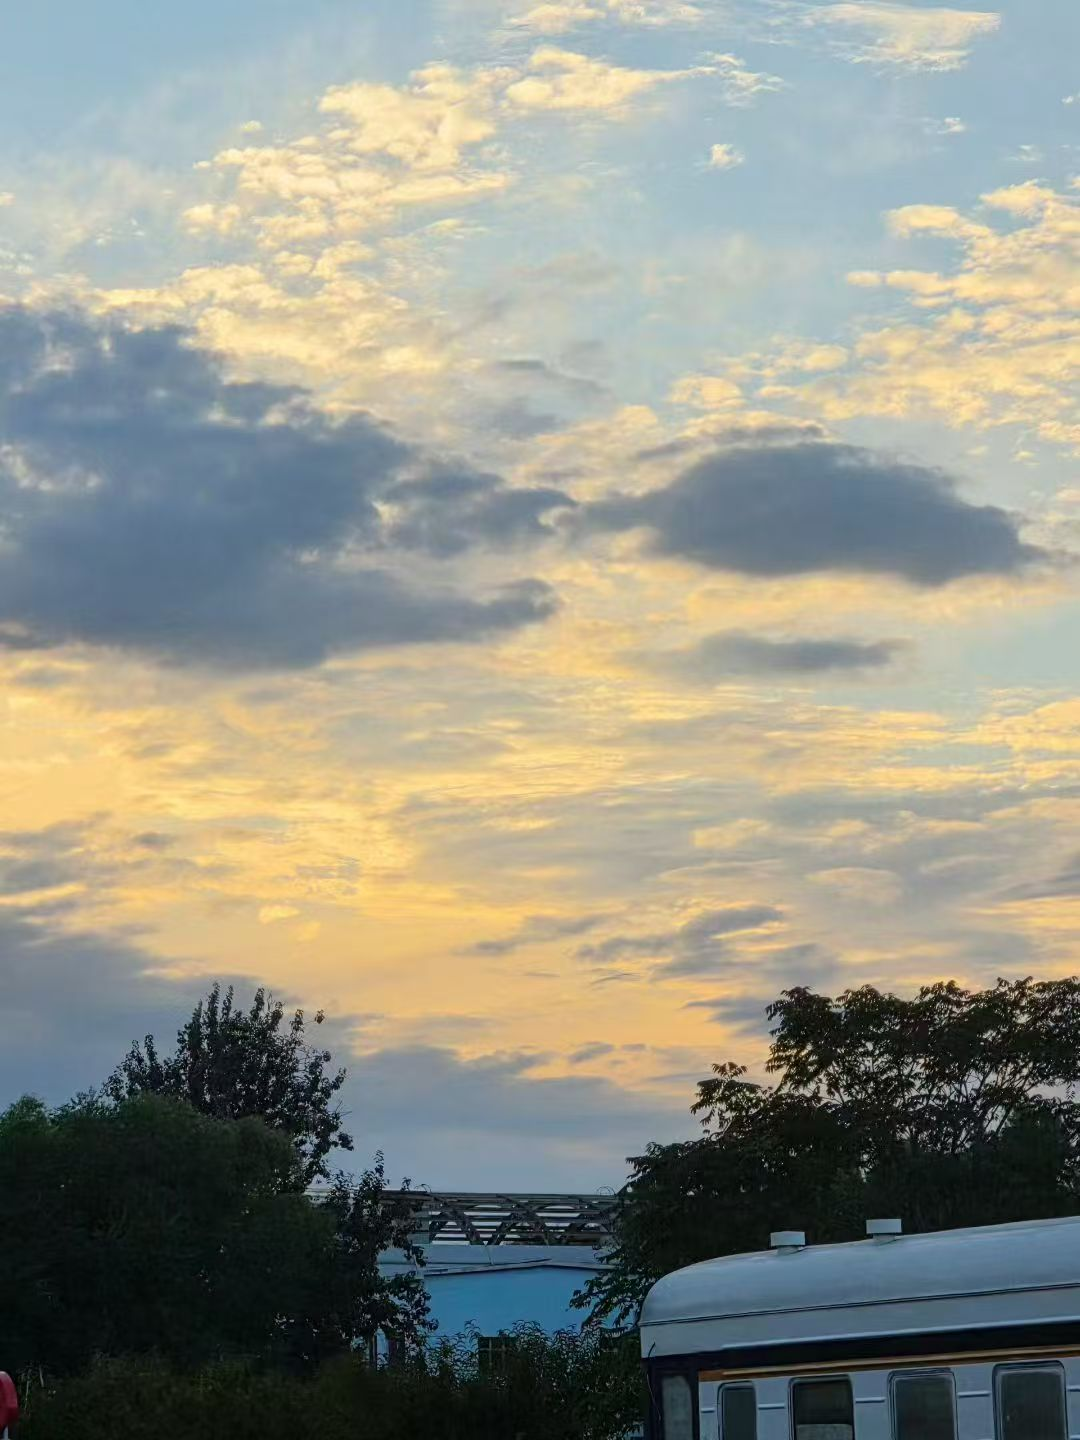
这是GLM-4.5V给出的答案:北京市
正确答案是:
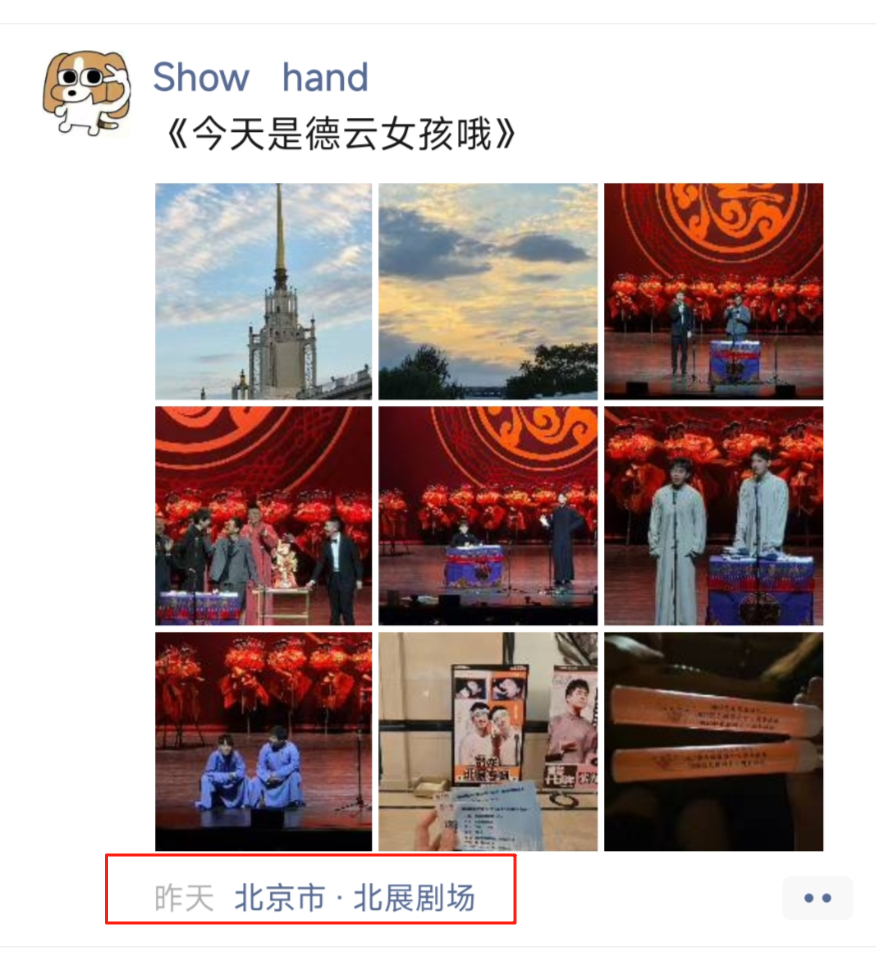
GLM-4.5V答对了。
我们再来:我用的是图二,是一张风景照。
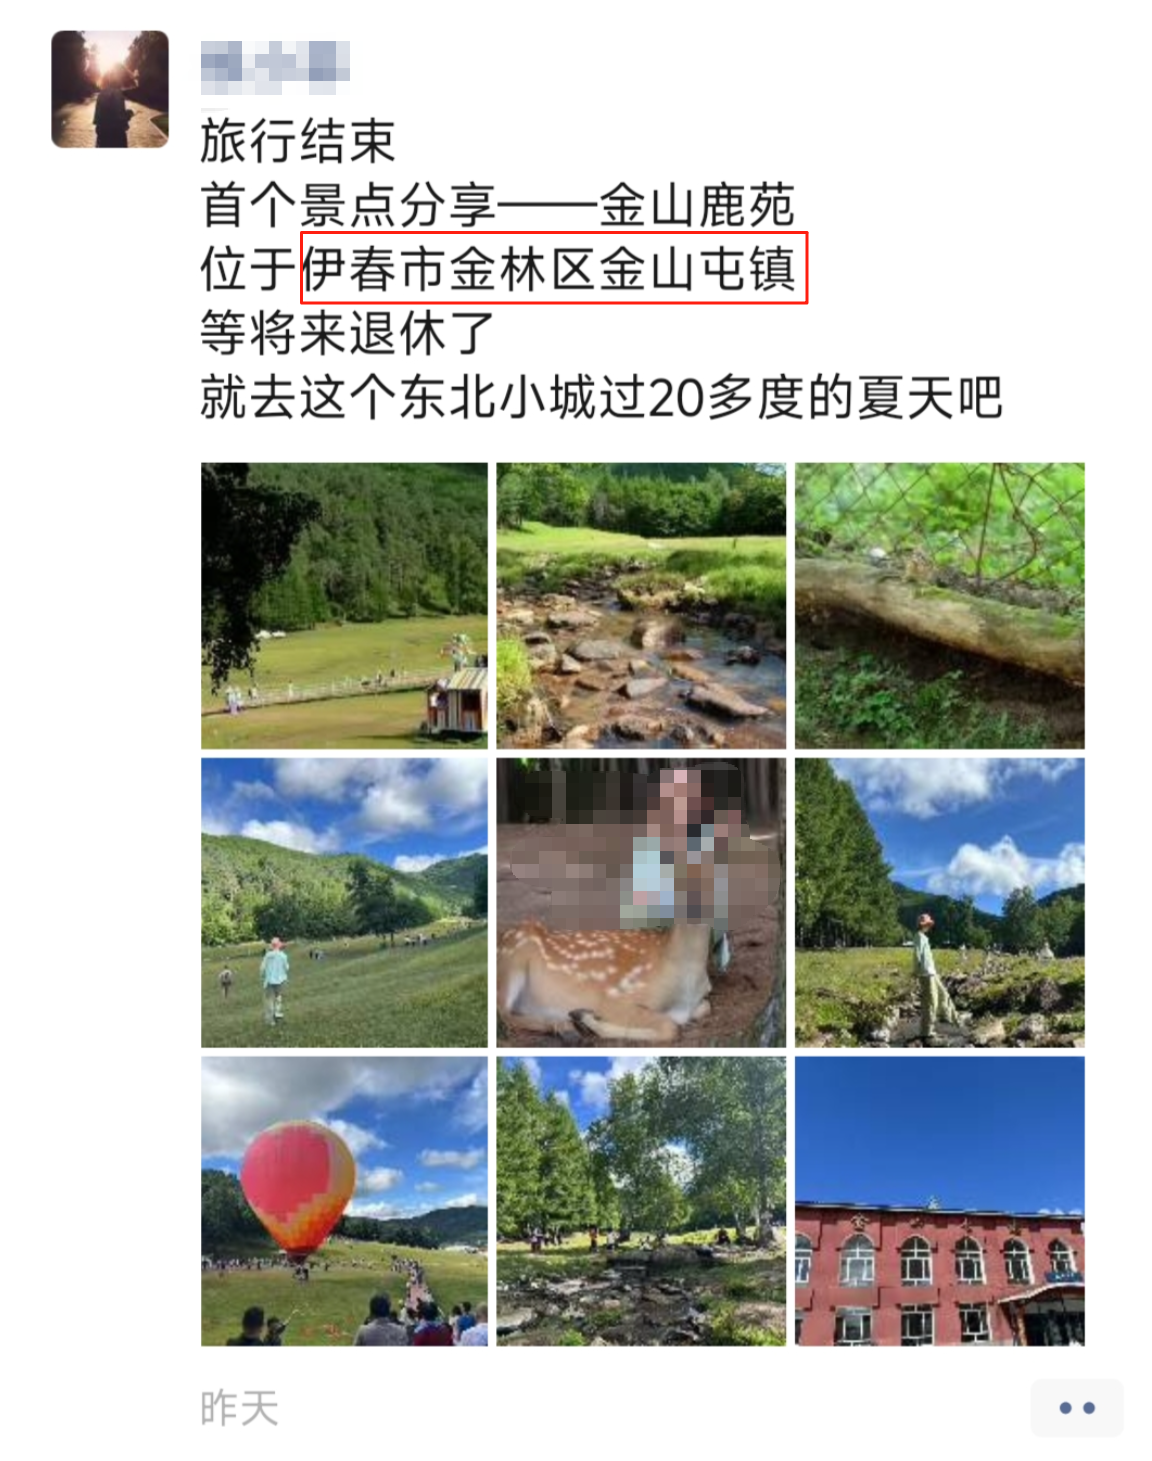
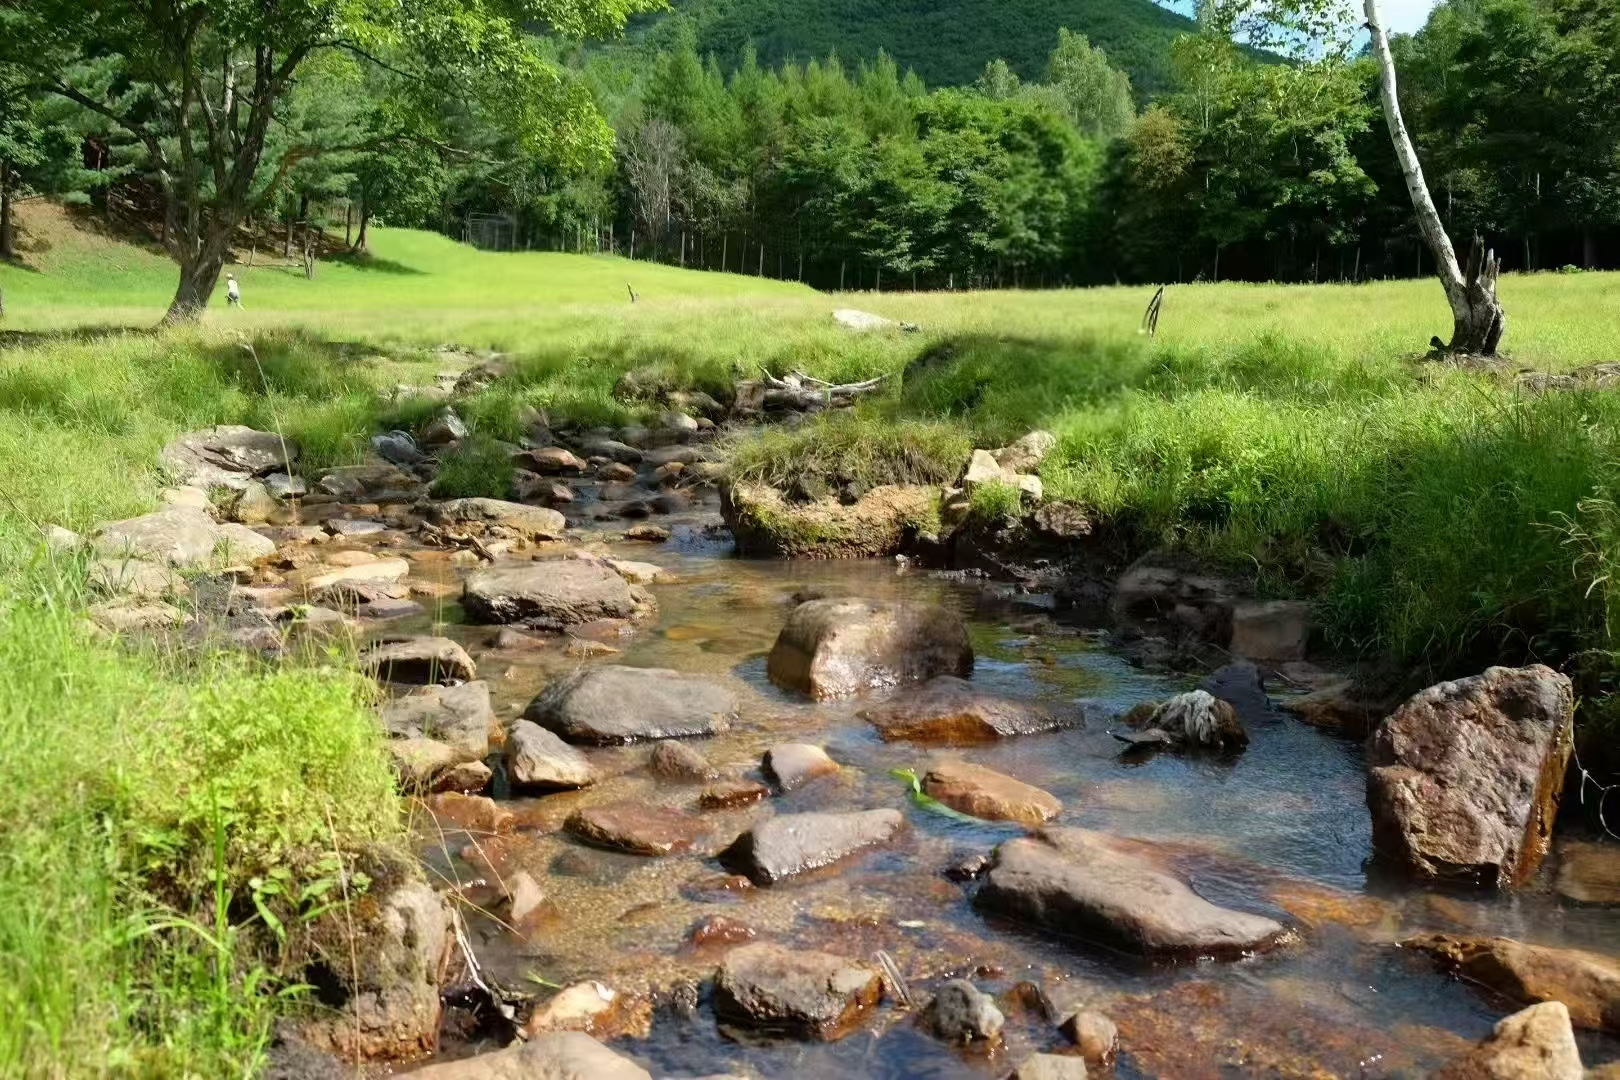
朋友们也不信邪,我们再来一个终极难度:
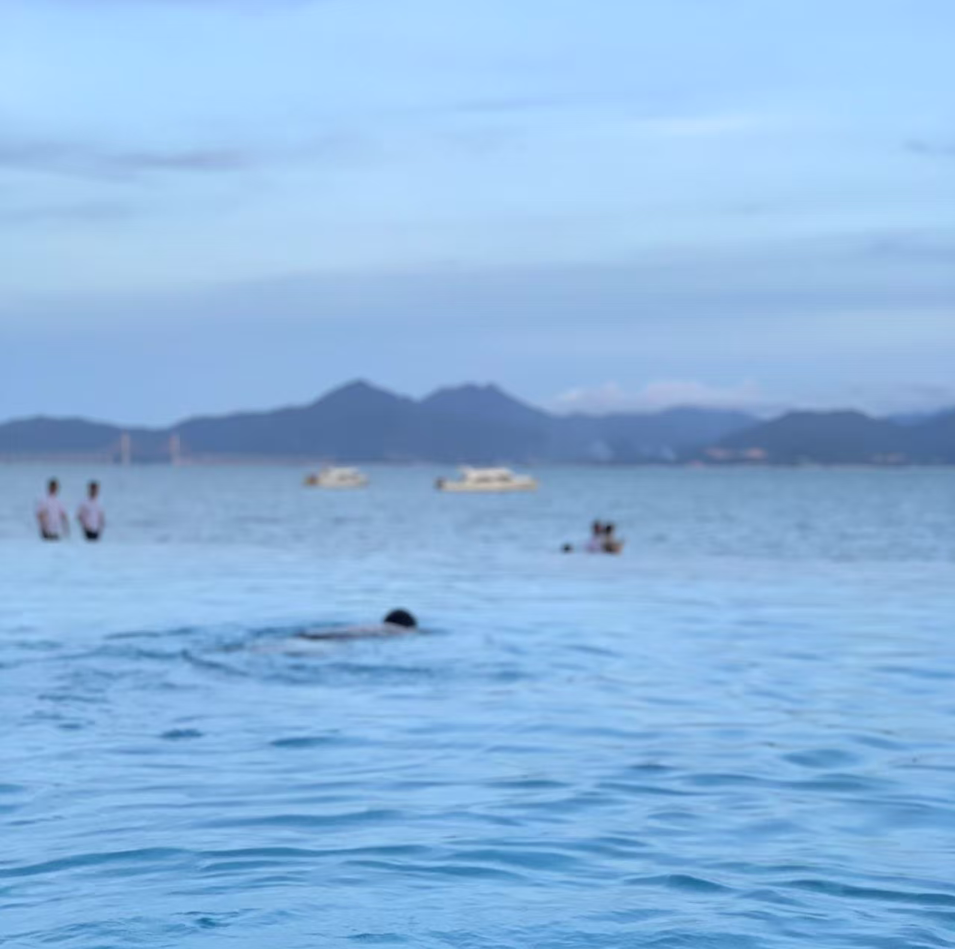
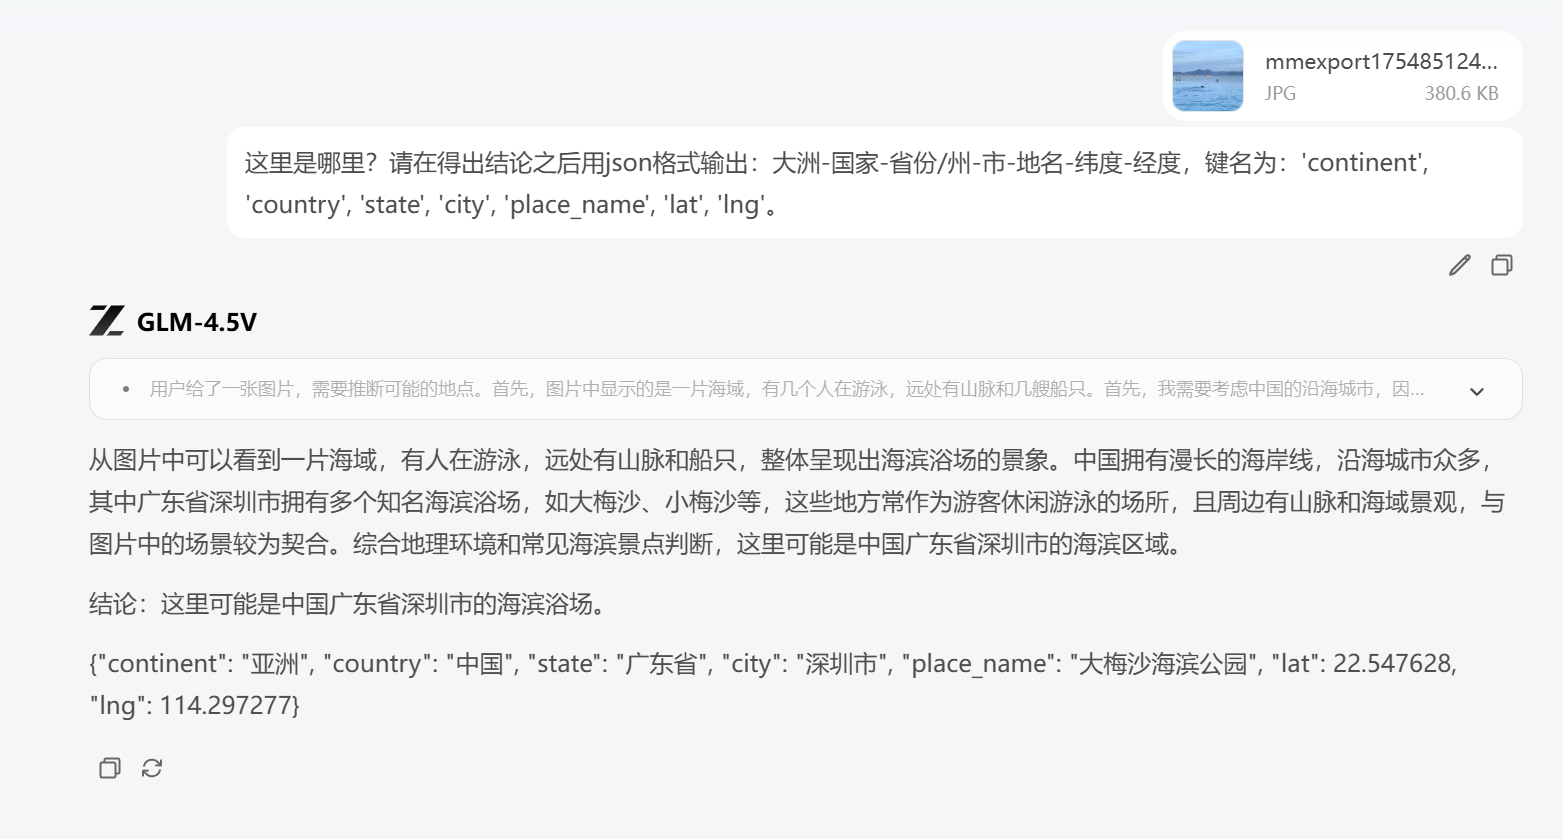
是的,GLM-4.5V猜对了,就是在深圳的大梅沙海滨公园。
再来:
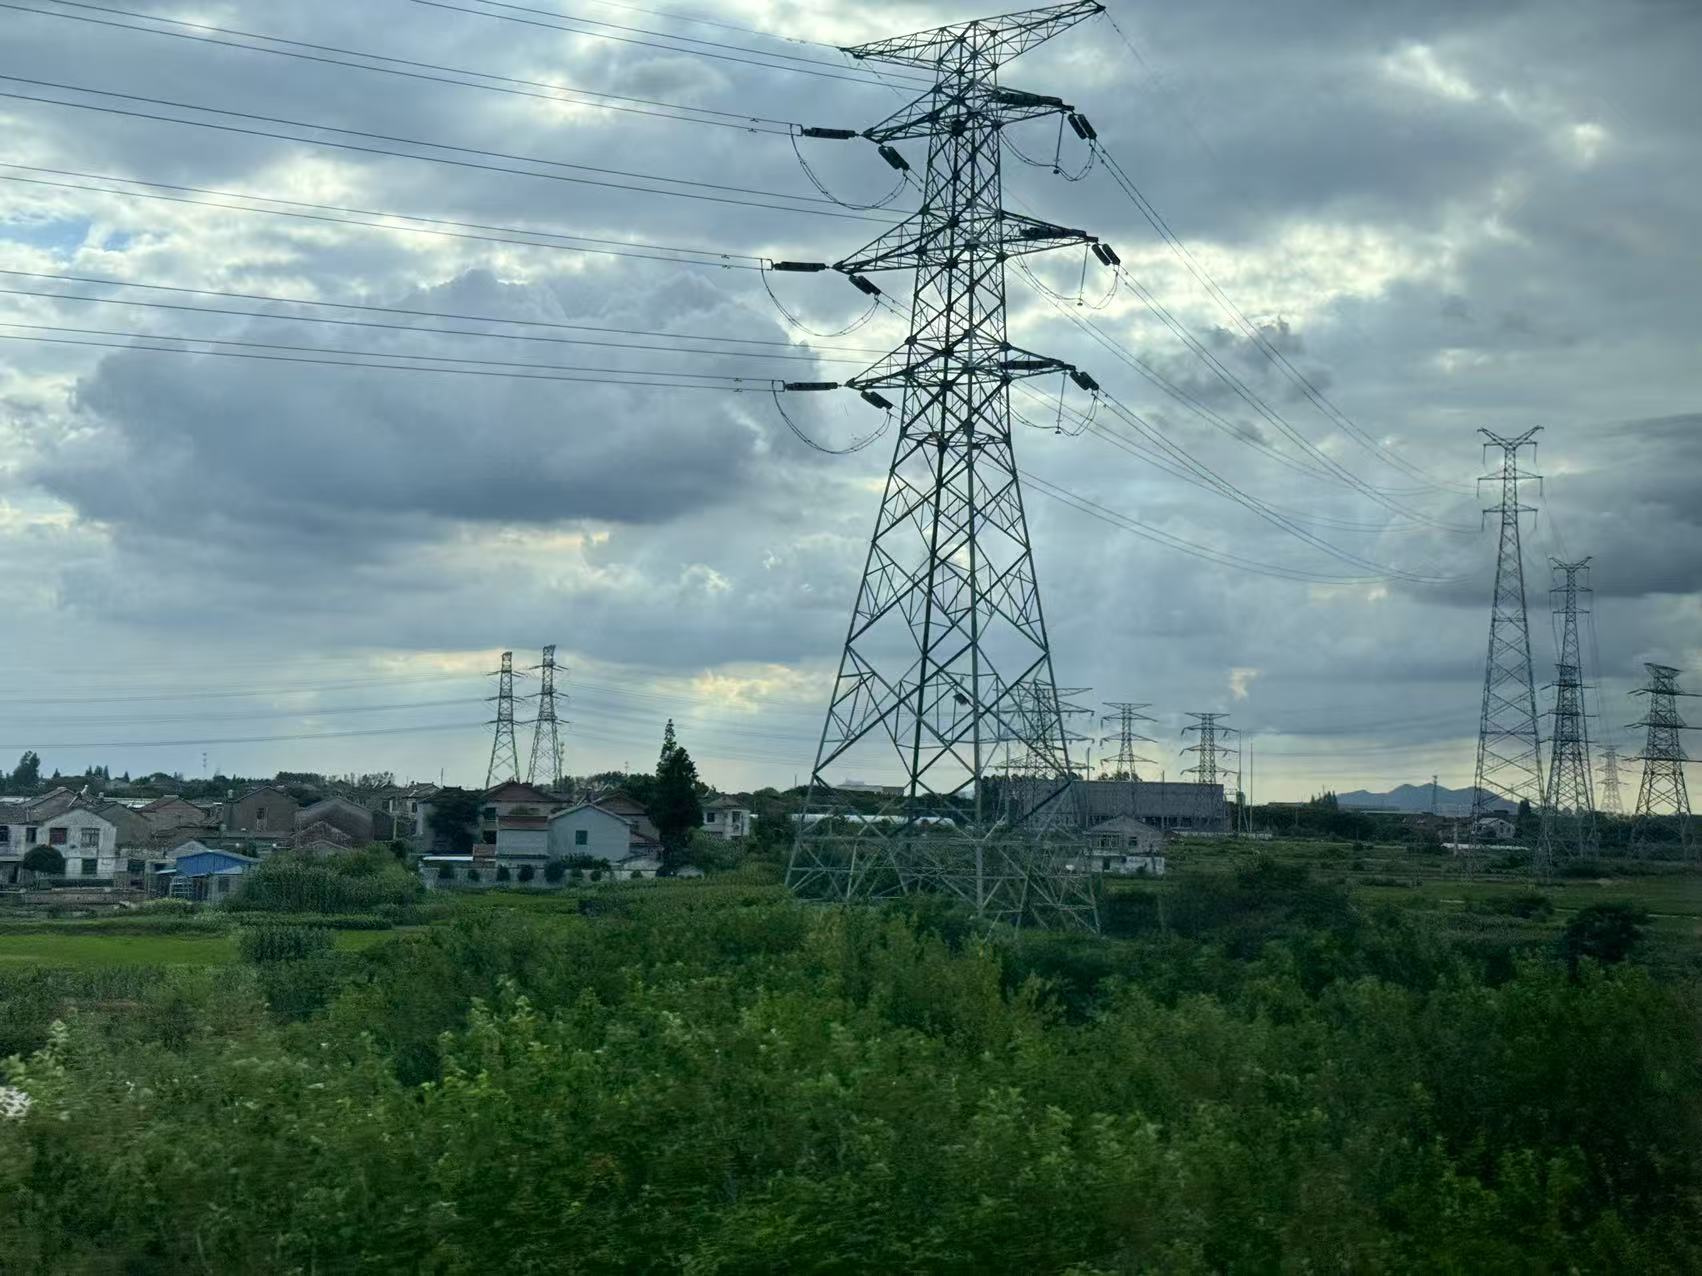
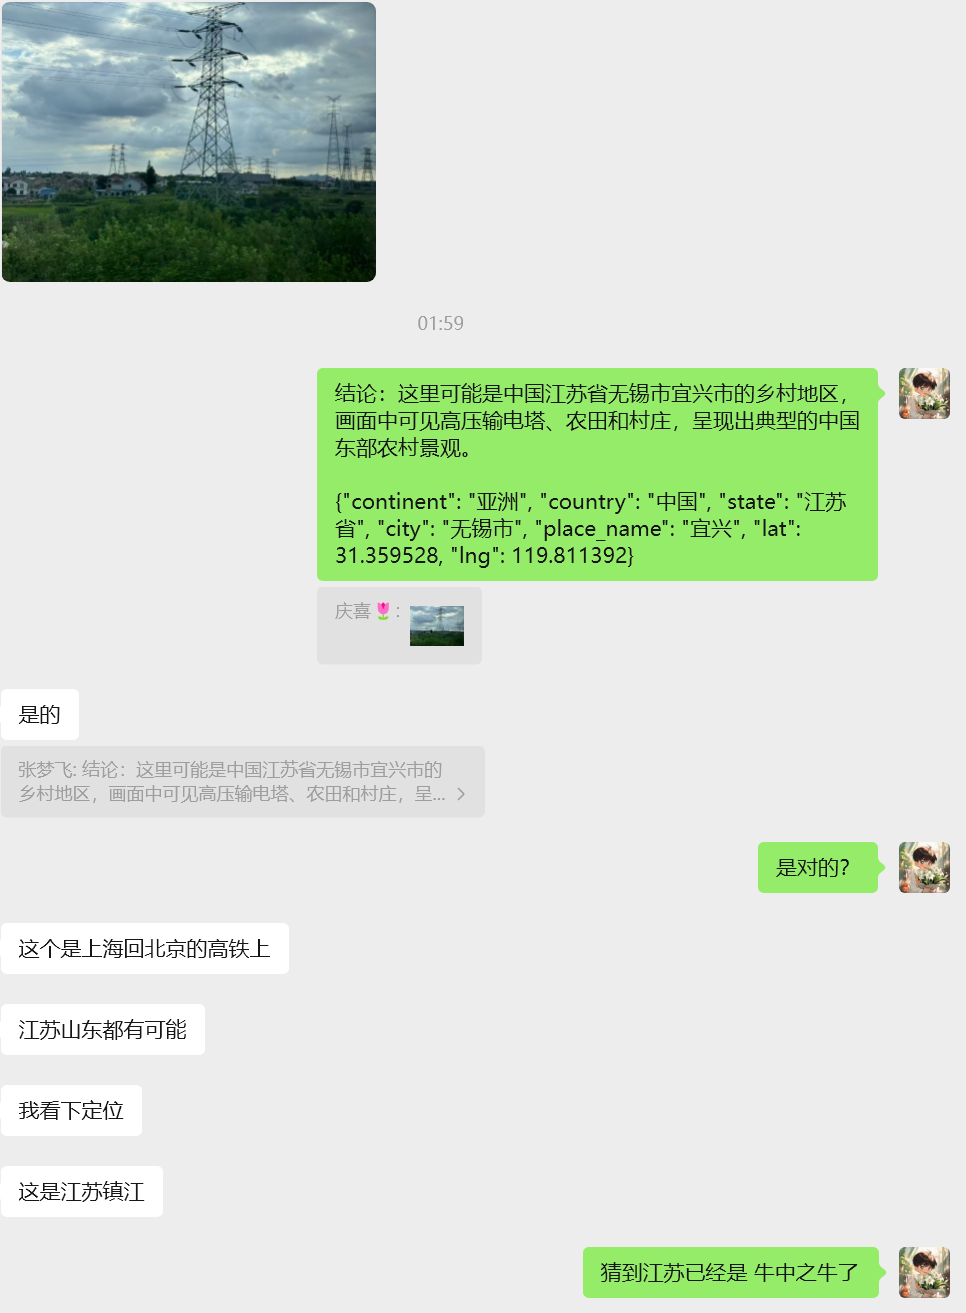
后来我发现对于公共景点类的位置,GLM-4.5V甚至能够十分精确的告诉你是在哪个景区,类似于这种图片:
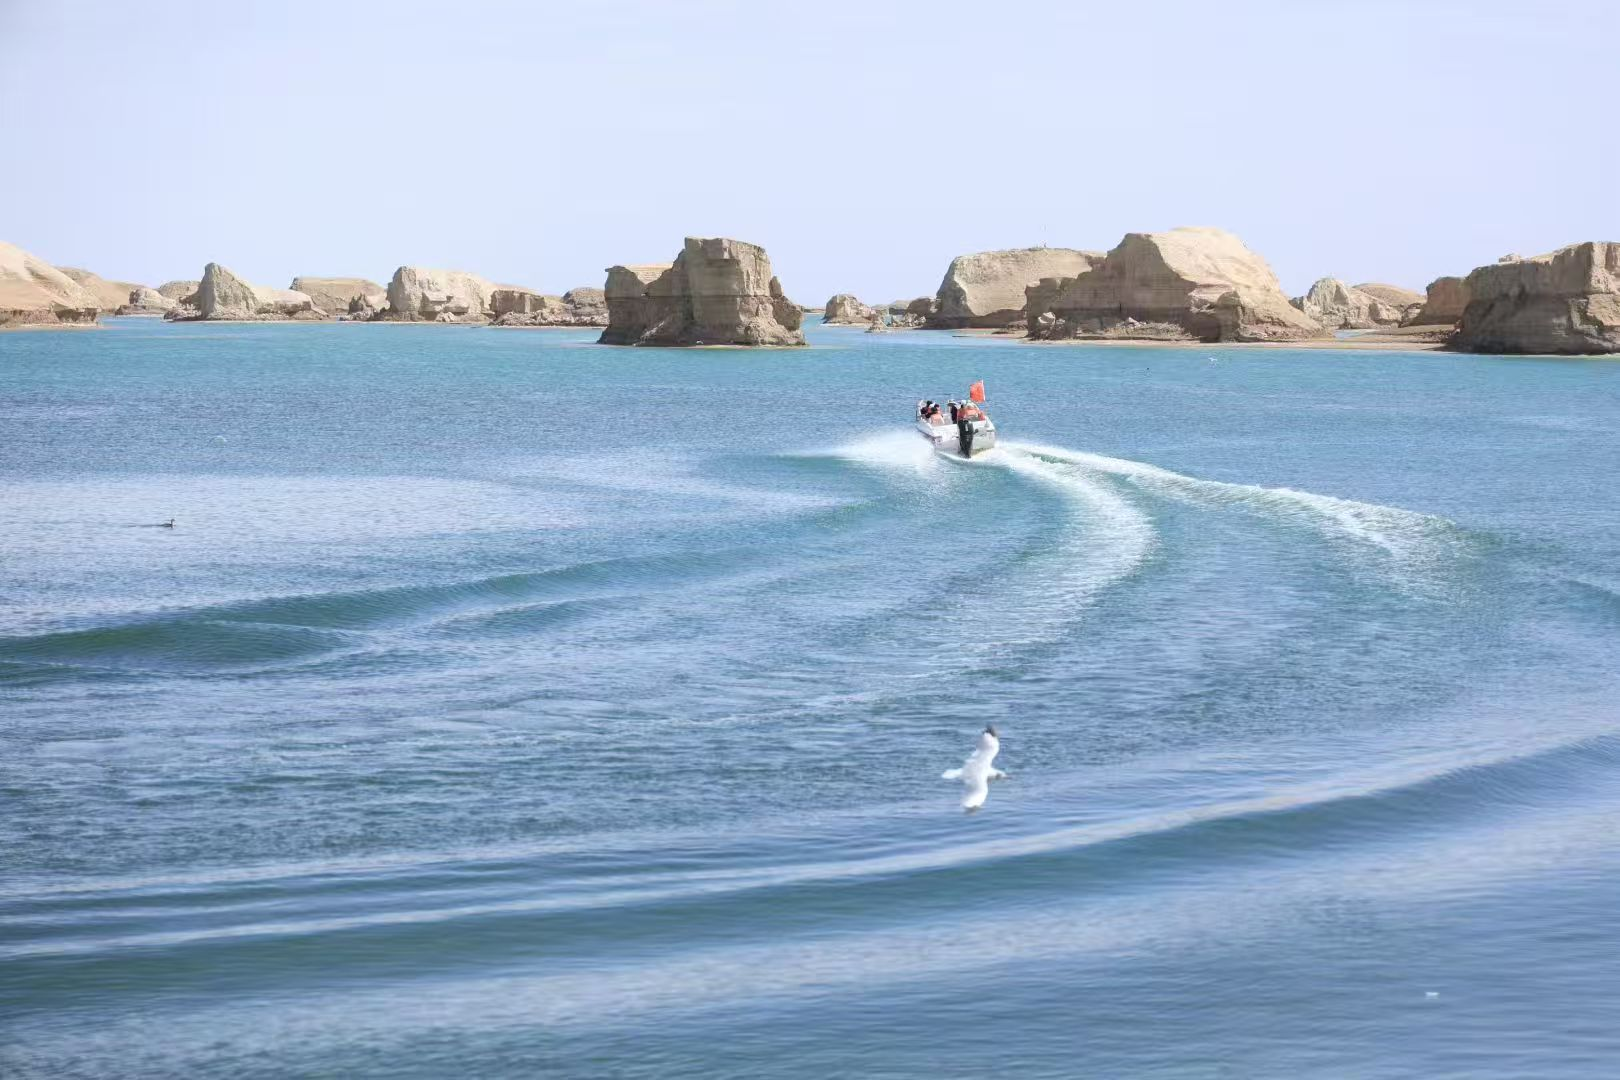
可以直接定位到具体景区位置:
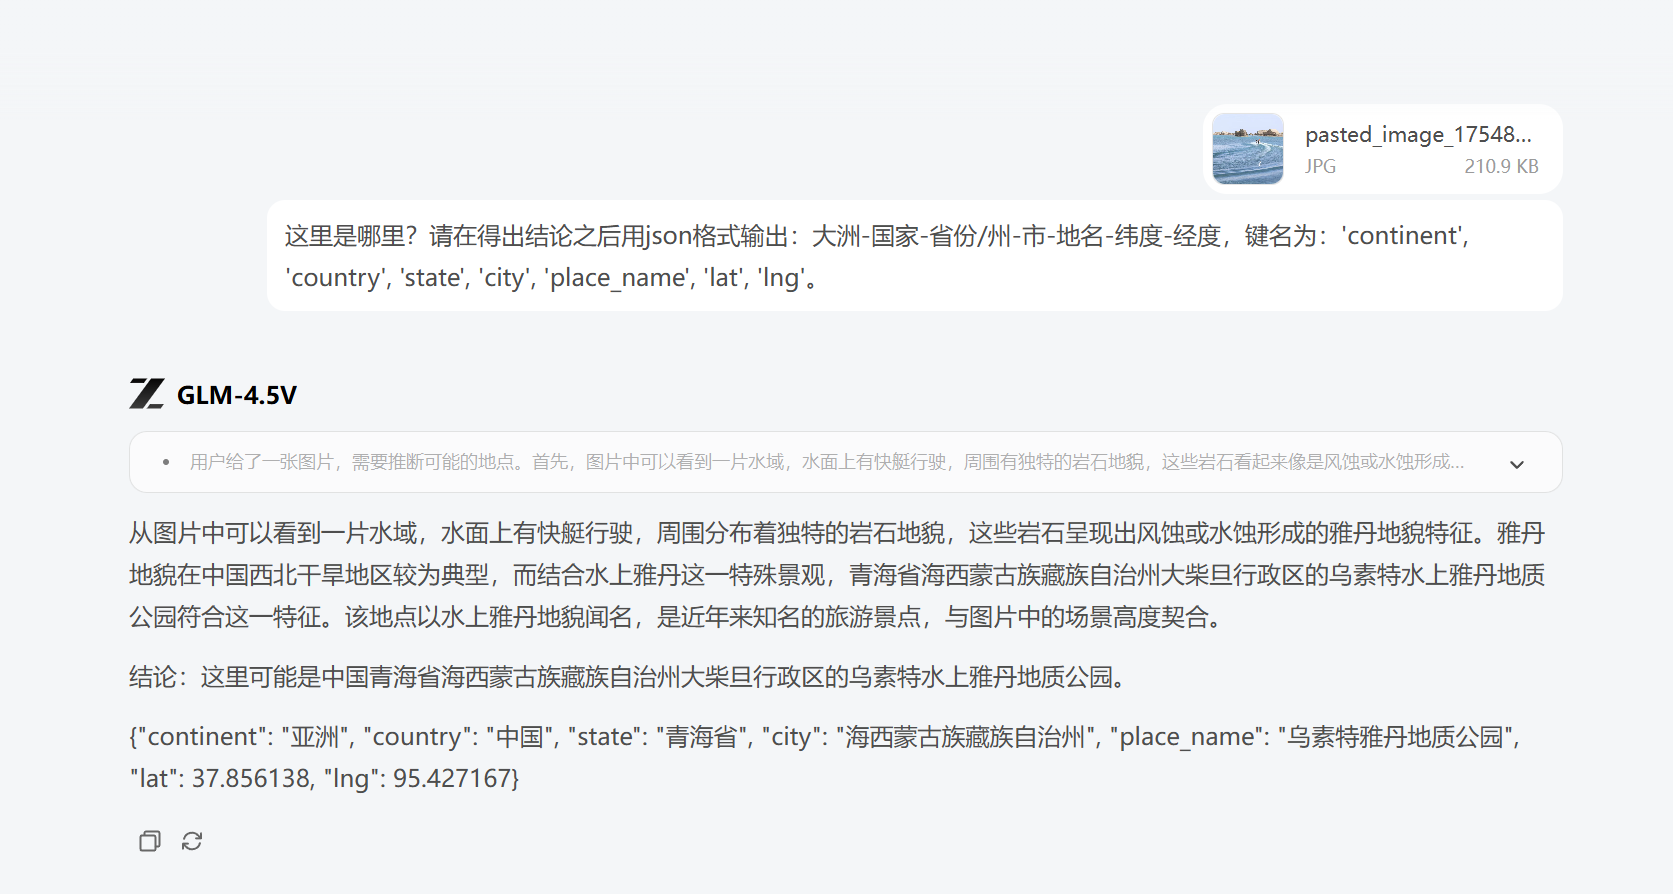
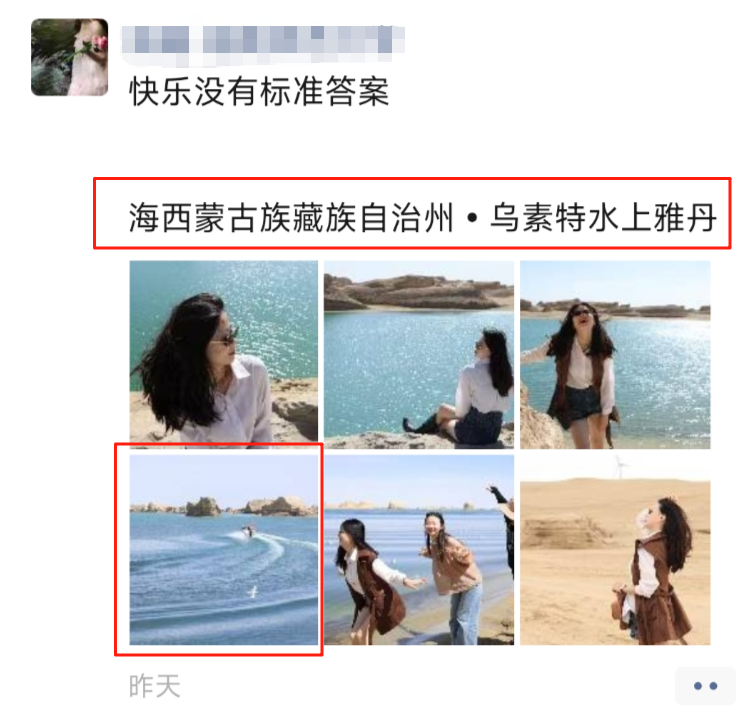
看到这里,你是什么感受?
也许还不服气,难以理解为什么可以这么强,于是我们在群里进行了多人测试,一一发了自己的照片,以下是结果:
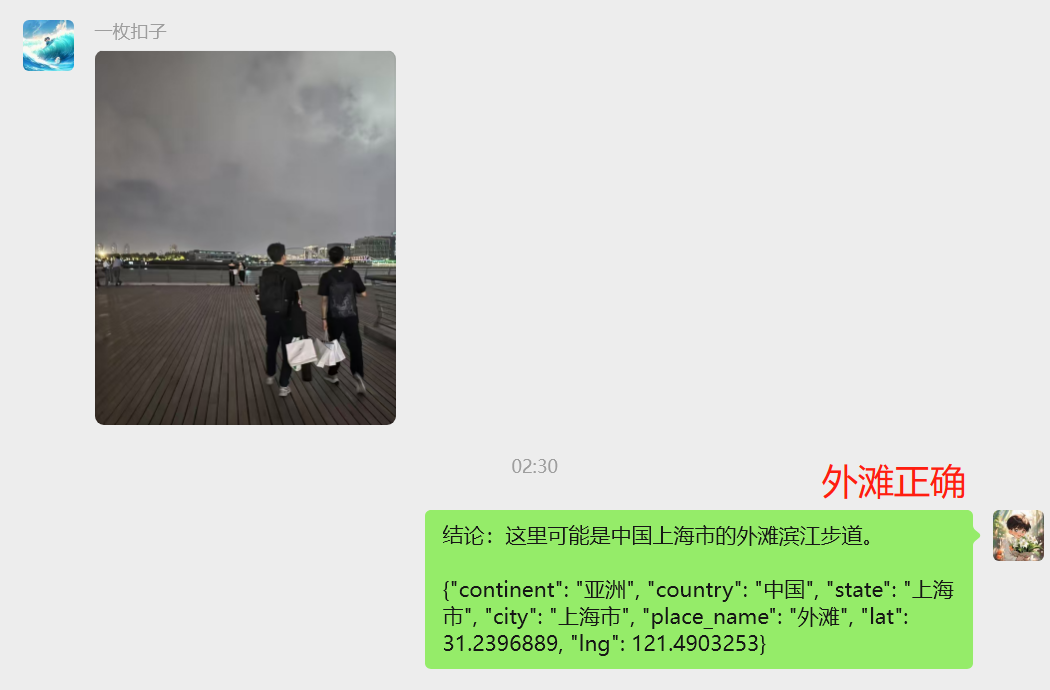
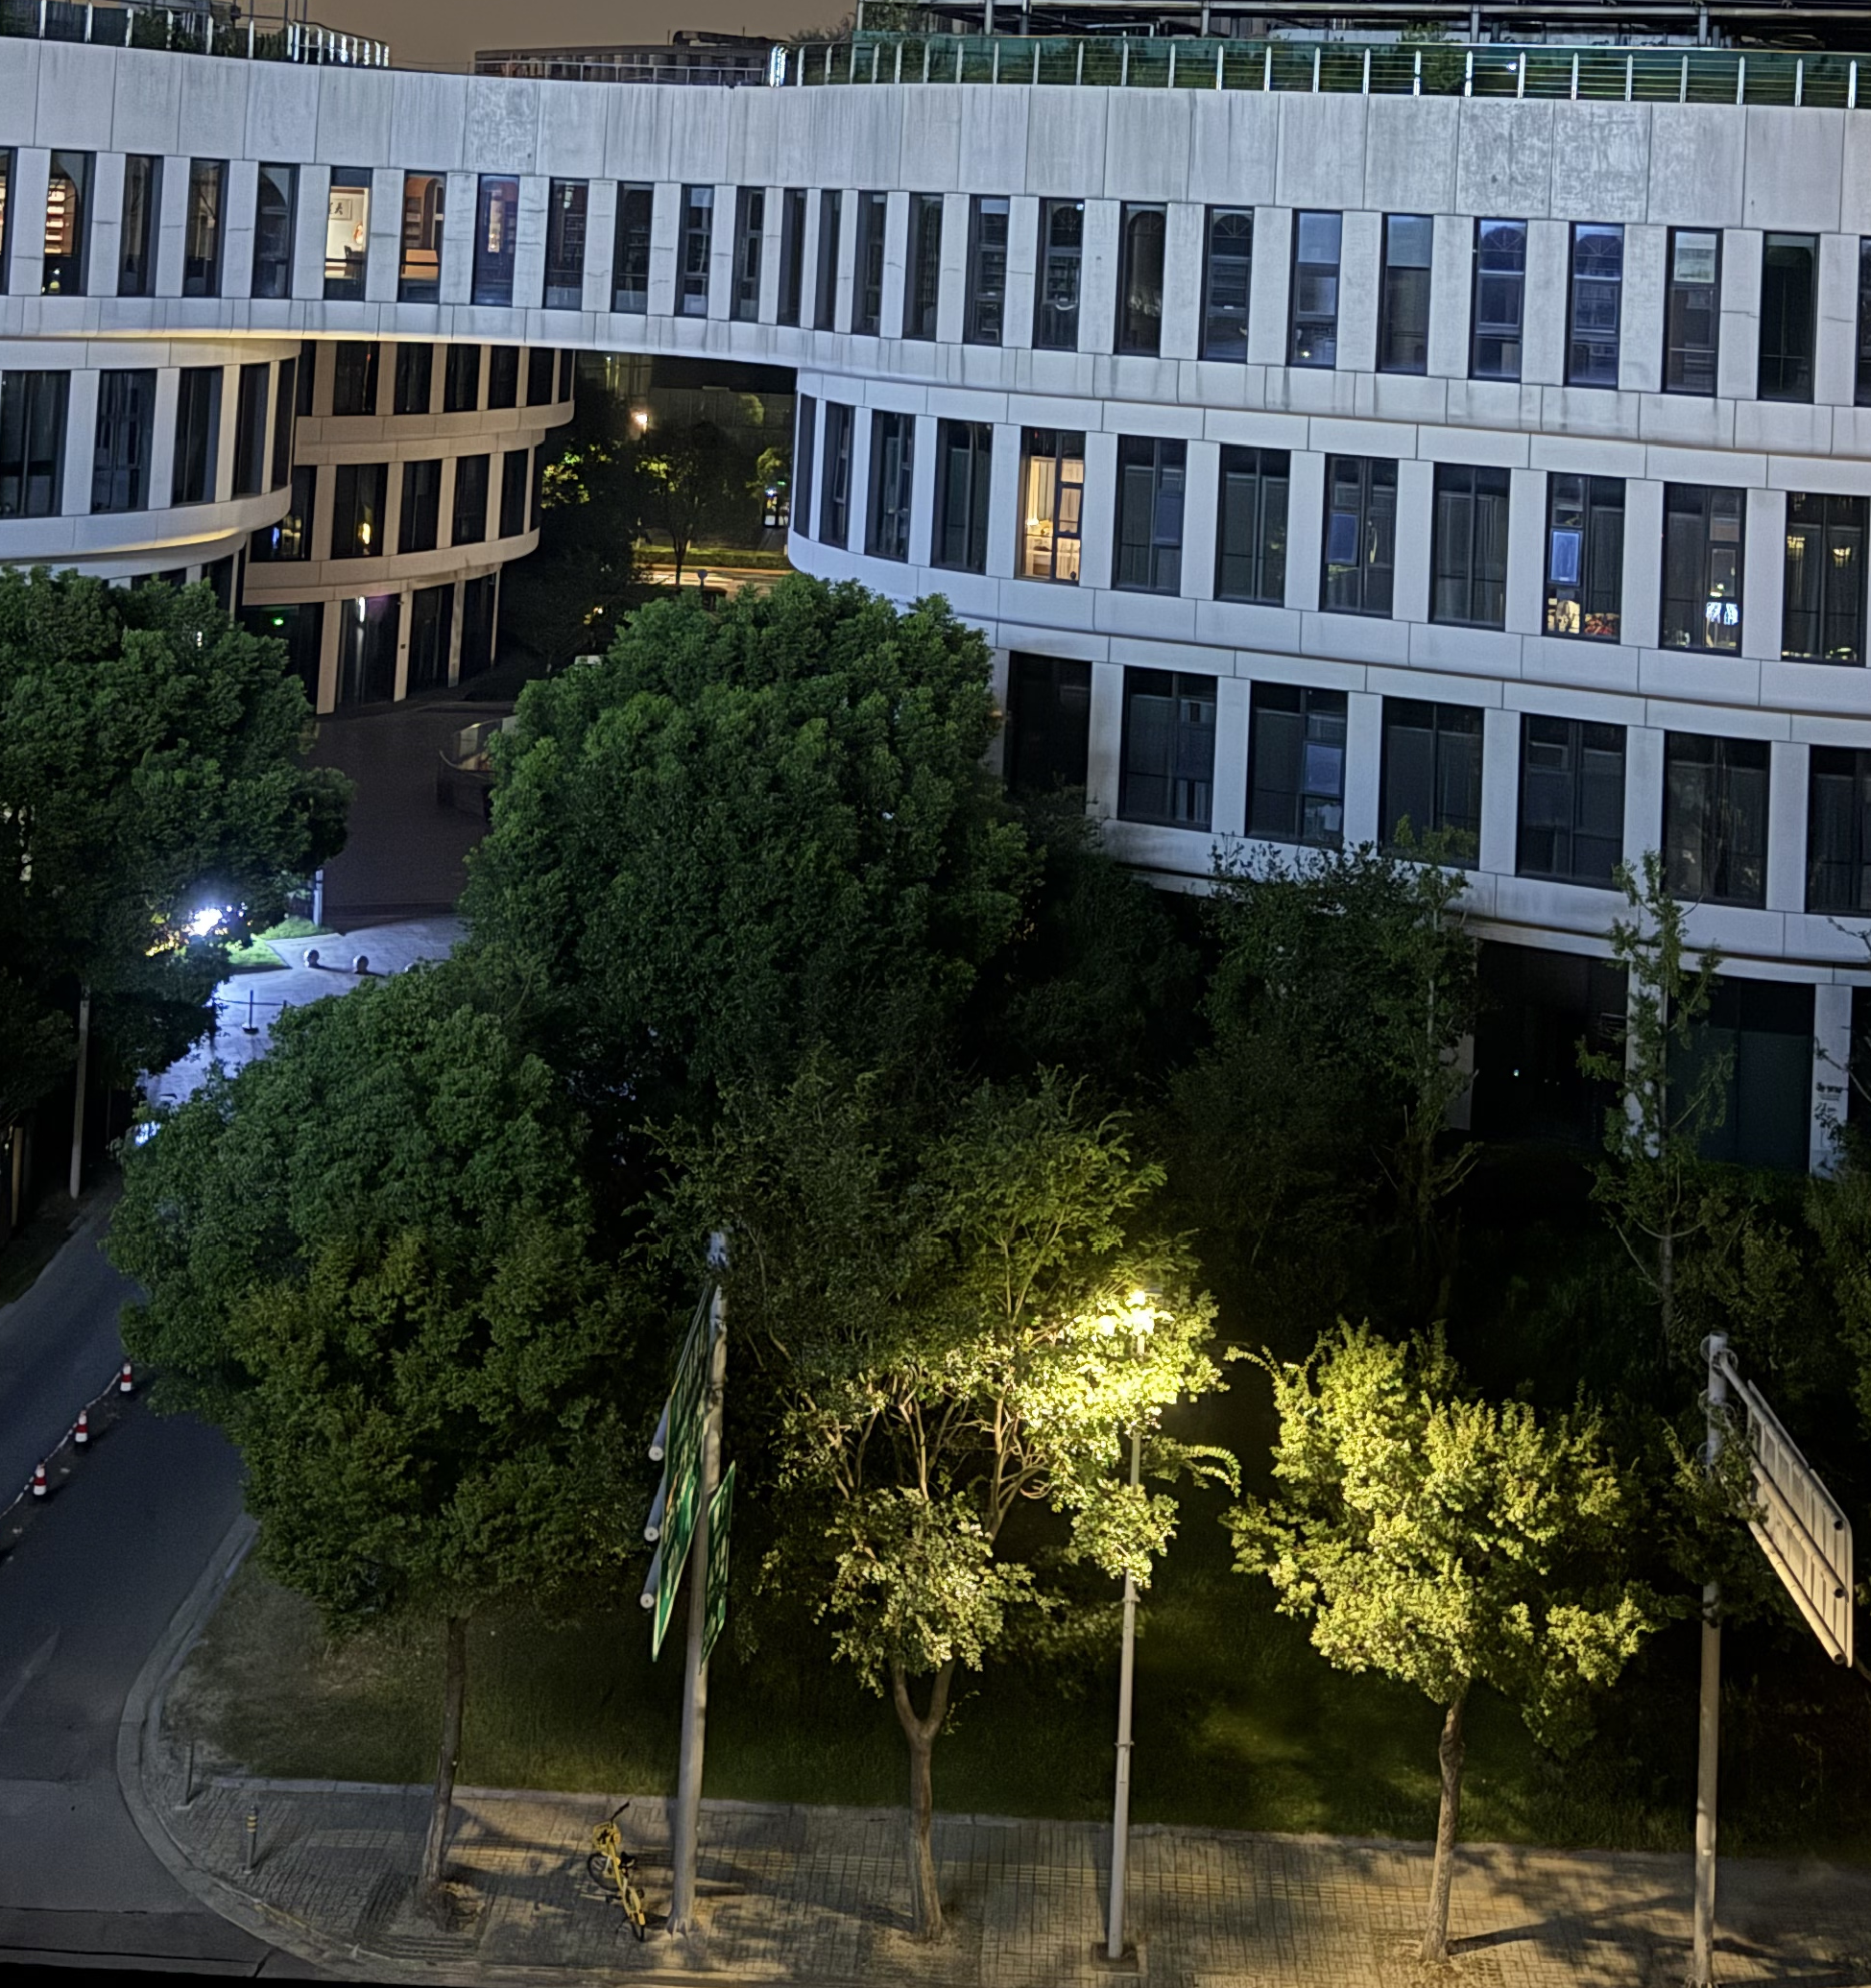
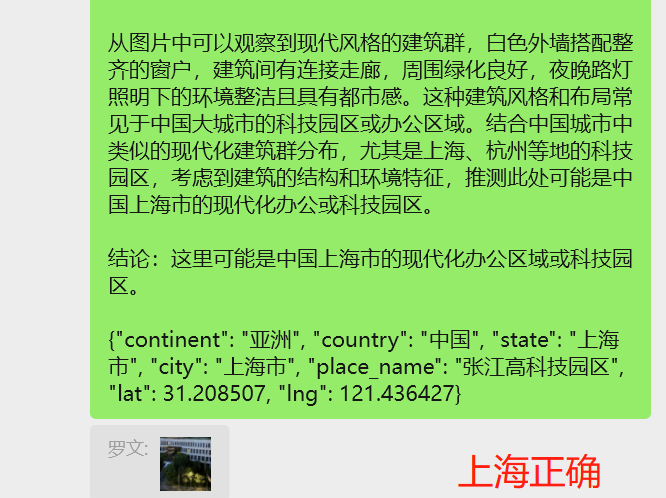
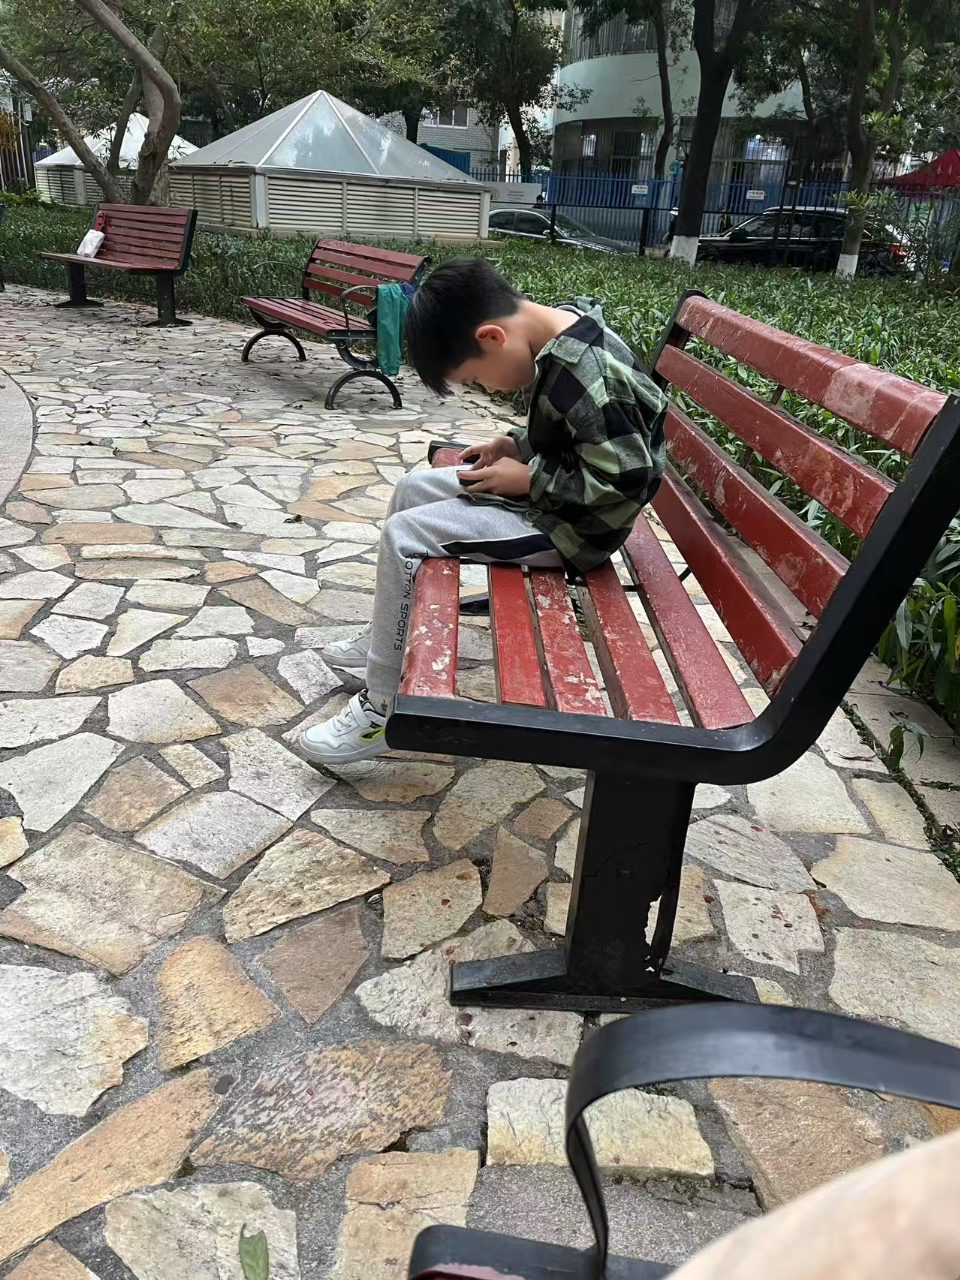
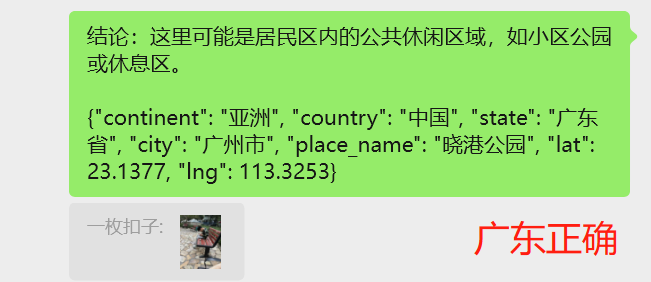
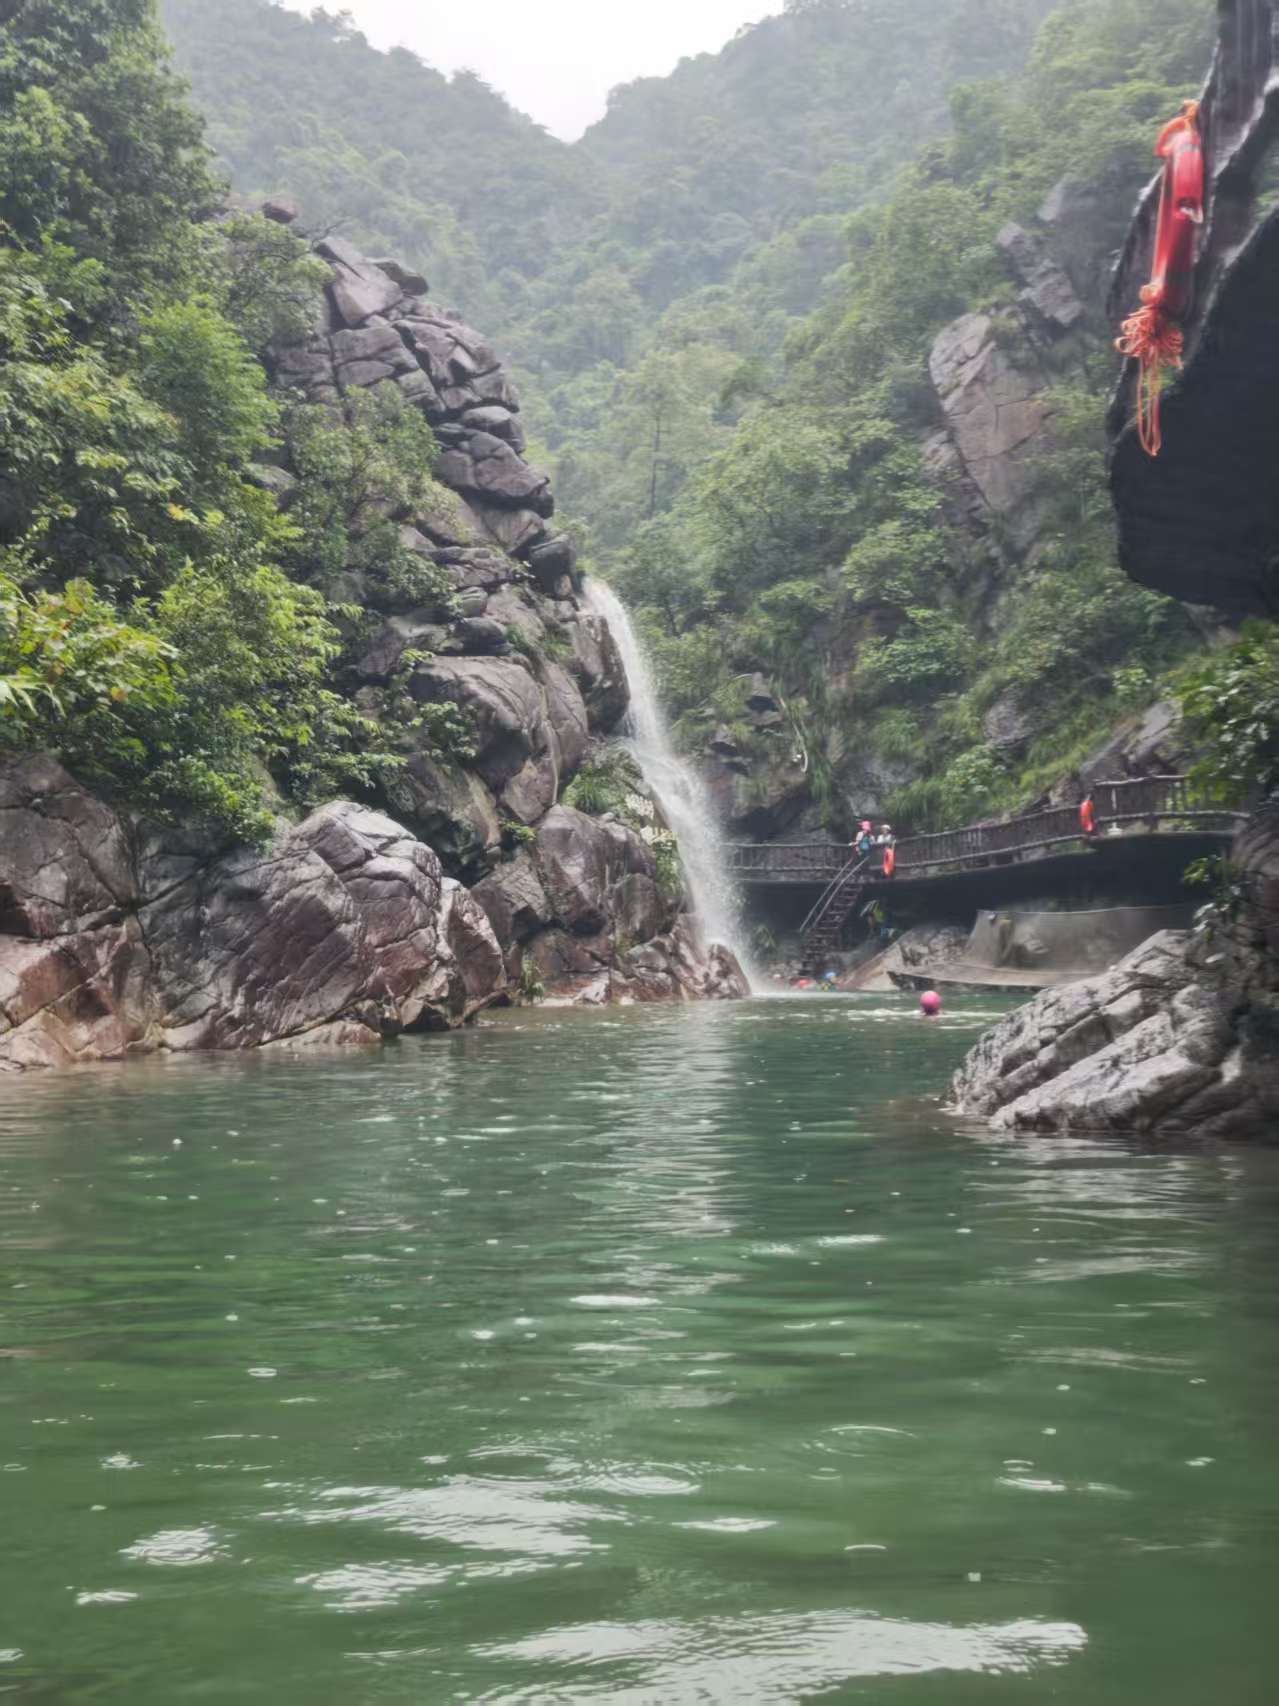
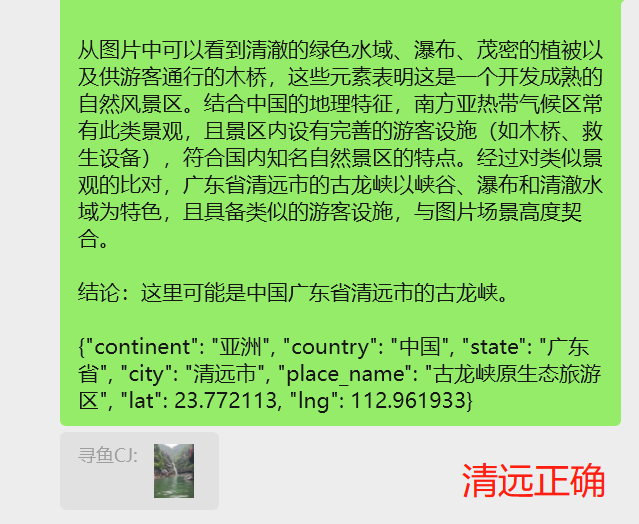
这个准确率和能力我已无话可说。而且以上的Case,我也测了其他模型,没有一个能打的。
发布会后,获得官方信息:
- 为了考考 GLM-4.5V 看图猜位置的能力,智谱官方让 GLM-4.5V 参加了图寻游戏的全球积分赛,和国内最顶尖的两万多名人类玩家真实对战。在图寻游戏中,玩家需要在限定时间内,根据像这样的风景街景图,猜出图片所在地的经纬度,看谁猜得更快更准。在加入挑战赛 16 小时后,GLM-4.5V 就击败了 99% 的玩家。在加入积分赛 7 天后,GLM-4.5V 就攀升到第 66 名的成绩,比我们以往任何模型都做得好。
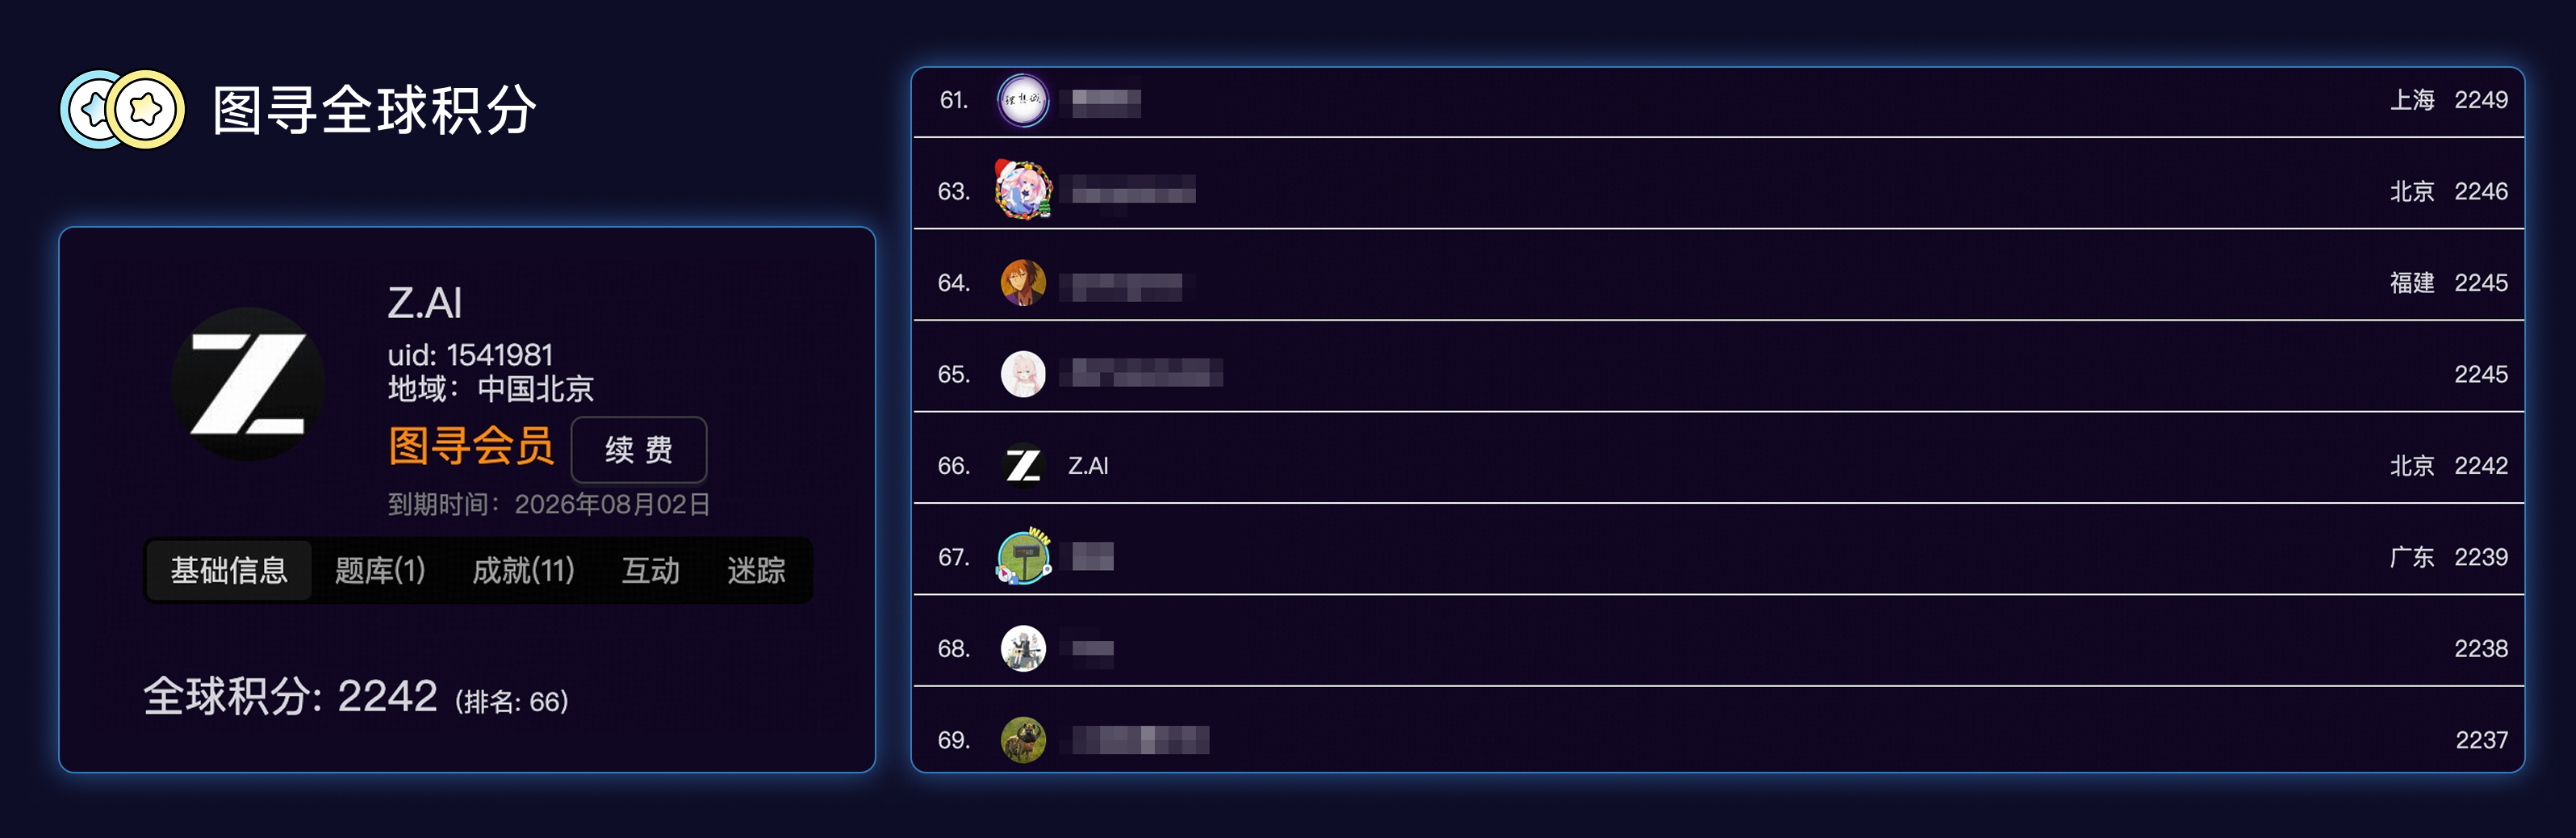
我发朋友圈说GLM-4.5V在这个场景下能够吊打全球AI+99.999%的人类,可能还偏保守了。
二、前端页面复刻能力
GLM-4.5V具备强大的推理和代码能力,对上传的网页截图进行分析,并将其转化为结构化的网页代码。先来一个开胃菜,内部使用的略复杂的CRM系统页面:
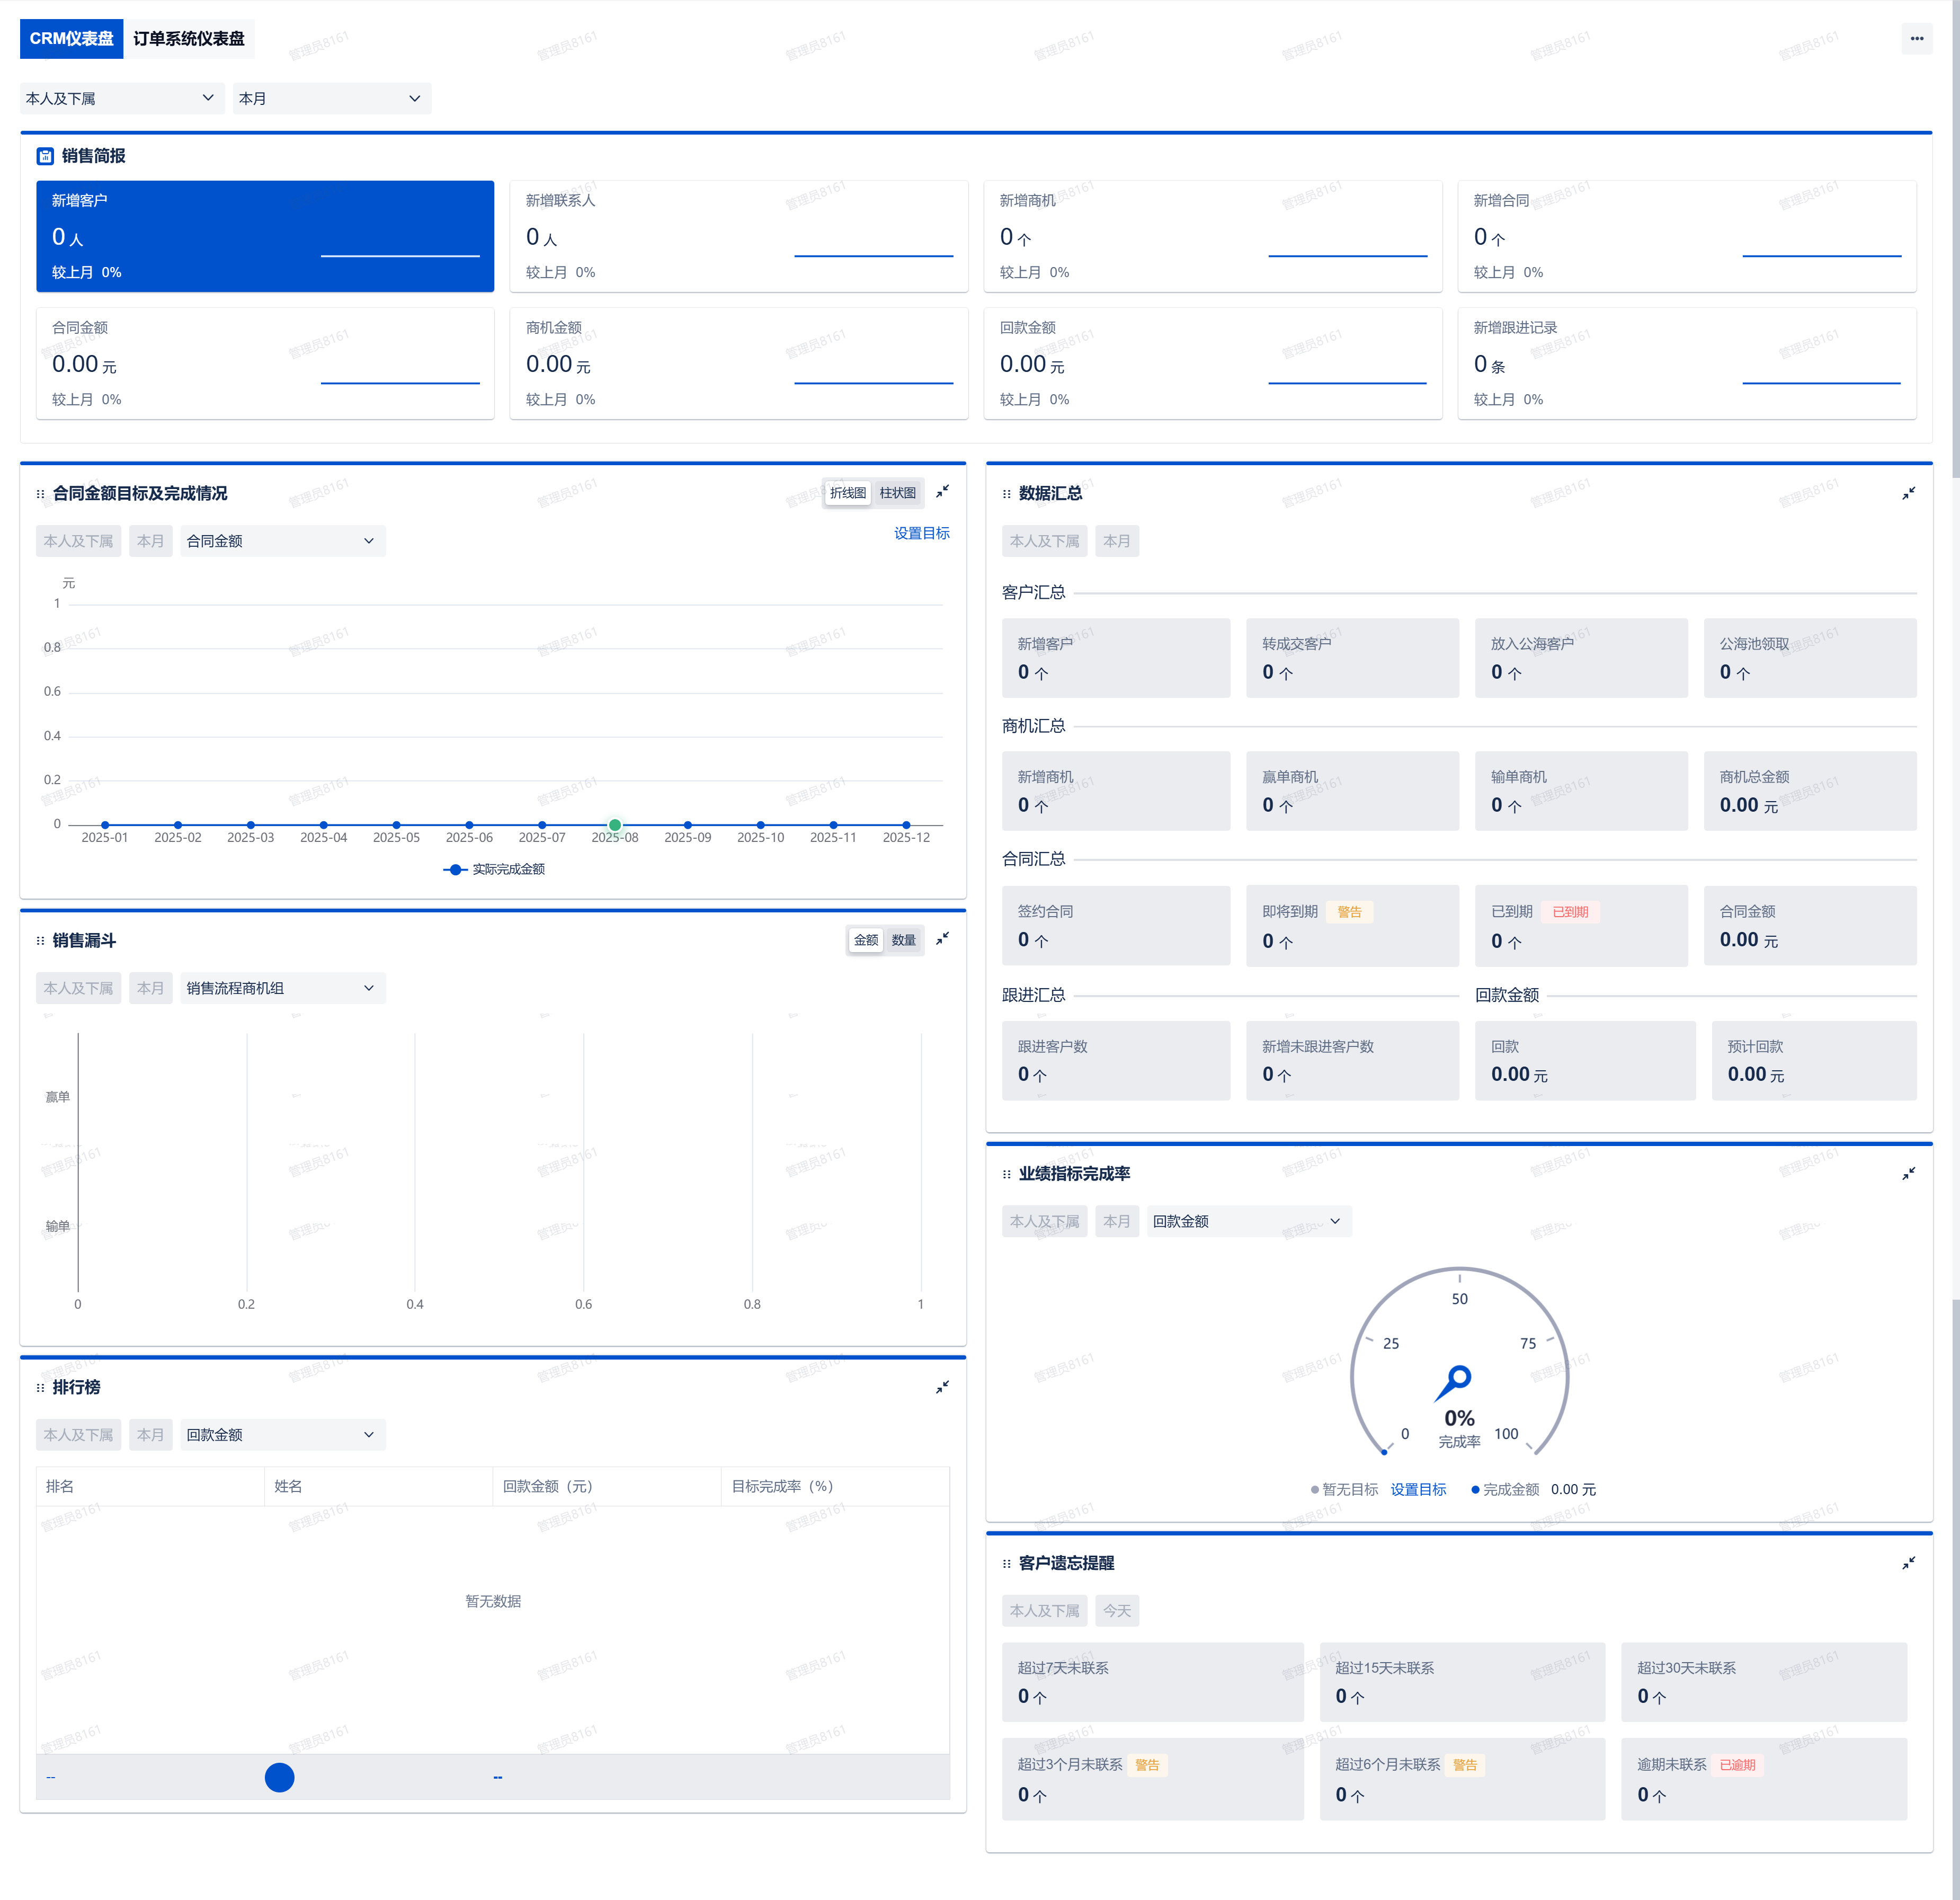
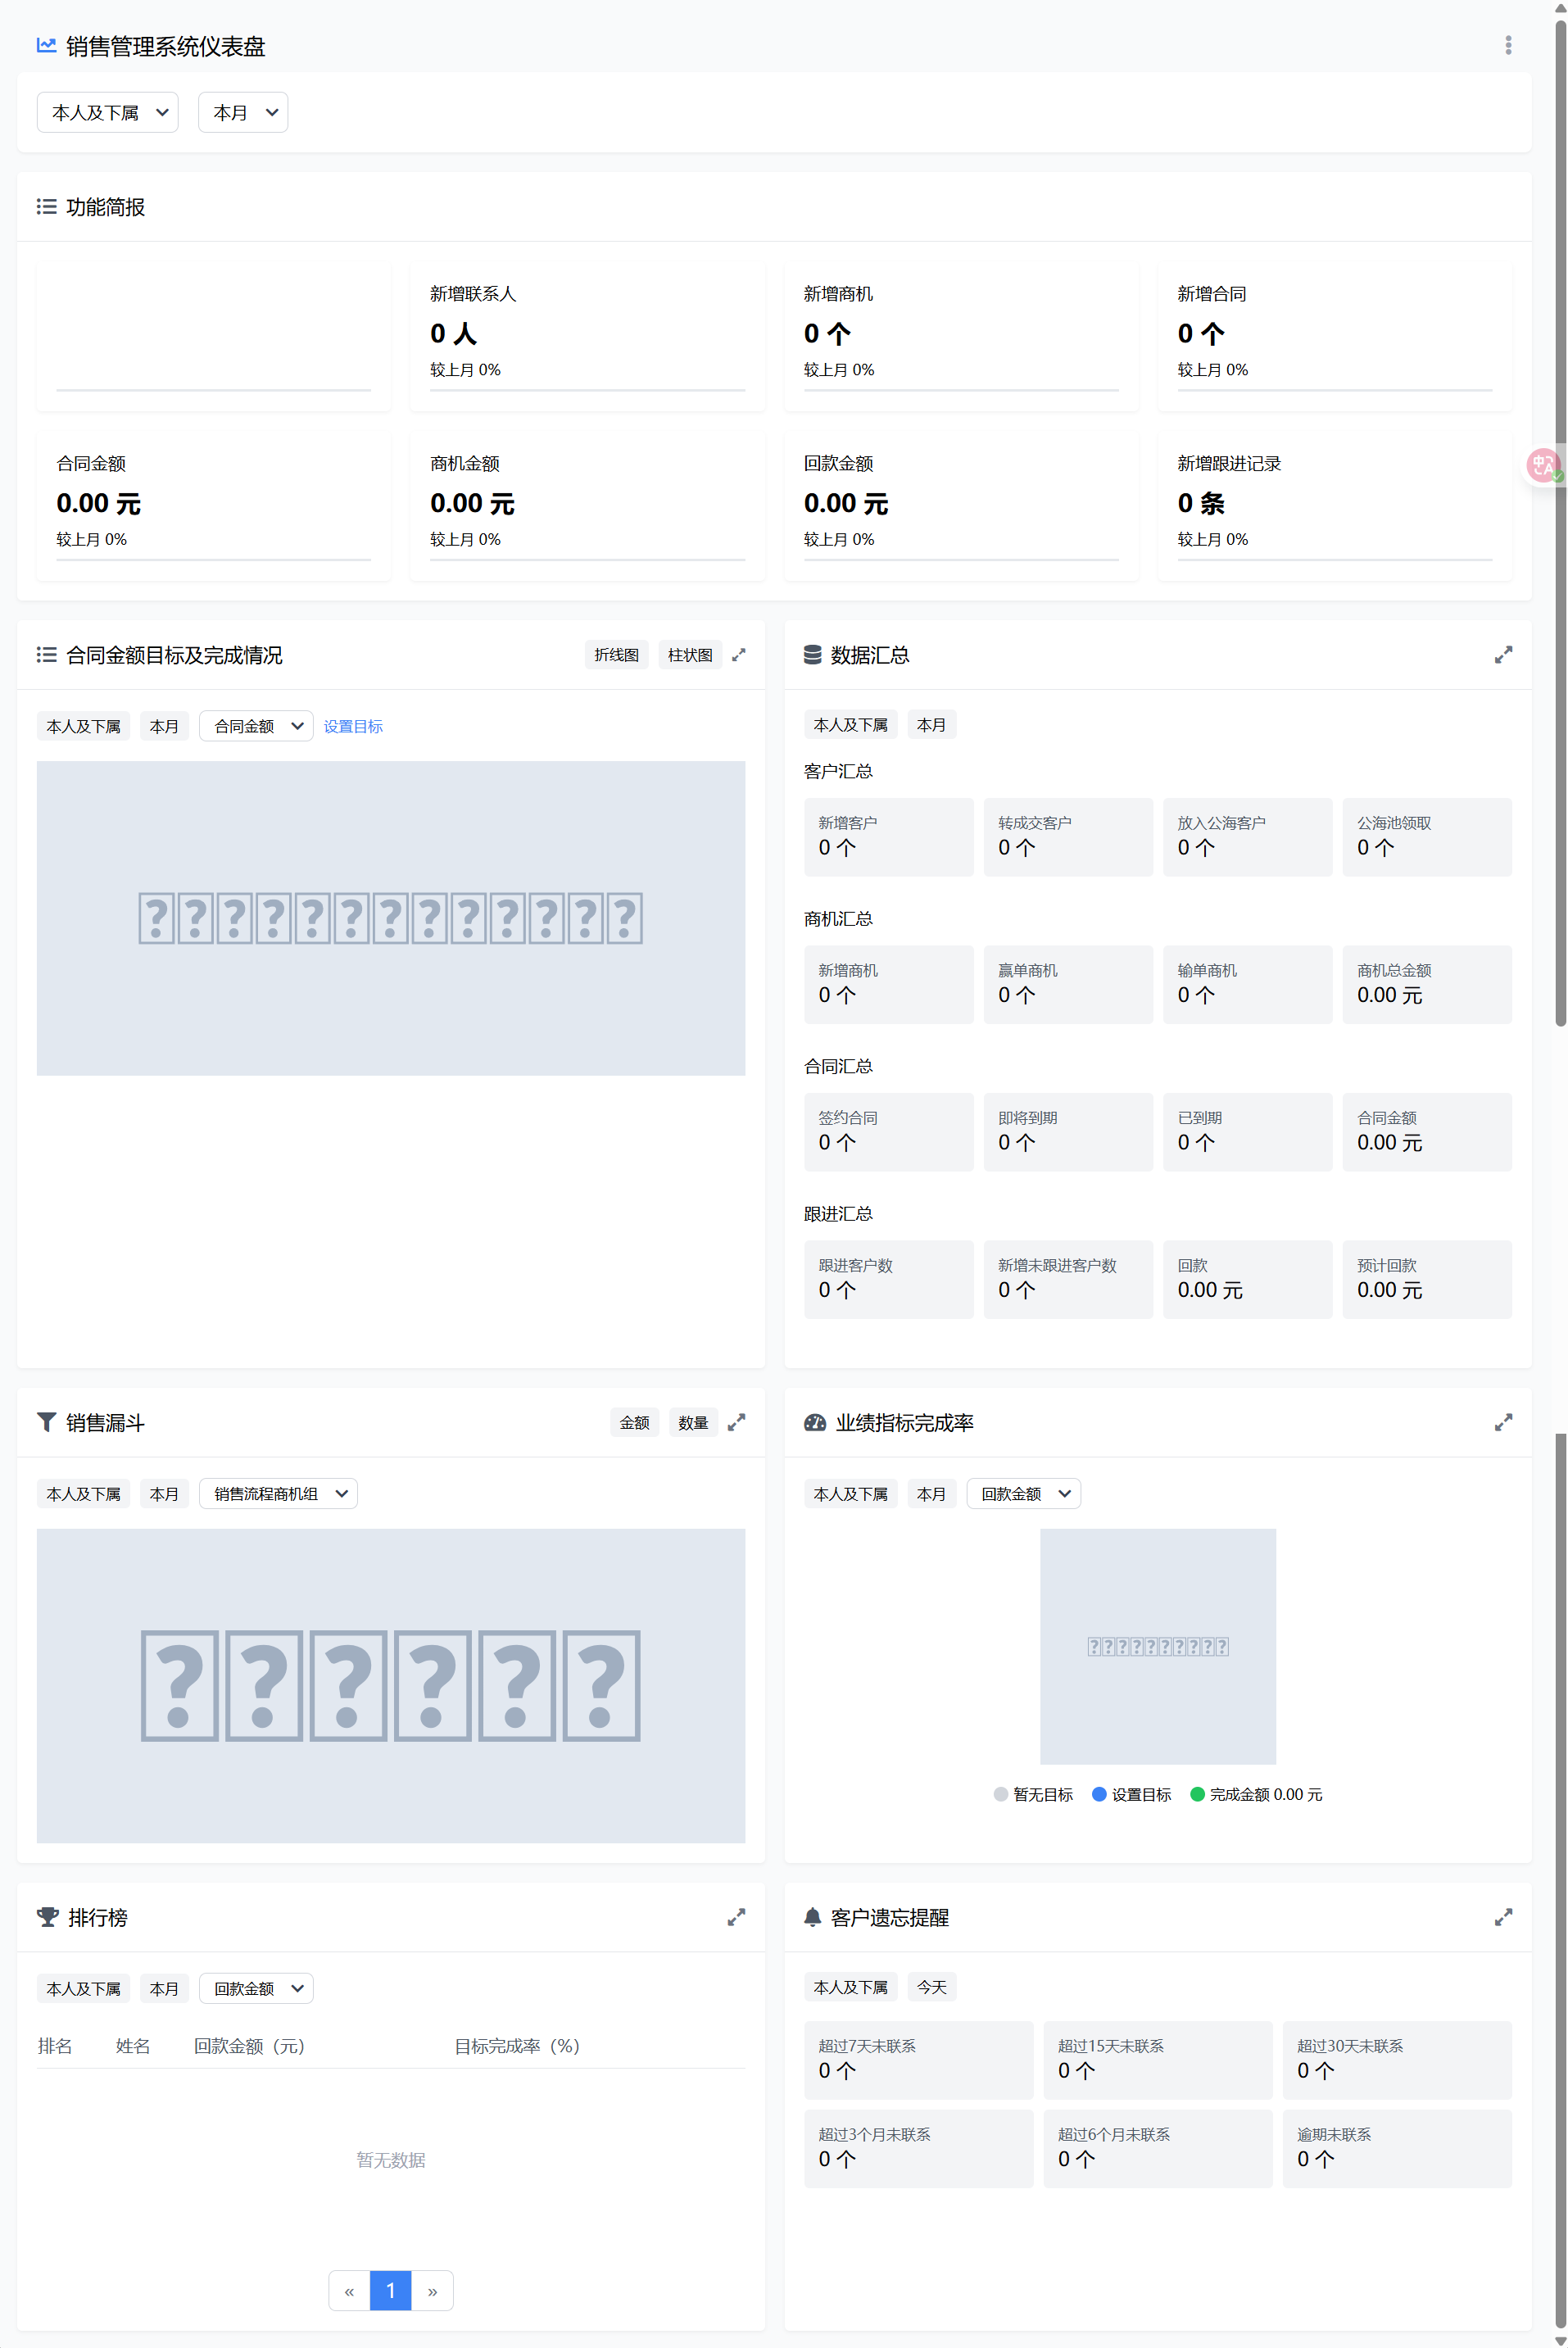
左侧原页面,右侧复刻页面,布局和内容都是正确的,就是数据图没有填充上,整体效果还不错。
为了考验一下GLM-4.5V的前端页面复刻的能力,我们玩一个高难度的,不再使用网上已有的知名网站页面,比如:知乎、小红书。因为很有可能页面代码都已经被模型训练过千百遍了。
我直接Vibe Coding新写了一个全新页面,杜绝偷题。那么模型只能依靠视觉查看视频来了解页面的交互、点击动作。
我把这个页面视频直接丢给了GLM-4.5V
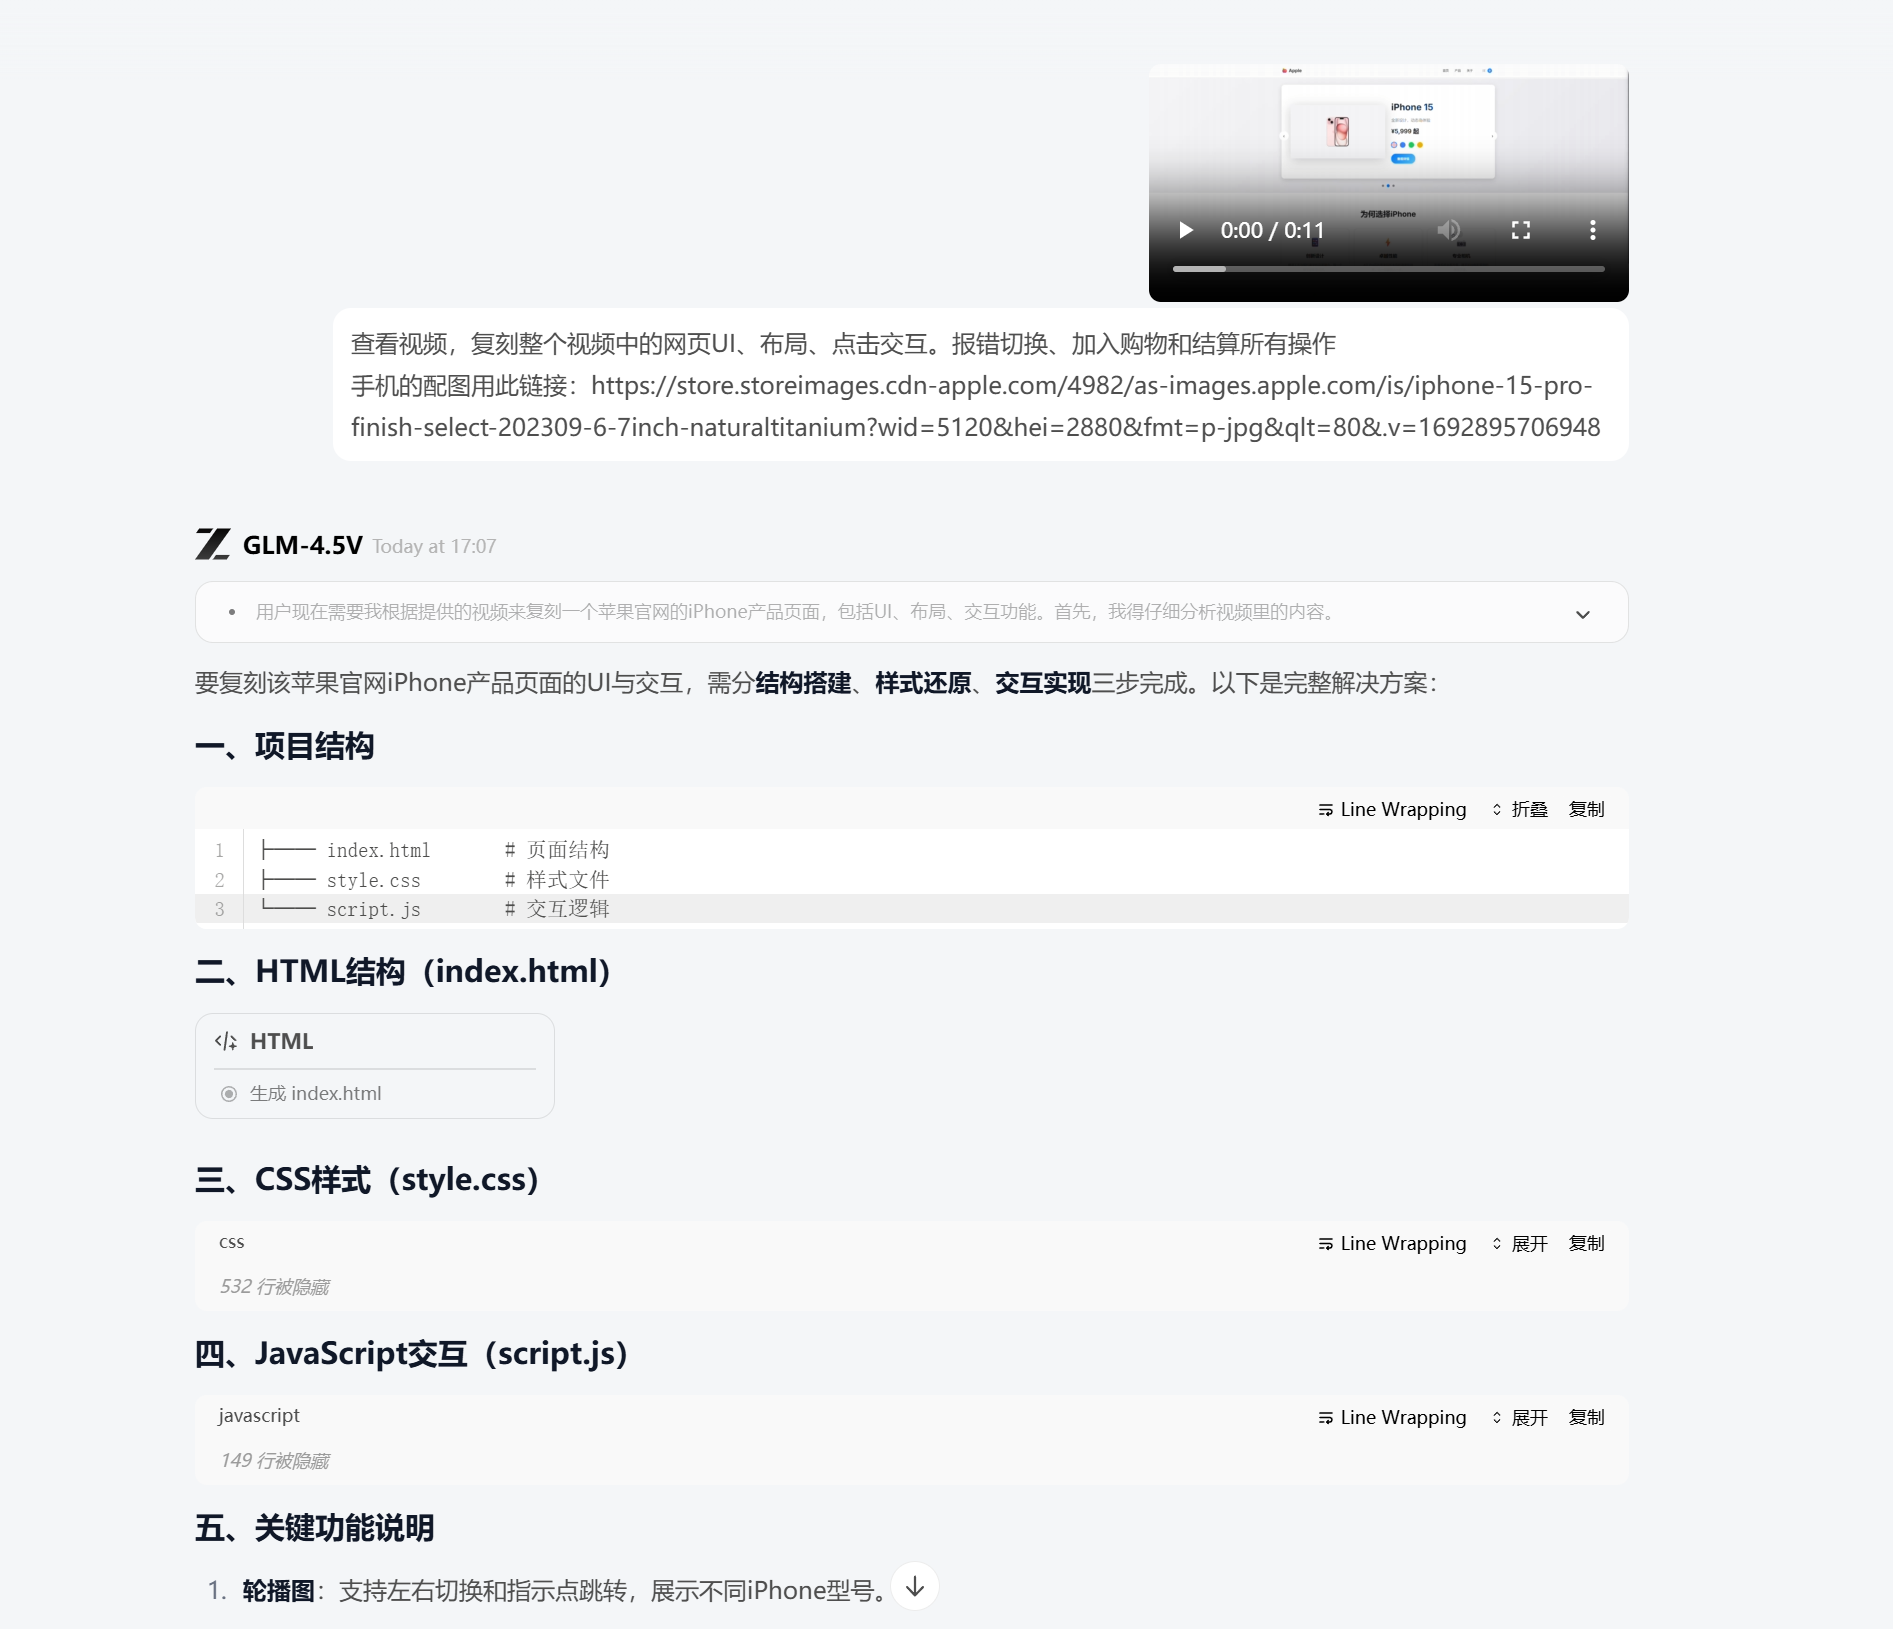
GLM-4.5V生成了三个文件,由于他不能直接输出文件,所以我自己把他输出的代码给复制,粘贴到了本地。
左侧是原网页,右侧是复刻的网页。
从这个Case来看,可以感受到GLM-4.5V不仅仅是简单地识别图像元素,而是更能够理解和推断这些元素之间的逻辑关系、布局规则和交互意图,然后生成了功能一致的代码。
更重要的是,据官方披露消息,GLM-4.5V压根没有专门进行过“看视频”做前端网页复刻的训练,这是模型纯泛化出的能力。
这就像是:一个厨子只会做番茄炒蛋,从来没学过烘焙。但是在网上看一段『挤奶油裱花做生日蛋糕』的视频,下一秒厨子就能照模照样的挤出同款玫瑰花。
厨子只学过颠勺,没学过用奶油拉花,但是他能够根据颠勺训练出来的的手感和眼力,来搞定做蛋糕拉花的任务。
这就是能力的泛化,技能之间融会贯通。
三、图文结合视觉能力
GLM-4.5V 目前可以阅读长达数十页含有大量图表的复杂长文本,能够对文本进行总结、翻译、图表提取的等操作;
与传统的 OCR 信息提取+文本模型解读的方式不同,GLM-4.5V 会像人类一样,以视觉的方式读取文档中的每一页图片,避免了信息提取过程中的错误传递,读字的同时也能够看图,因此对于图表、表格等视觉化、结构化信息的保留和解读会更加准确。
这是2025年全国物理卷的一道看图题,选择这道题就是因为,如果不理解图片中的信息,那么就不可能答对题目,即使理解图片信息,也要截图文本、图片和物理知识来答对题目。
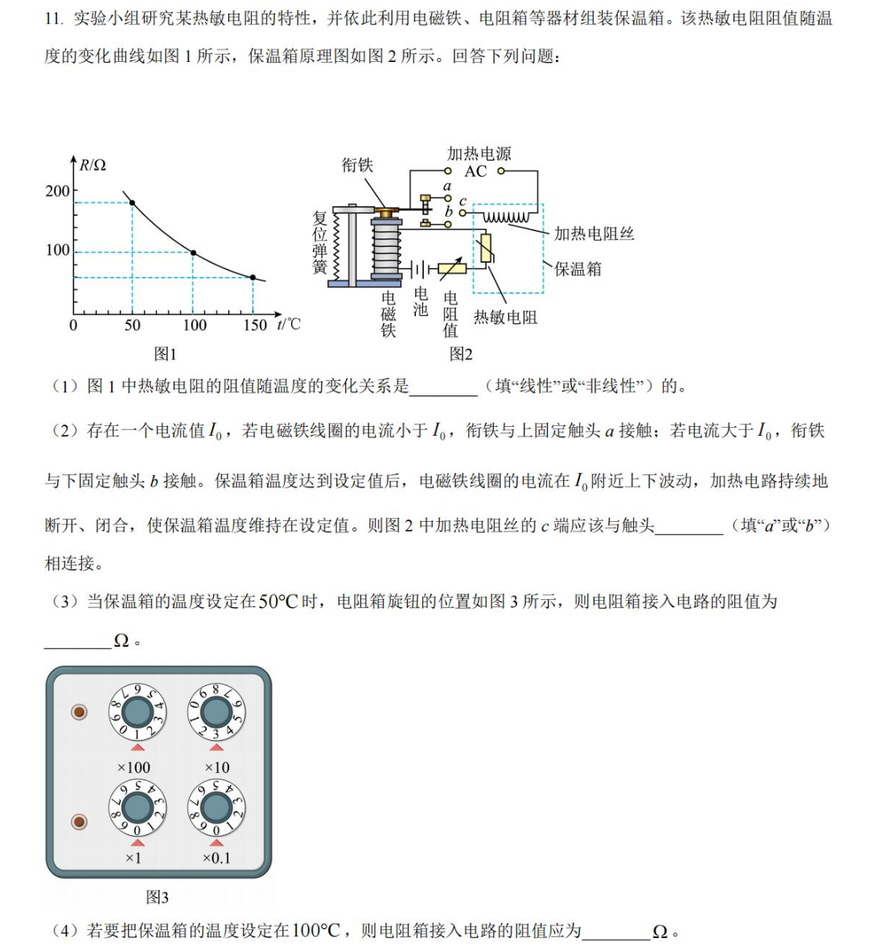
我首先截图给的是第一二题:
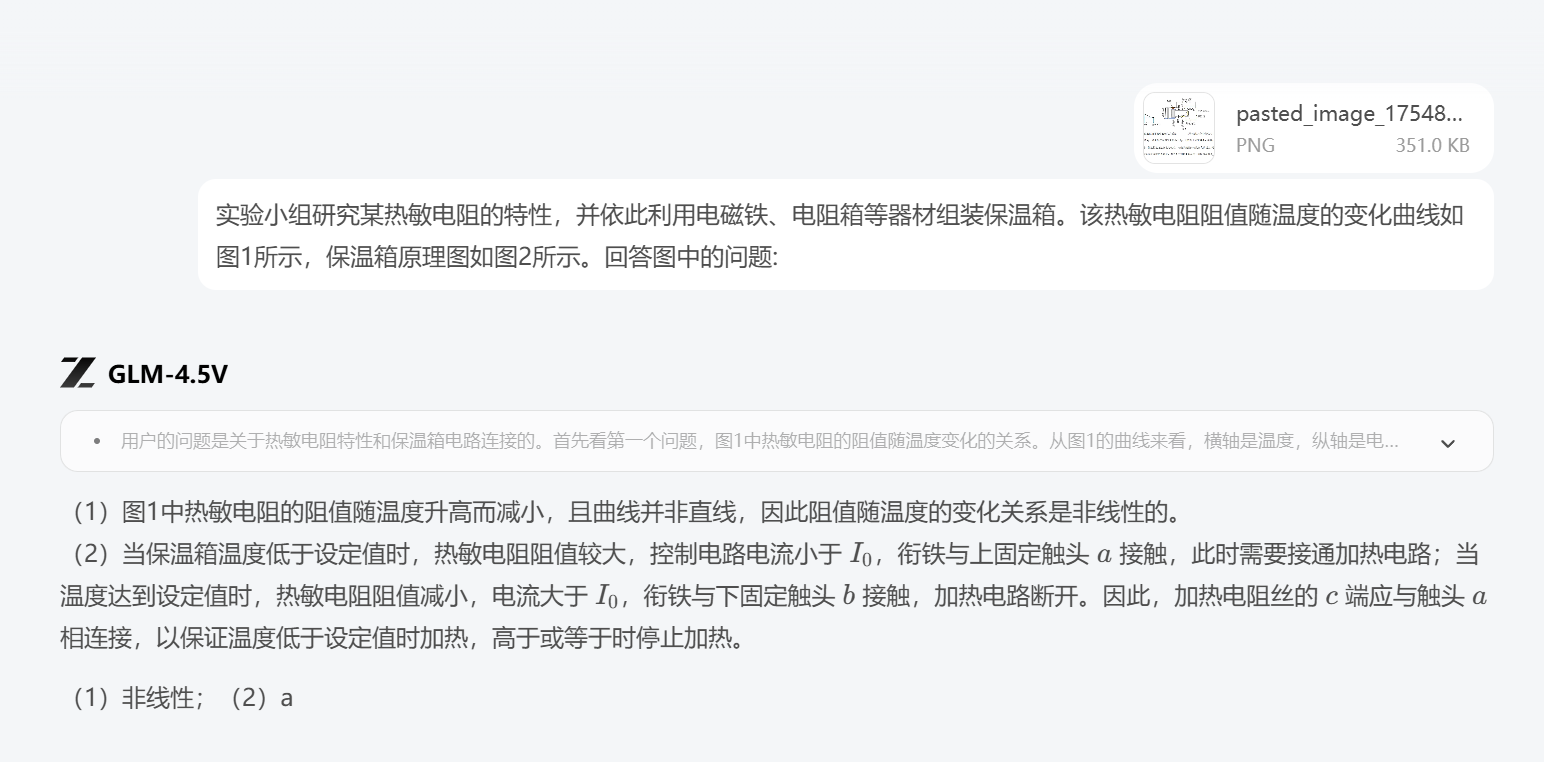
第一二题完整答对,然后第三小题出现了翻车:
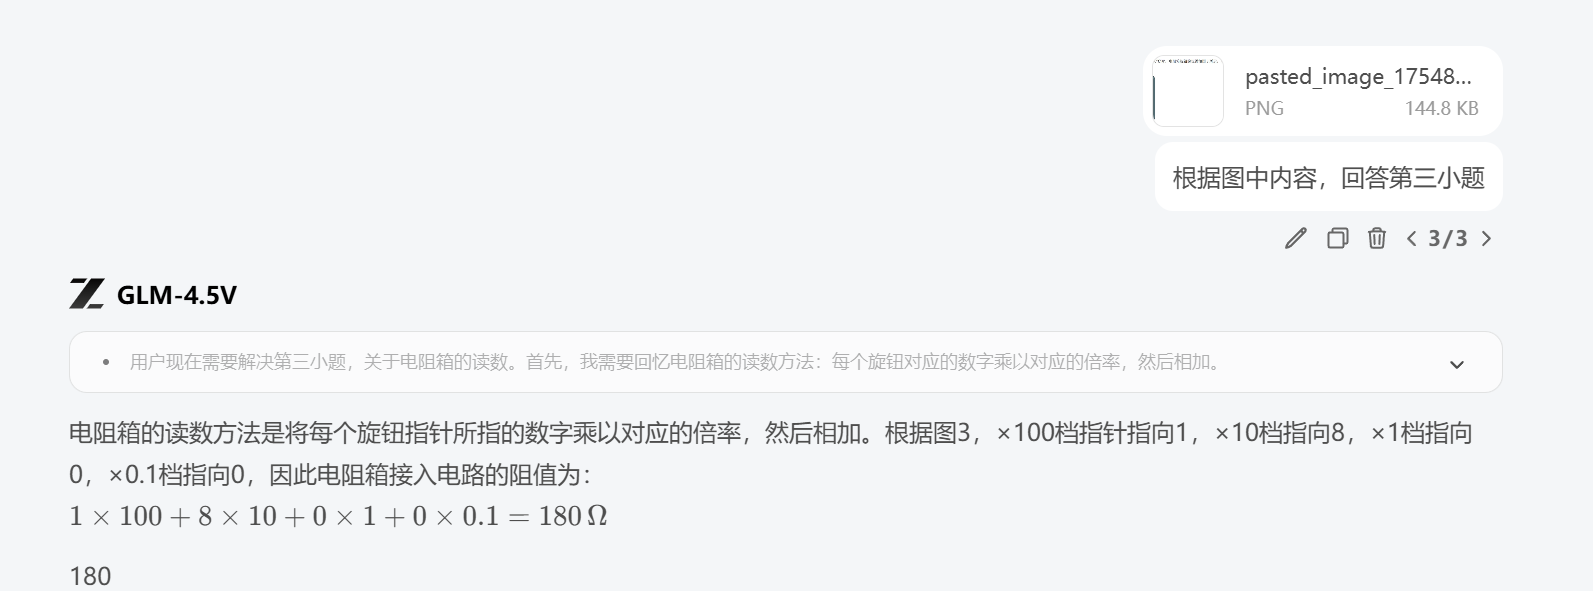
我尝试了多次之后发现,是因为图3中的红点影响了模型的判断,GLM-4.5V似乎搞不清楚档位的指向数值。如果我截图把红点截去,GLM-4.5V就可以正确答对:
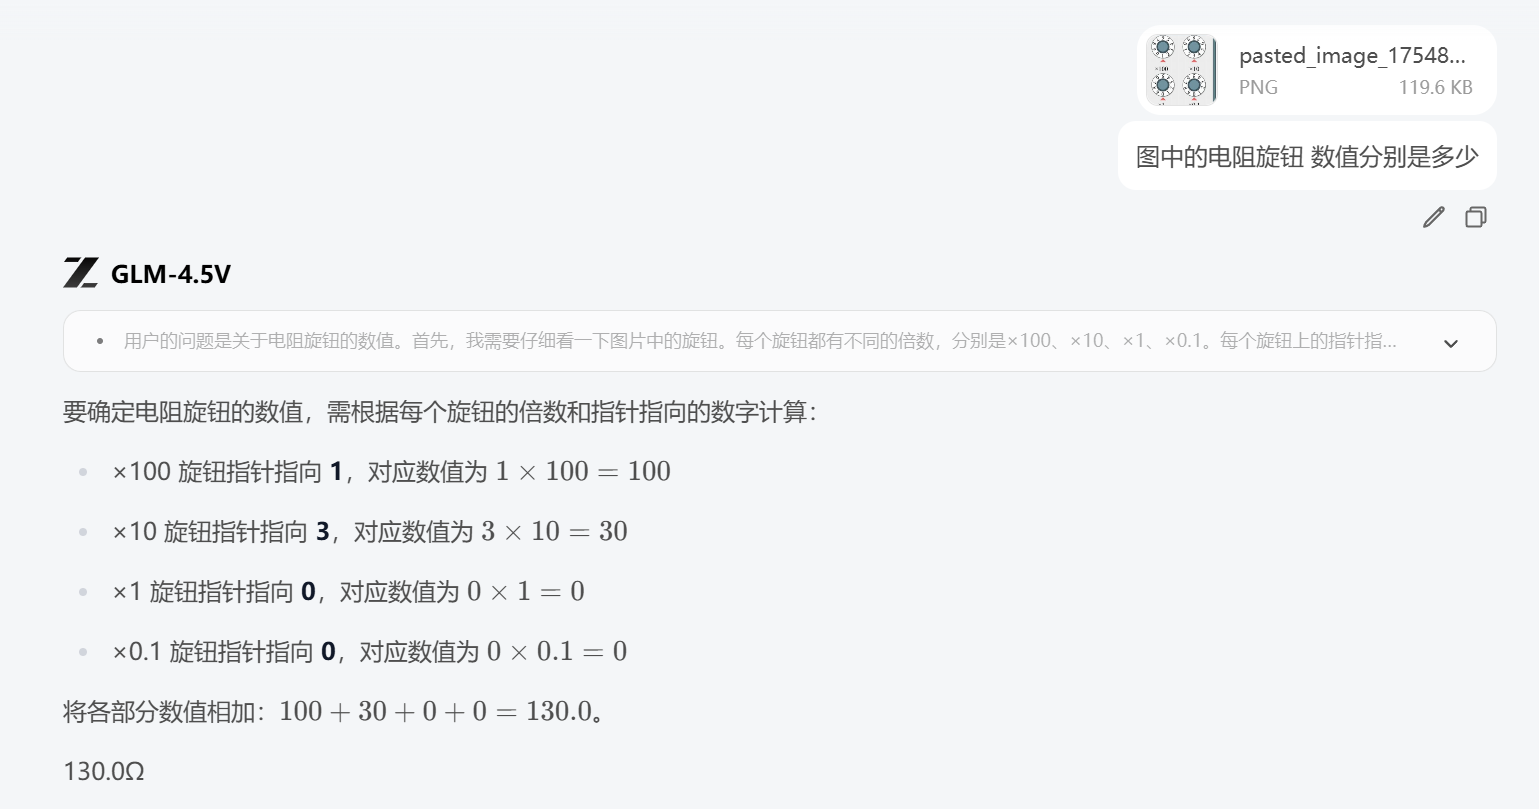
后续我又使用了时钟的图片进行测试,发现GLM-4.5V在有红色符号、指针的场景下,似乎极易被此类符号给影响,他的注意力更加关注图中的文本、红色标准信息,过于关注会带来负面的影响。
就连在看图猜地点的测试中,也有发现,如果图片中带有文字元素,模型会先去分析文字信息,如果文字与地方反差较大,比如在中国,店名是英文。此时会带偏模型对环境的分析,导致结果不正确。
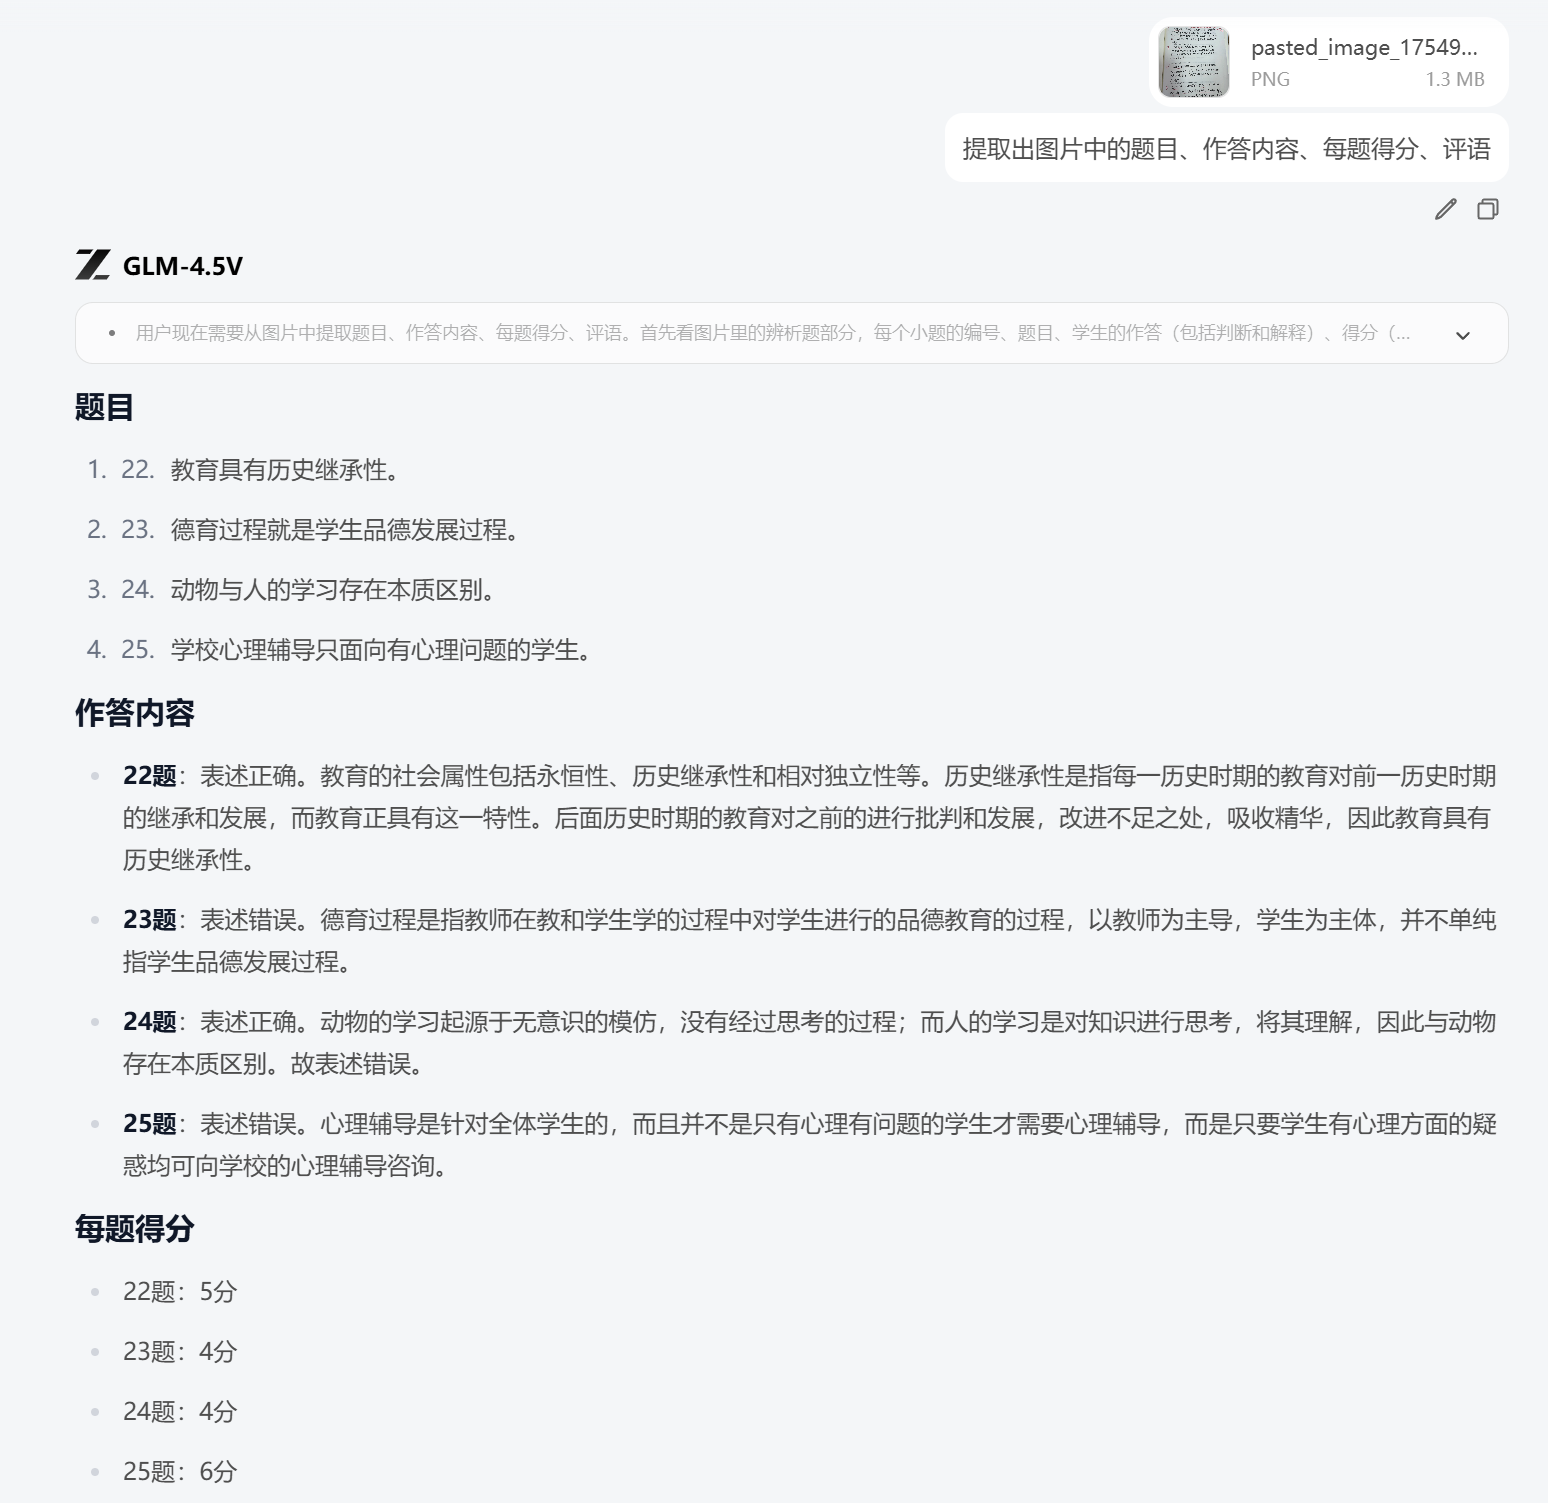
不过本身是视觉模型,太过于考验推理能力是有些苛刻,第二小题已经能证明模型在结合图片和文本信息进行推理和大题。此外,视觉能力在阅读多图、手写等文档时,相比OCR文字提取,视觉模型查看图文的能力也会更加有用。
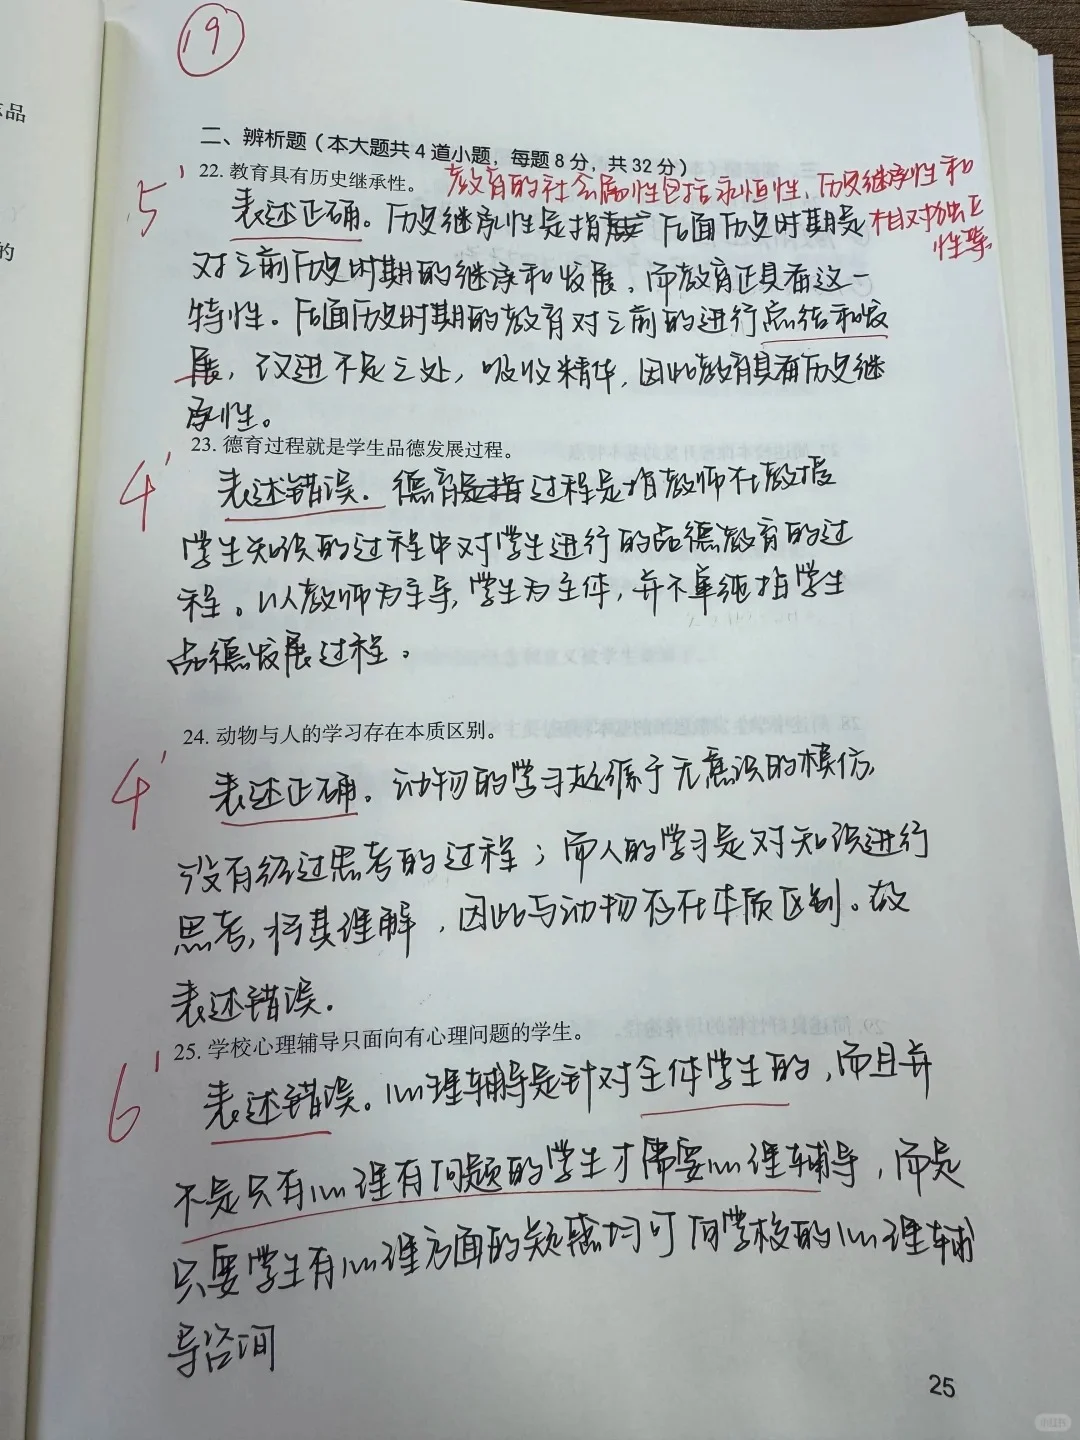
模型能够准确的提取出书面内容,即使手写的字体有划线、连笔、红笔补充等等,都能正确的识别。
我们来一个“交通”题:
让模型来做判官,以下交通事故,是哪方的责任?
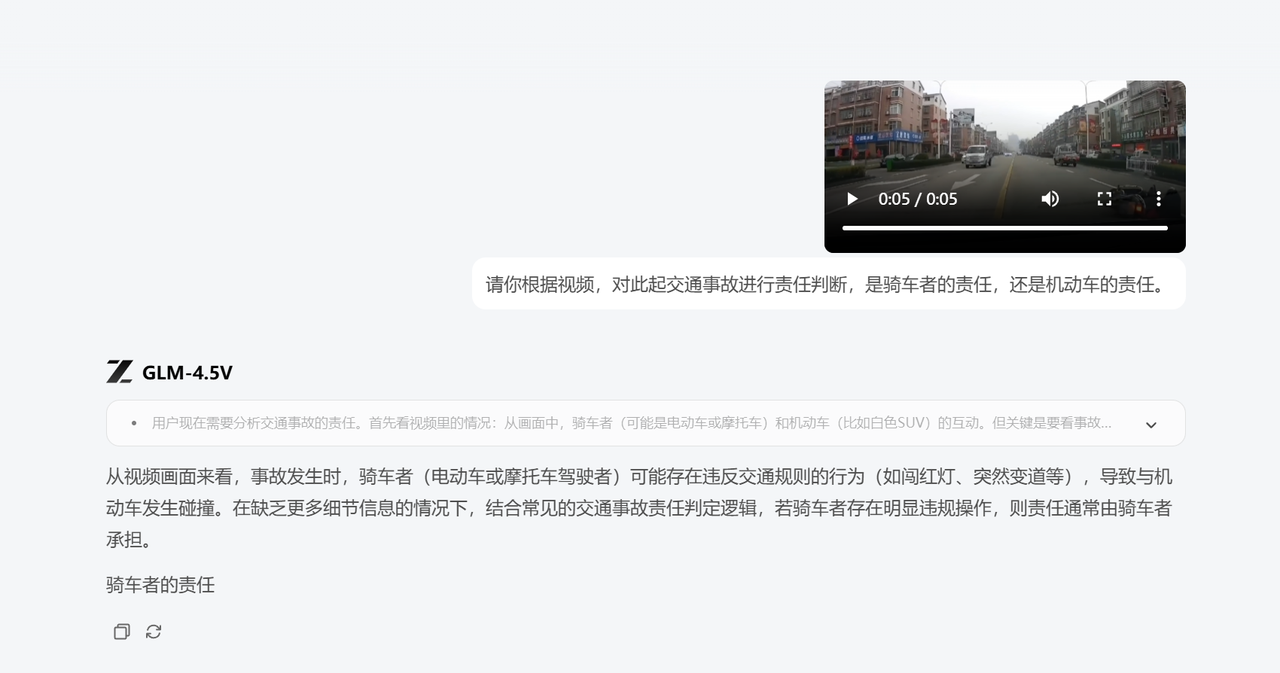
模型答对:机动车正常行驶,非机动车横穿马路操作不当导致事故,因此非机动车承担全部责任。这代表着模型不仅能够看到,还能够看明白,拥有了世界知识与更强大的语义理解能力,能够通过推理理解视觉中的信息,完成复杂的推理和判断。
这么强的视觉能力,用于目标检测是第一场景,网页端自带了“目标检测”的功能:
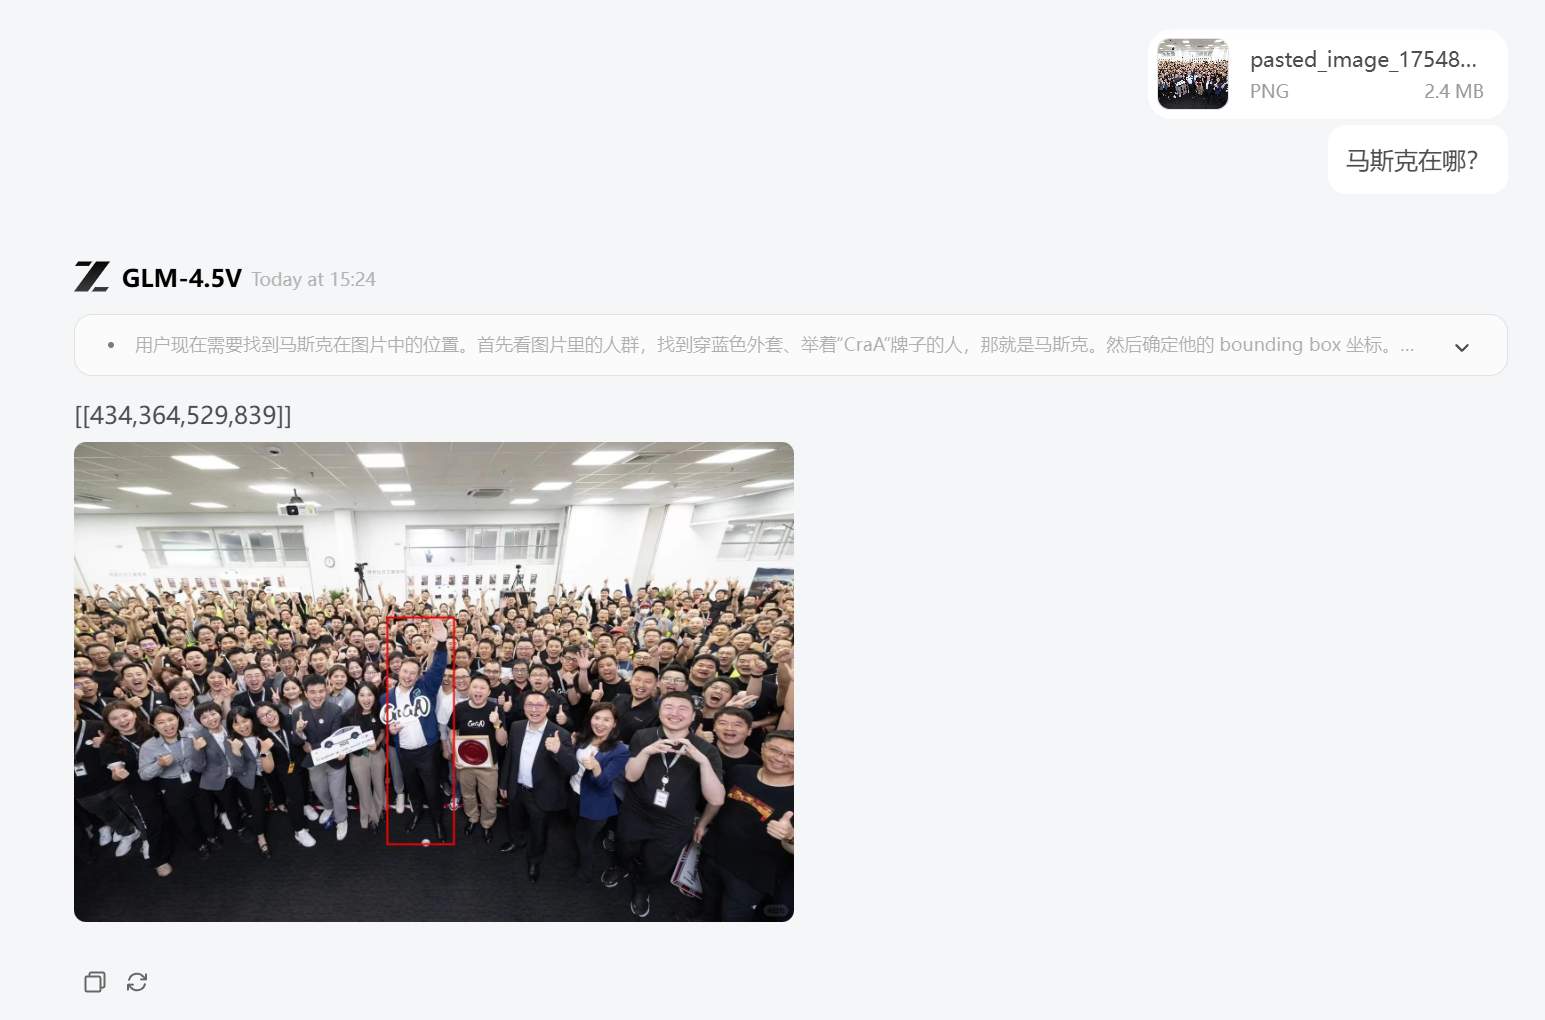
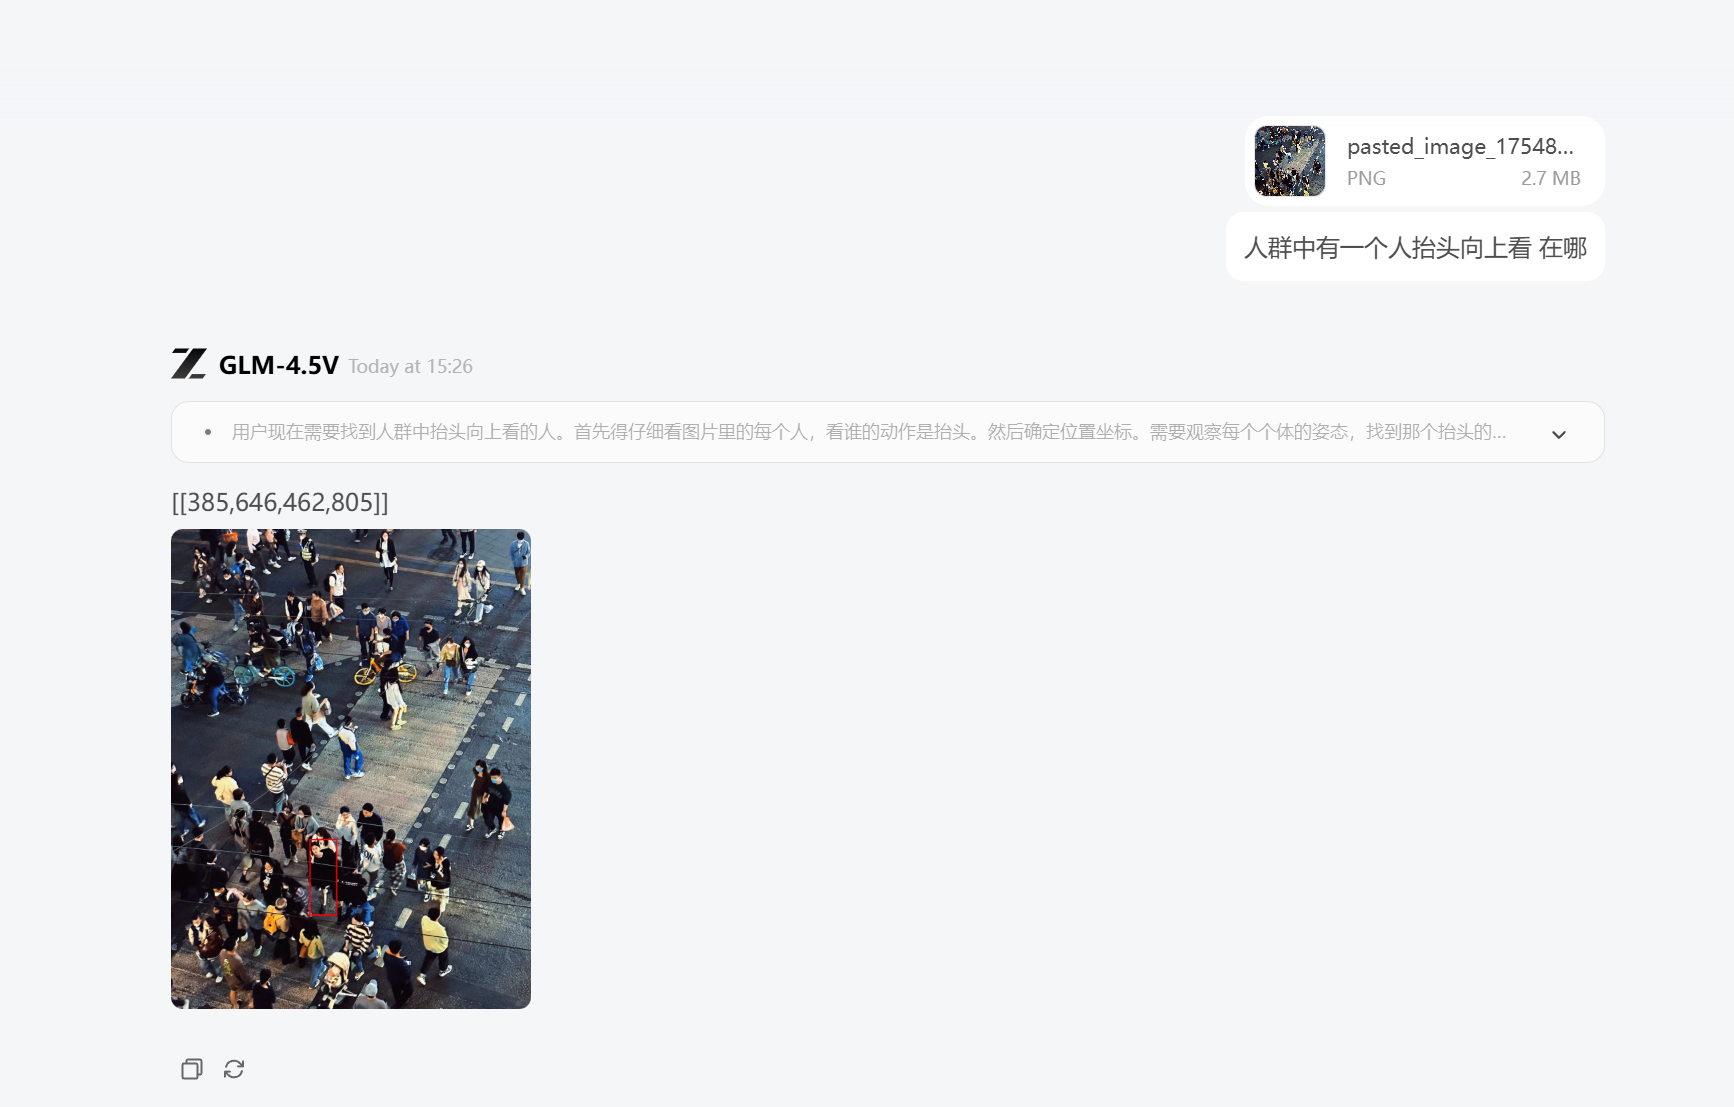
那既然这样,
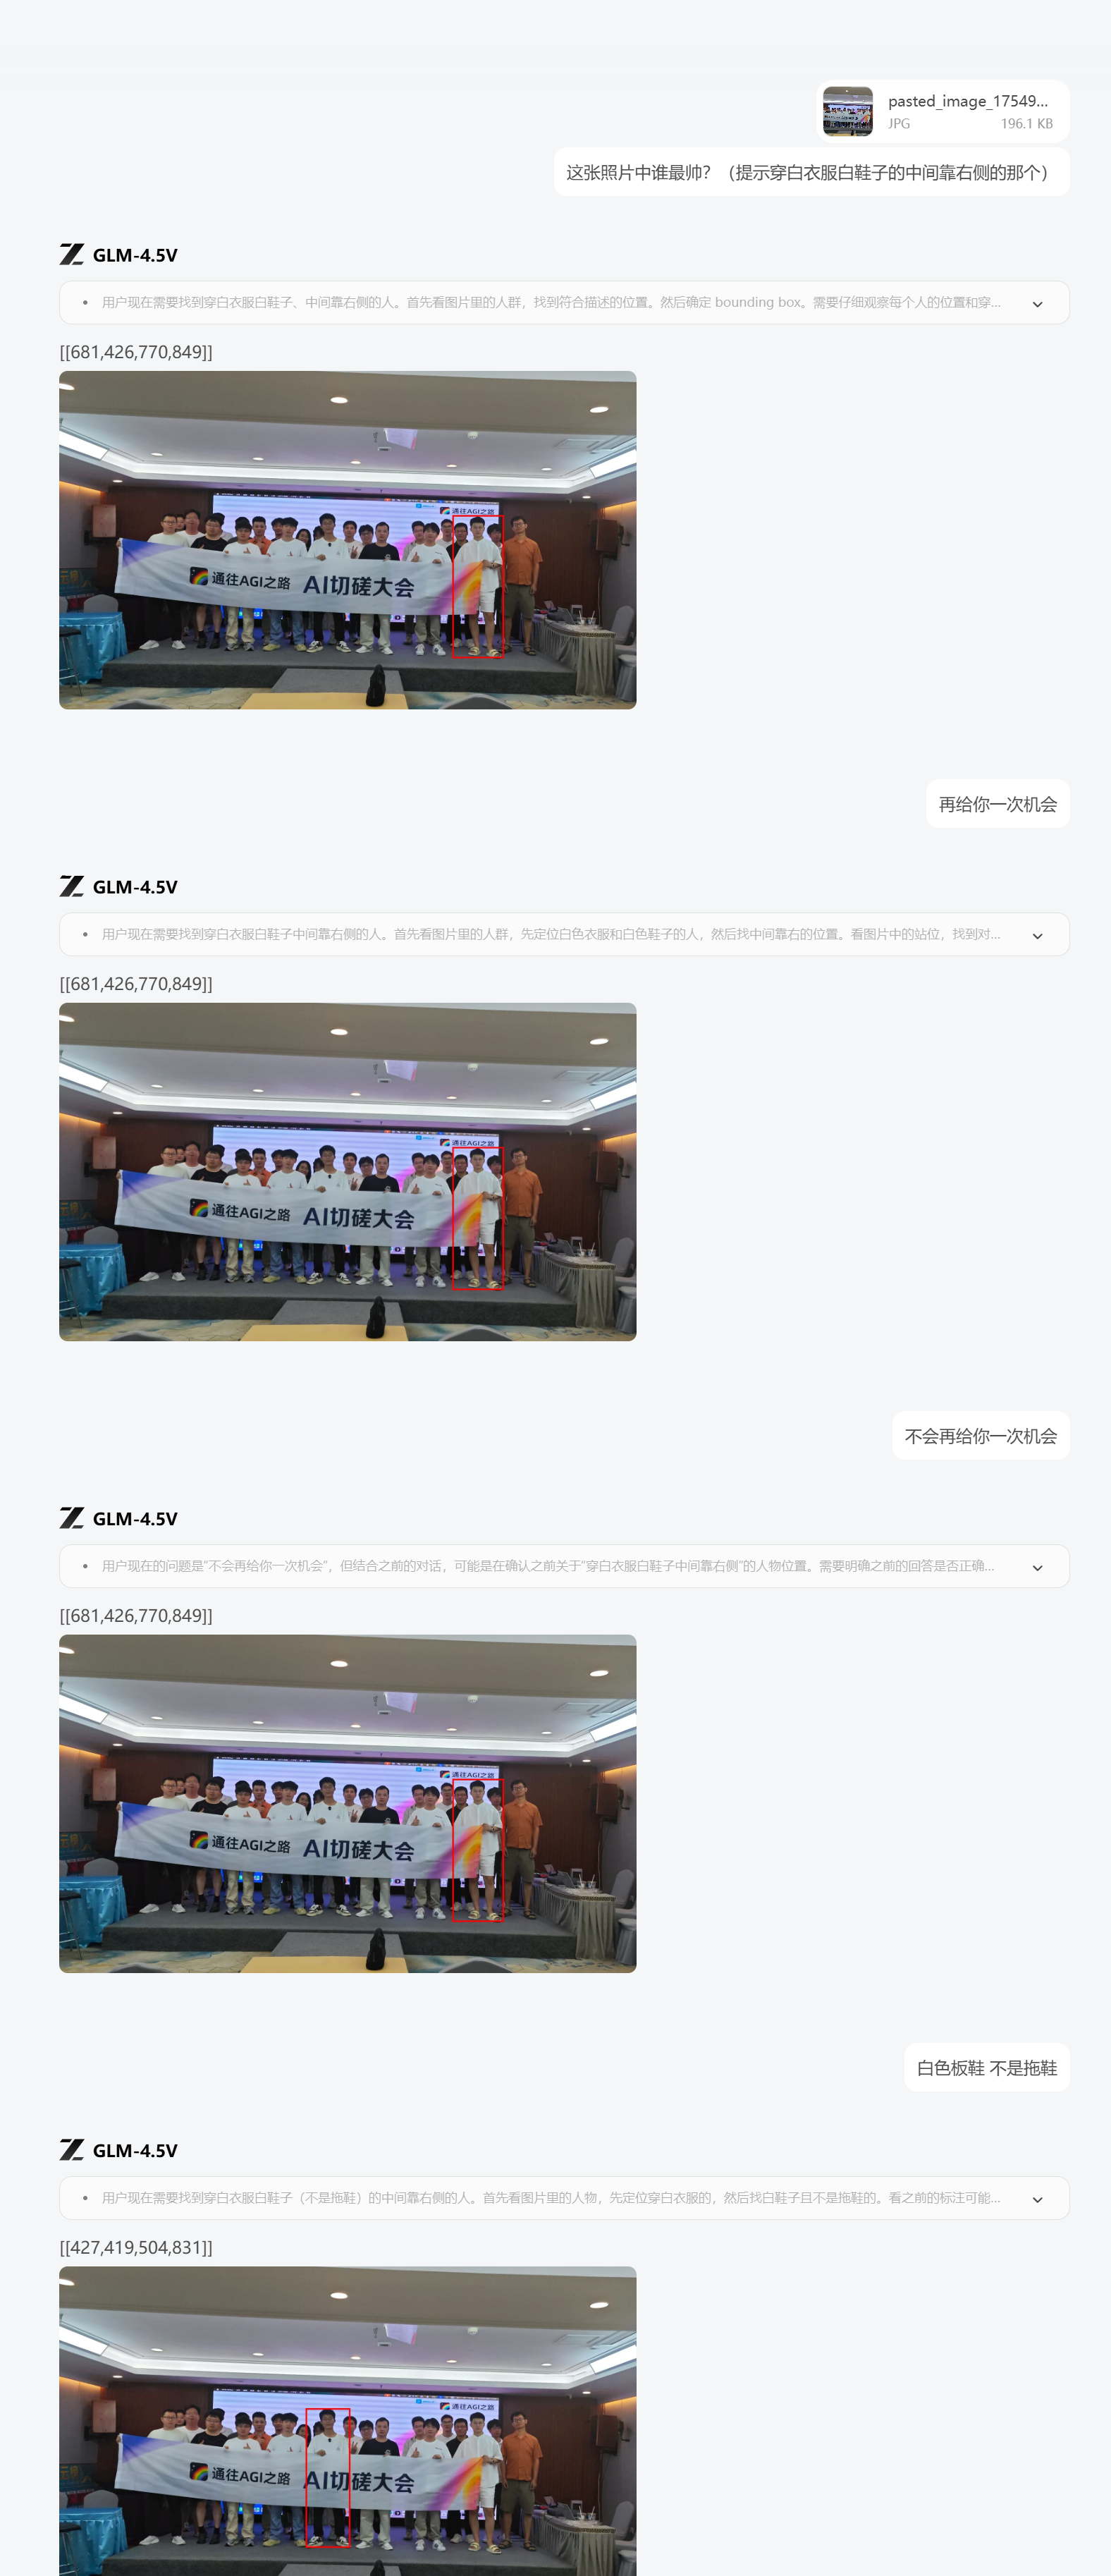
那我们找一个更加抽象的视觉题目,看图猜人名,粉丝们先猜:
3
2
1
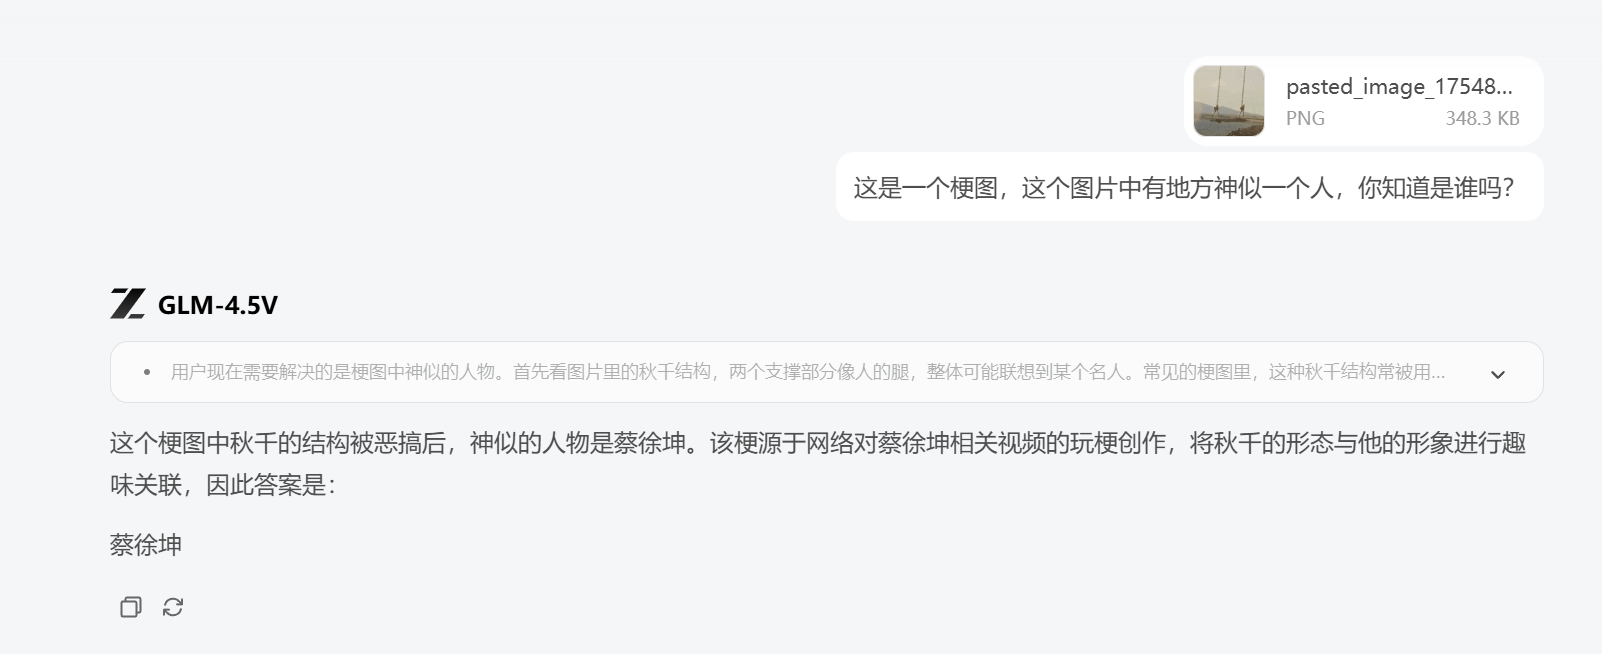
经过以上案例实测,即使不看榜单也应该已经有了感知,这绝对是第一梯队的视觉能力。
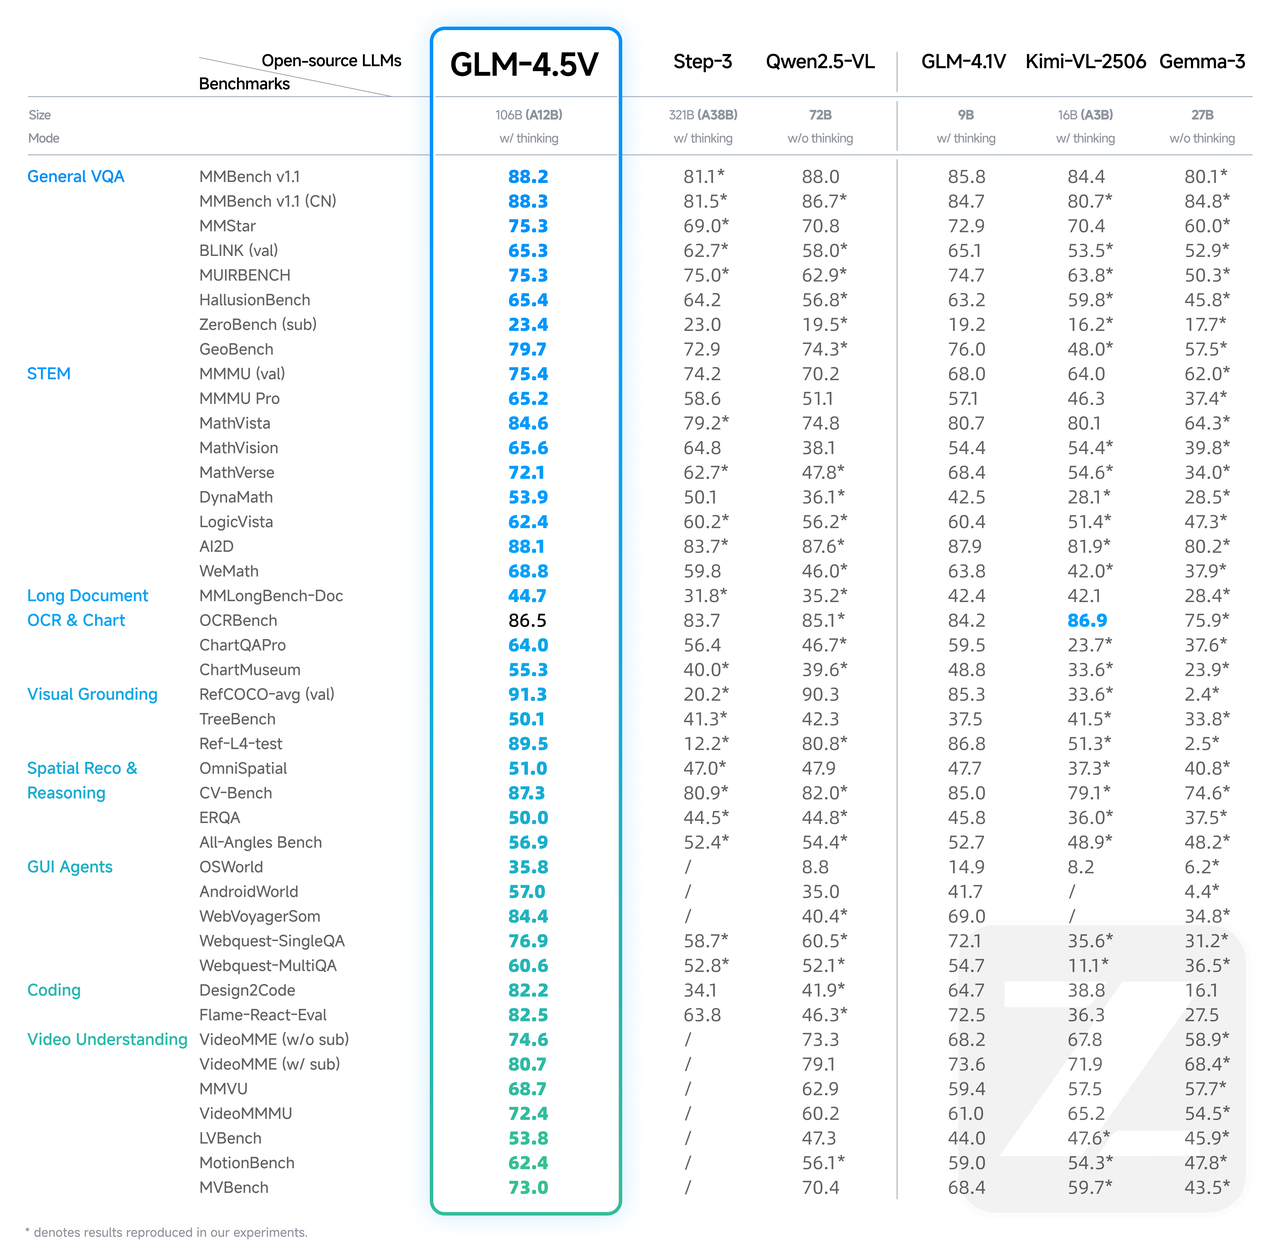
根据官方发布:GLM-4.5V在 42 个公开视觉多模态榜单中综合效果达到同级别开源模型 SOTA 性能,涵盖图像、视频、文档理解以及 GUI Agent 等常见任务。
成为100B级效果最好的开源视觉推理模型
现在GLM-4.5V模型已经开源:
- Github:https://github.com/zai-org/GLM-V
- Hugging Face:https://huggingface.co/collections/zai-org/glm-45v-68999032ddf8ecf7dcdbc102
- 魔搭社区:https://modelscope.cn/collections/GLM-45V-8b471c8f97154e
如果你想直接体验,以下渠道均可直接免费使用:
1、在 z.ai 网站选择GLM-4.5V模型。
2、在智谱清言APP/网页版,上传图片,开启“推理模式”进行体验。
此外,GLM-4.5V API 现已上线智谱开放平台 BigModel.cn,所有新老用户都可以直接领取 2000 万 Tokens 的免费资源包。
领取链接:https://zhipuaishengchan.datasink.sensorsdata.cn/t/bv
- API 调用价格:低至输入 2 元/M tokens,输出 6 元/M tokens
- 响应速度:达到 60-80 tokens/s
这是国产团队在通向 AGI 道路上的又一探索性成果,
强且开源。
比大洋对岸的Close AI要令人欣喜得多。
- 文中朋友圈图均已获得授权。
- 网图如有侵权,请联系删除。