昨天看到一个图,就觉得搞笑又真实:
最近模型更新快的,确实有点看不过来。
DeepSeek V4 Pro、GLM-5.3 接连更新,豆包推出了 Seed-Evolving,DeepSeek 还发布了自己的 Harness。模型能力在涨,给模型提供工具和执行环境的 Harness 也在进化。
而且还都说很强,我们要是再让模型做一个前端页面然后做对比。 说真的,已经很难看出它真实表现了,一个页面真的太简单了,做的好或差,也反映不出来真实的解决问题的能力。
为了既能够直观,又反映出真实能力,我们这样做了一个测试,下面这段录屏是回放了一轮完整测试过程:
我给大家说清楚,这到底是个啥。
我把 5 个国产编程模型、放进 5 份完全相同的真实代码仓库,让它们修同一个 Bug,每款模型连续跑 3 次。
然后把它整个过程全部记录下来:它读了哪些文件、搜了什么代码、什么时候开始修改、运行了什么命令、哪里报错、失败后有没有回退、又是怎么换方向的。
这就像是把 5 位程序员分别请进 5 间独立办公室,给他们同一张工单,然后全程录屏。
最后,我们会拿到两份东西。
一份是结果表,看 Bug 到底有没有修好。
另一份是轨迹日志,看程序员到底是怎么修的。
有的人会先把相关文件和文档查一遍,找到关键位置后再动手;有的人上来就改,边报错边调整;还有的会同时探索很多方向,在不同文件之间反复切换。
人是如此,体现到模型上也是同样,是先调研解决方案,看一遍文档,还是不管三七二十一上来就干,是有很大差异的。即使最后的结果都是修好了,但背后的稳定性、执行成本和需要人工盯着的程度,也可能完全不同。
这就是这次测试的价值:结果表告诉我们它有没有到达终点,轨迹图把它一路怎么走也展示了出来。
通过轨迹图,我们能了解这个模型的脾气、性格、犯错次数,甚至,,能看出是否够“聪明”。
这次测试是怎么做的
这几个模型执行的任务,来自拥有 40k stars 的开源协作文档项目 Outline。
每个模型都从同一份代码开始,彼此不共享记忆,也看不到其他模型留下的结果。每款模型分别运行 3 次,主测试一共 15 次。我们在做测试时 GLM-5.3 还没有发布,所以这次使用的是 GLM-5.2。
这些模型主要在 Oh My Pi 中执行。可以把它理解成模型的工作台:模型通过它读取文件、搜索代码、修改内容和运行测试。
另外,我还放入了一条 DeepSeek Harness + DeepSeek V4 Pro 的对照轨迹,用来观察同一个模型换了一套工作台后,执行方式会不会变化。
下边是结果评分,这个结果表只能反映完成情况怎么样,大家可以先记住这个评分:
| 模型 | 本任务最终评分 |
| DeepSeek V4 Pro | 93 |
| Kimi K3 | 92.5 |
| DeepSeek V4 Flash | 79.7 |
| GLM-5.2 | 78 |
| Doubao-Seed-Evolving | 73.3 |
| DeepSeek Harness + DeepSeek V4 Pro | 82 |
毕竟模型是小心谨慎得这么多分,还是一顿操作猛如虎后的得分,这是完全不同的概念。
模型在动手前看了多少东西,中间走过多少弯路,失败后能不能自己调整,这些都藏在执行日志里。下边是完整日志轨迹图:
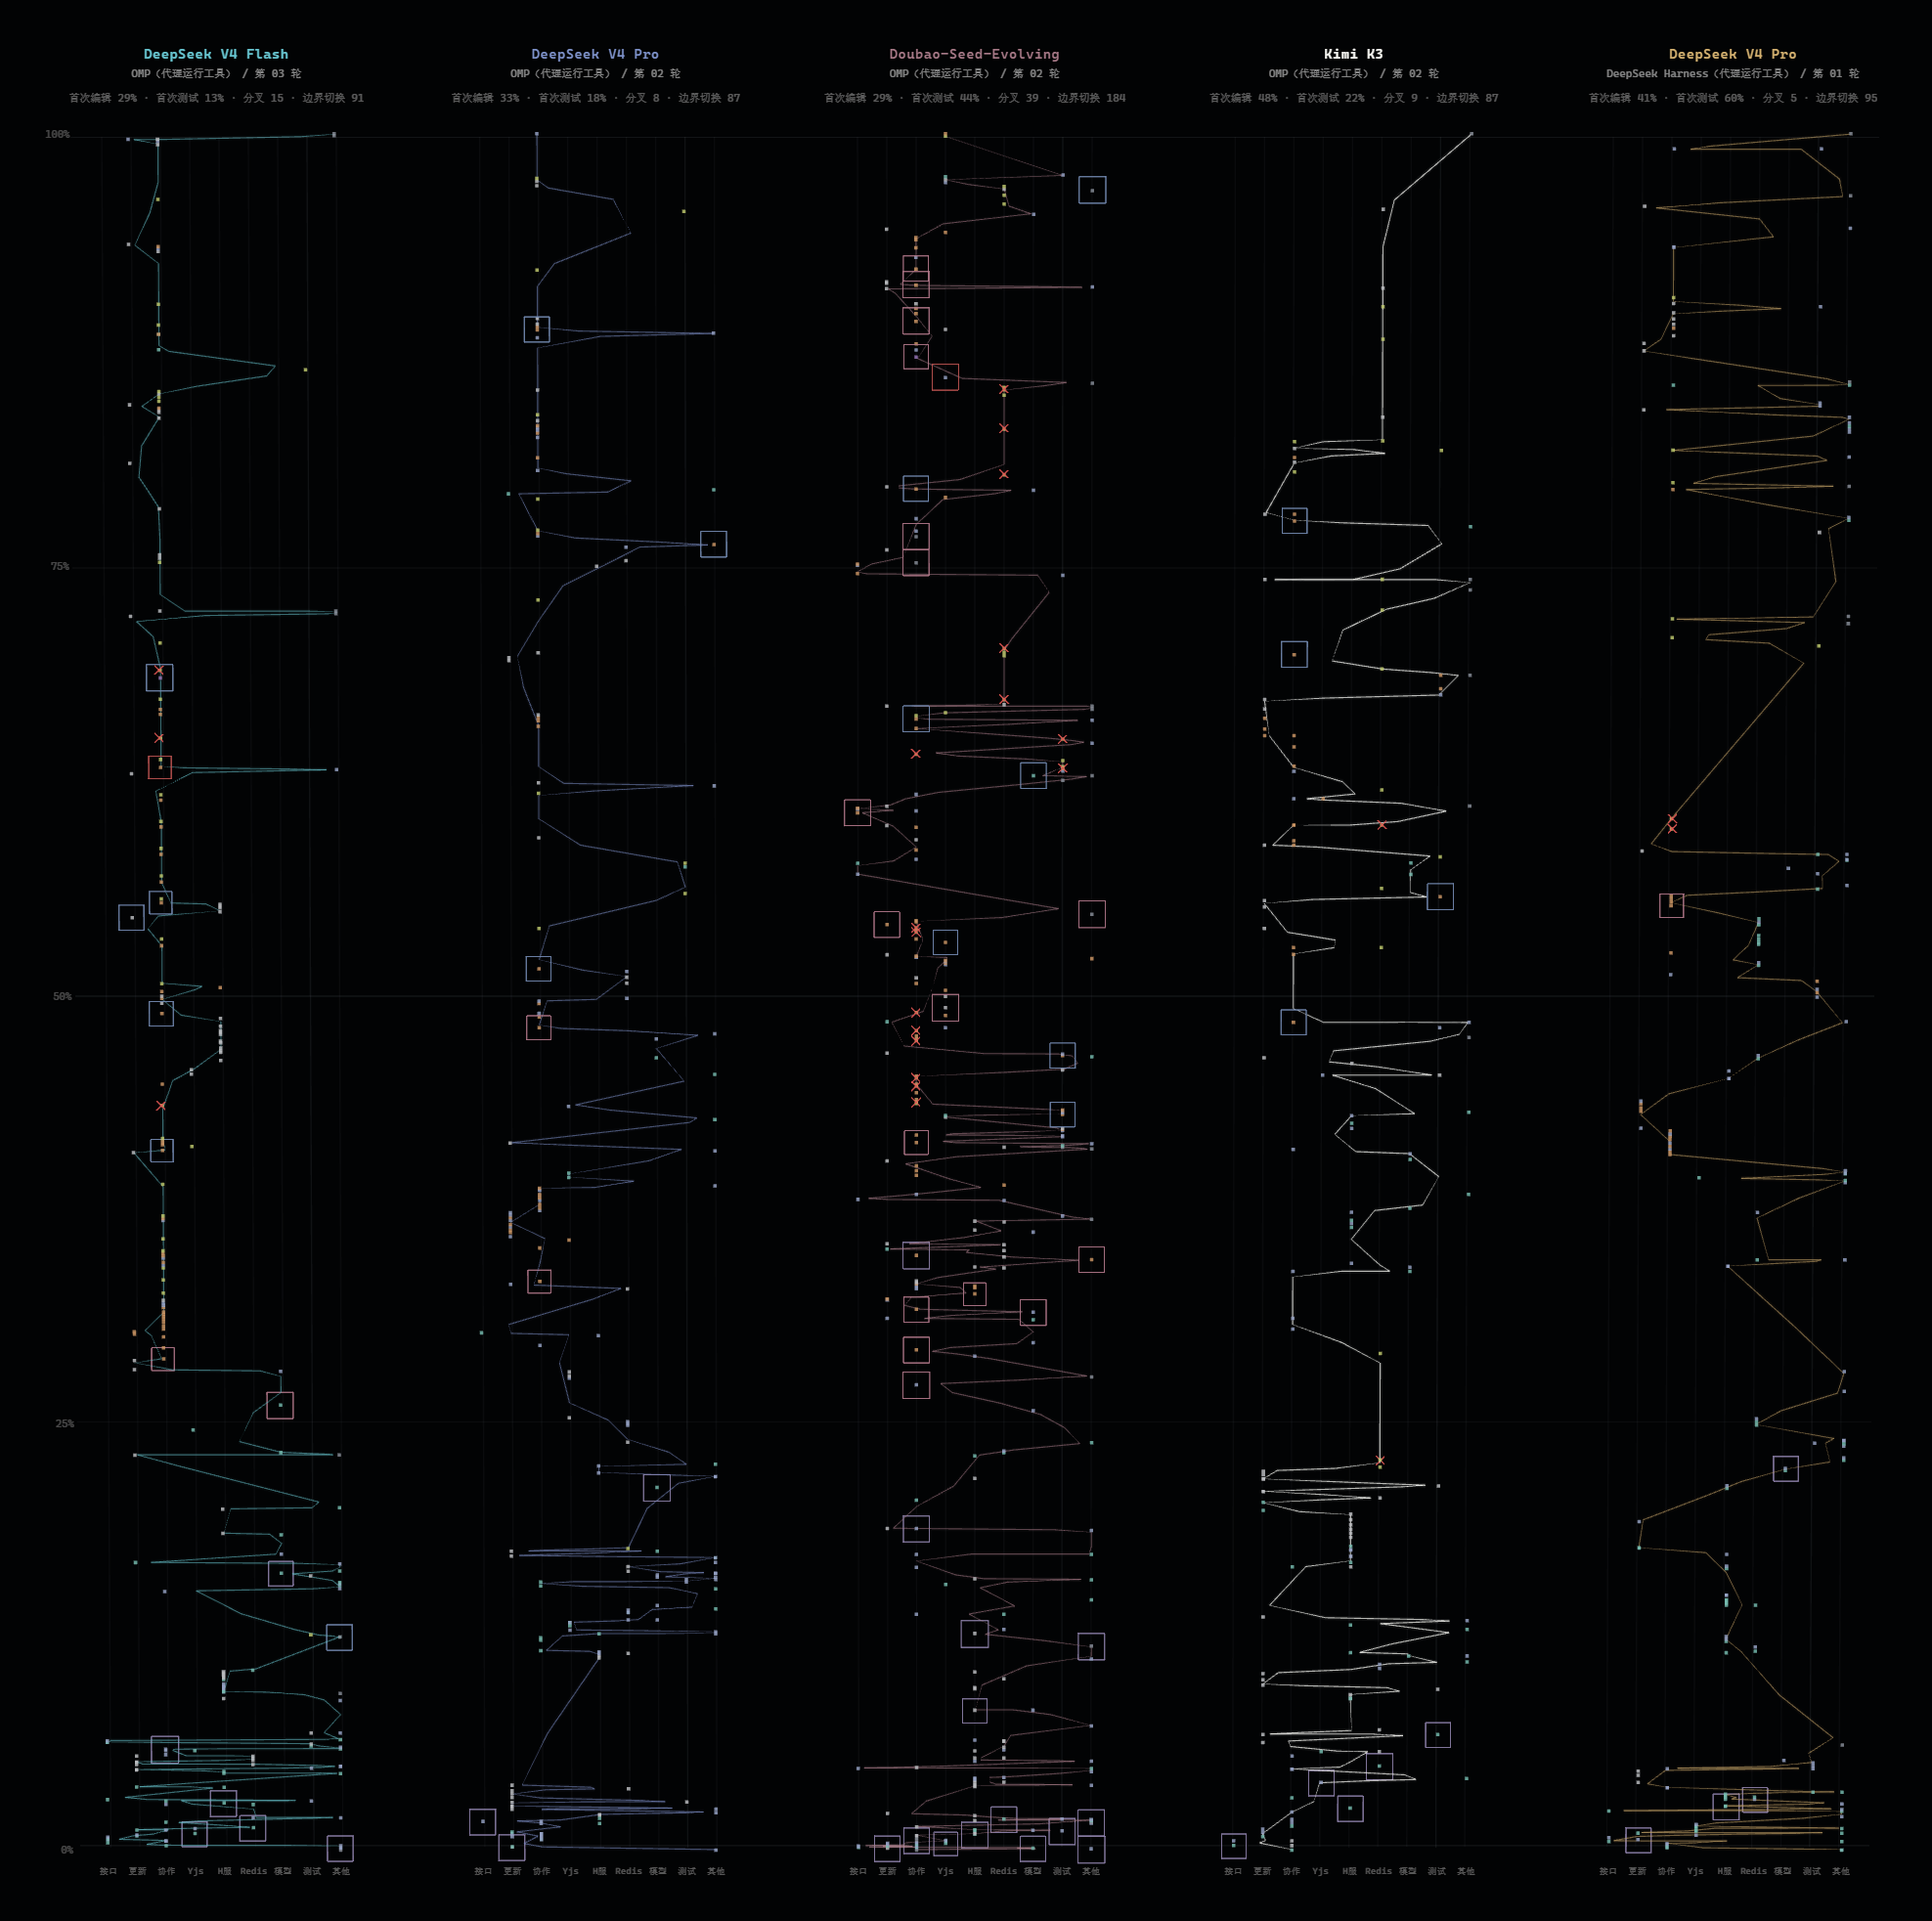
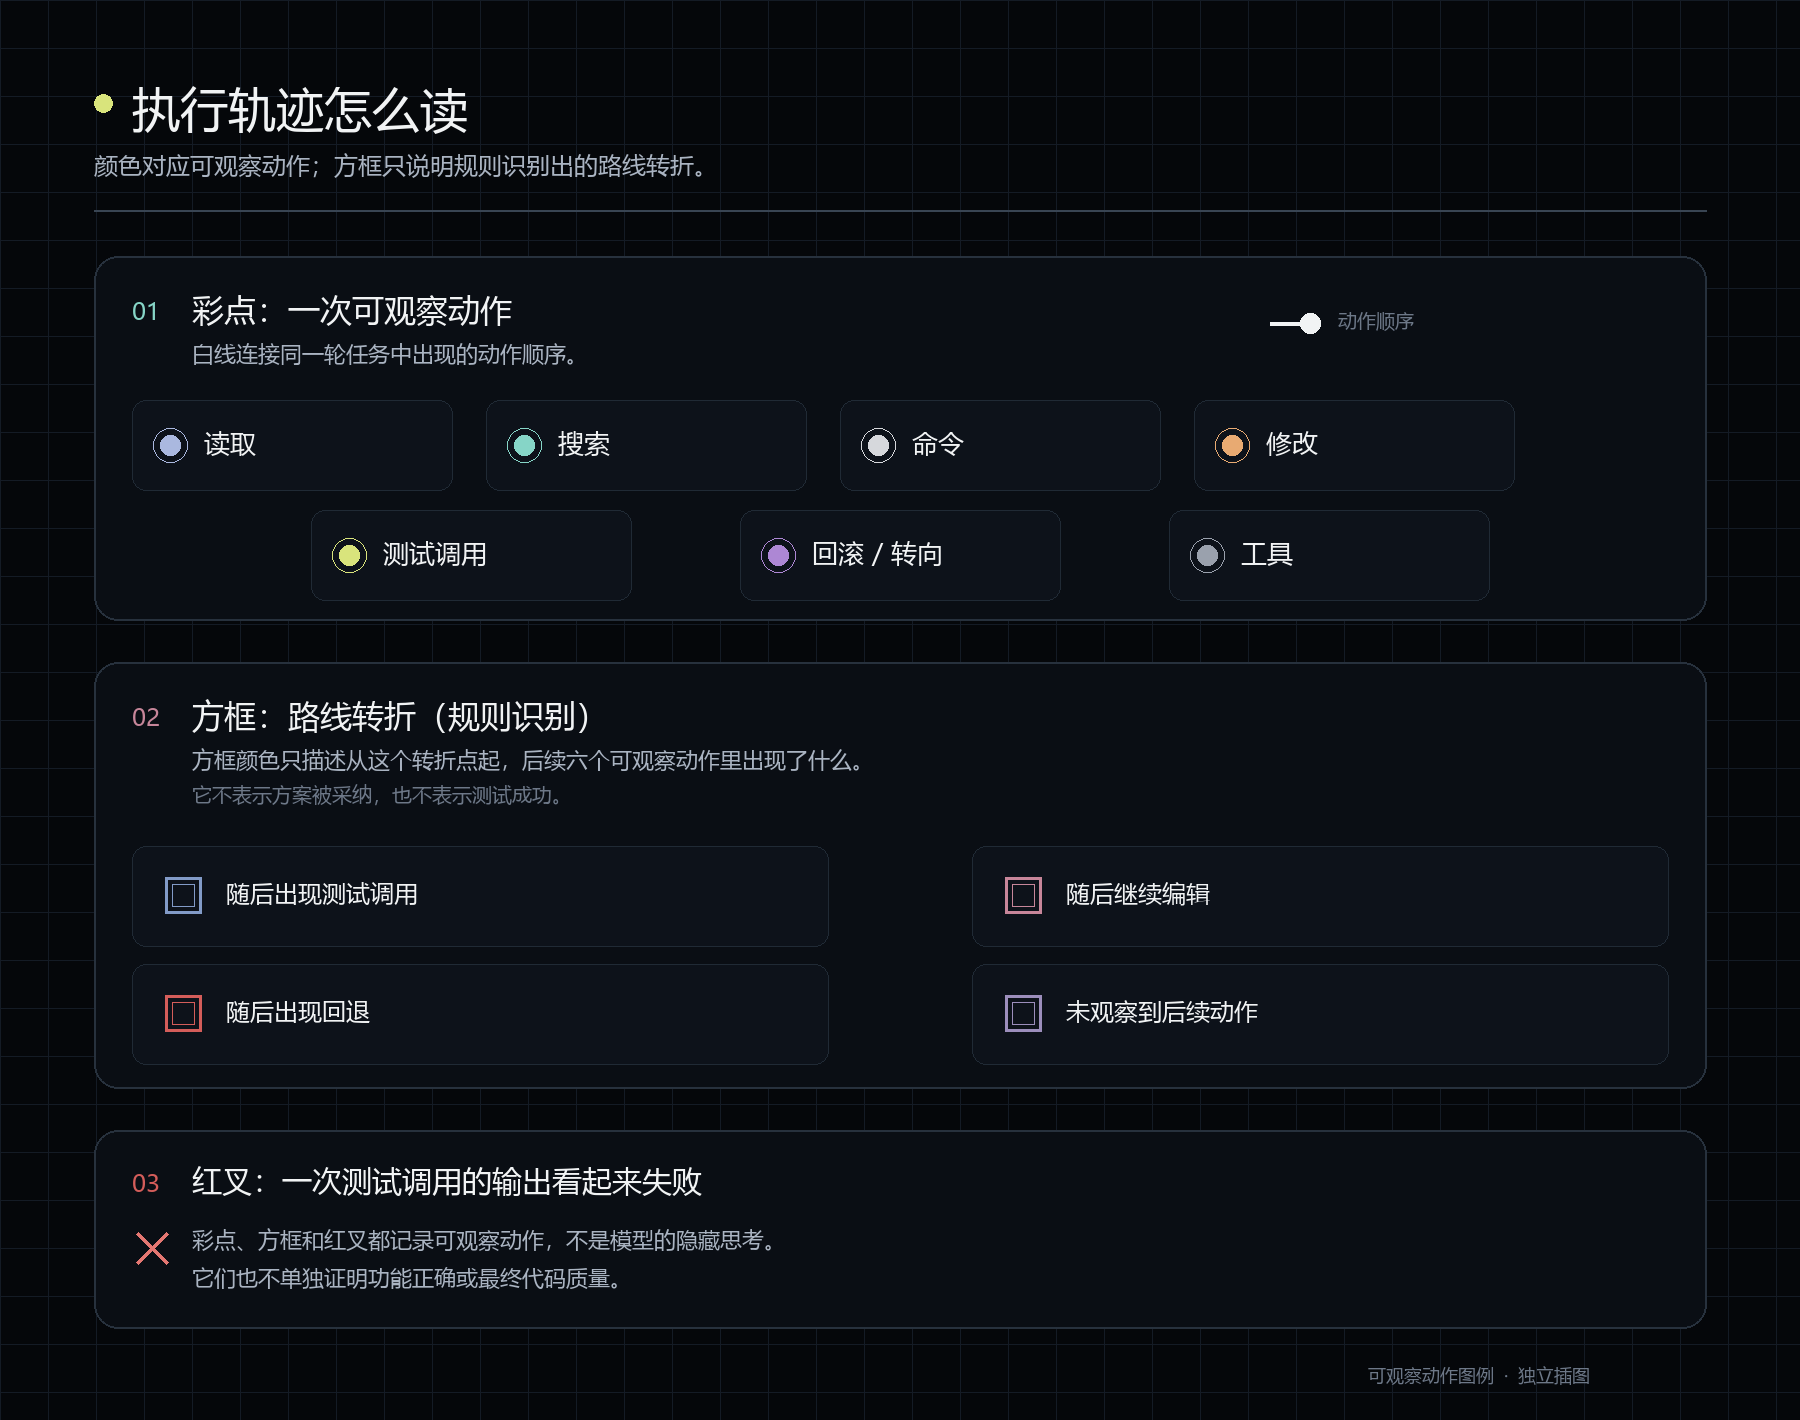
这个轨迹图中,有很多的颜色、点点、甚至红叉,其实只需要先认清几个符号:
- 彩色点:一次可观察动作,例如读文件、搜索、改代码、运行命令或测试。
- 方框:程序按规则识别出的路线转折,例如失败后回退、改换方向,或者走到这里后没有继续行动。
- 红叉:日志中识别到的一次失败事件,可能来自输出、调试或测试。
图的纵向从下往上,代表这轮操作从开始走到结束。
横向是接口、更新逻辑、协作代码和测试等九个工程区域。轨迹左右跳动,说明模型正在不同区域之间切换。
普通读者不用数每个点,先看四件事就够了:
它什么时候开始改代码?
前半段是在调查,还是已经上手尝试?
红叉出现得多不多,失败后有没有调整路线?
整条路线是在逐渐收敛,还是一直来回跳?
这样再看几条轨迹,模型之间的“做事习惯”就很直观了。
比如看最底下这一点,这是任务最开始时候模型的动作:
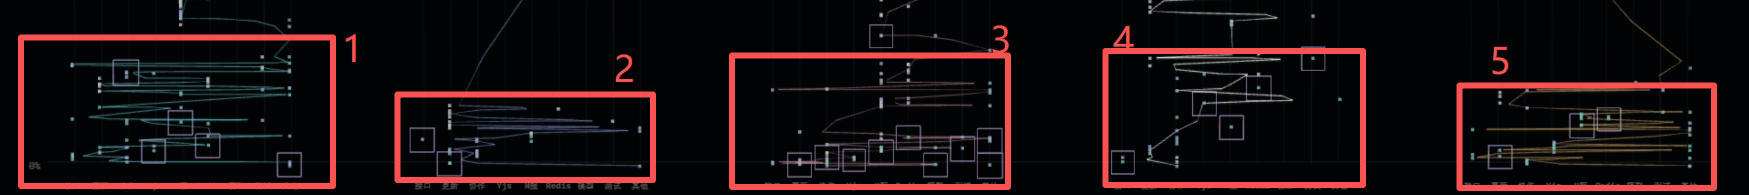
其实打眼一看,可以发现这几个模型,都在开始阶段频繁的来回转折,也有点多彩色点,这就意味着:模型基本都会读取文档、搜索相关代码、梳理背景,然后也会探索和思考不同的路线方法,「1、2、3、5」都明显的会不同程度的调研,再行动。(因为折线很频繁,代表着不断思考不同的方法、查看了很多的文件)
只有4号的K3模型,一开始先笃定了一个方向,没有过多的步骤点在执行。(前几步,是较少的转折)
好,相信你已经看懂了,学会看这个图了,下边就好说了。
5 个模型加一条 Harness 对照,我看到的四个差异
DeepSeek Pro 相比 Flash 提升非常明显
无论在 Oh My Pi 还是 DeepSeek Harness 的代表轨迹里,DeepSeek V4 Pro 出现的红叉都比 Flash 少。
结合三轮最终结果看,Pro 在这次任务里的稳定性也有明显提升。
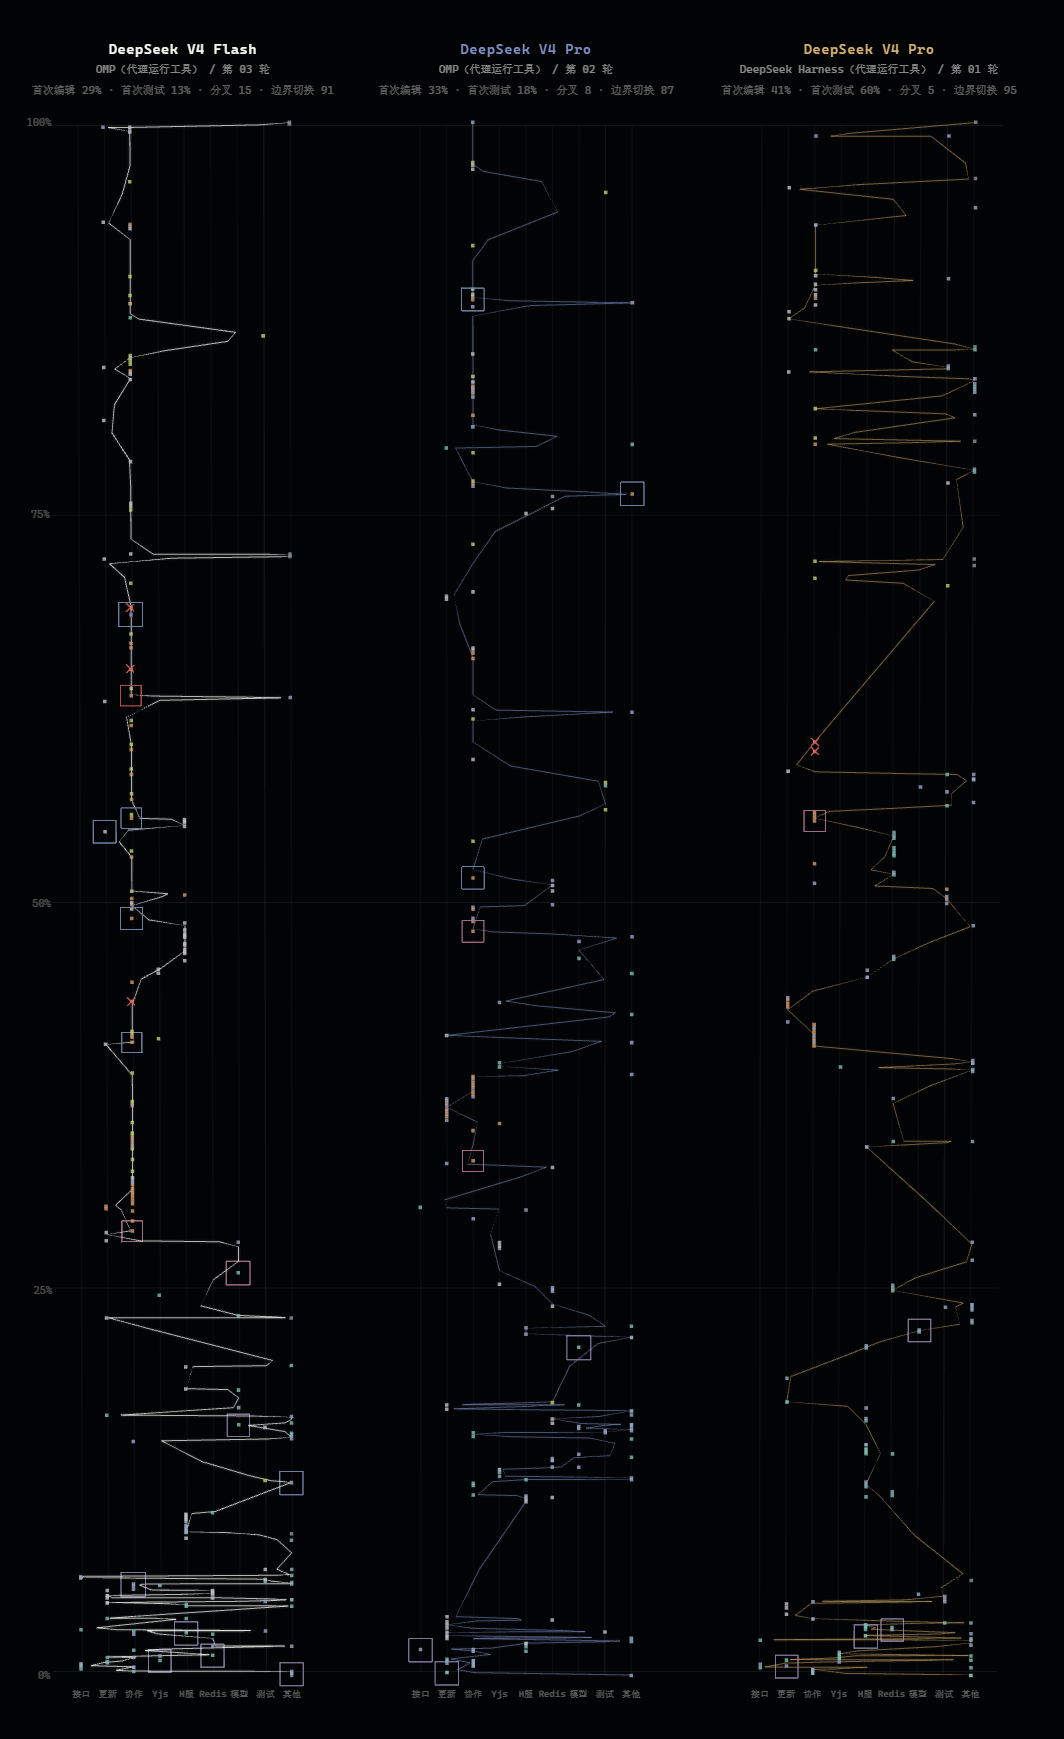
红叉数量会受到测试调用次数影响,单独拿它无法排出一个通用榜单。但它和最终结果放在一起看,能够帮助我们判断:模型是比较顺利地完成任务,还是在反复试错后勉强走到终点。
Kimi K3:前半段先读、先搜,动手最晚
Kimi 是几款模型里开始修改最晚的。
我们在最初期看到K3就是比较少的执行落点,这也提现到了整体任务上,Kimi K3表现的更加谨慎,相比其他模型,K3发出查看文件的指令甚至都会谨慎些。
它在前半段做了大量阅读、搜索和检查。整轮可观察动作走到约 48% 时,它才先修改测试文件;22 次修改中,有 21 次发生在整条轨迹的后半段。三轮运行首次修改位置的中位数是 48.5%。
基本都是在确保测试无误后,才开始修改代码文件,表现的非常谨慎。
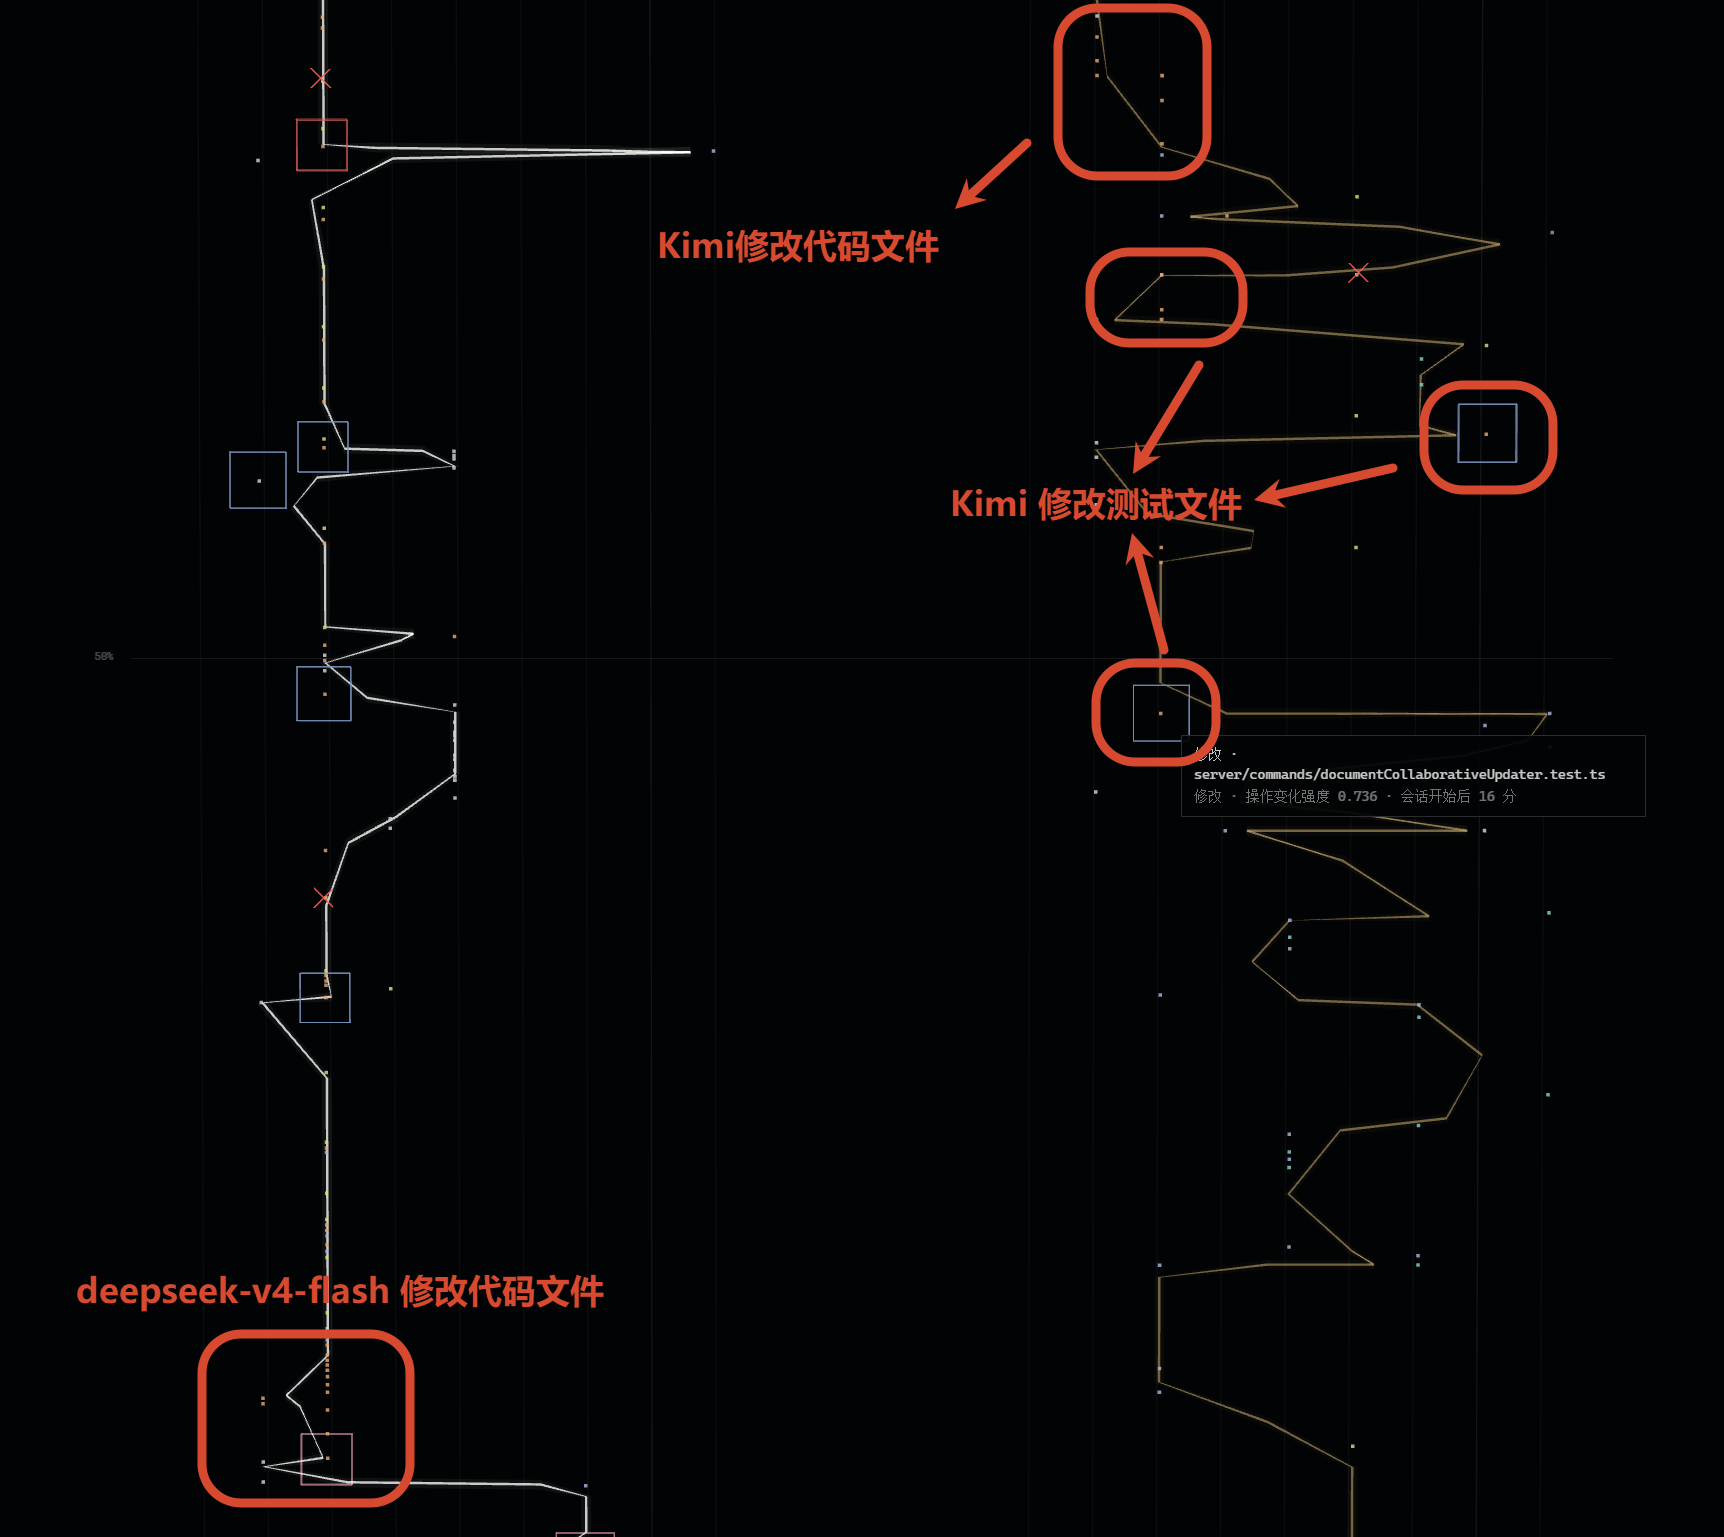
它很像那种接到任务后先把资料和边界查清楚,再集中写代码的人。这个数字不能直接证明结果一定更好,但它清楚地展示了 Kimi 在本次任务里的执行风格:谨慎,前期调查多,修改更集中。
Doubao:动作最多,工程区域切换也最频繁
Doubao 的一条代表轨迹里共有 293 个动作,在不同工程区域之间切换了 184 次,都是几条模型轨迹里最多的。作为对比,GLM 的代表轨迹共有 180 个动作。
所以 Doubao 的轨迹看起来最密、最碎:搜索一个方向,试一下,遇到问题再切到另一个区域继续尝试。
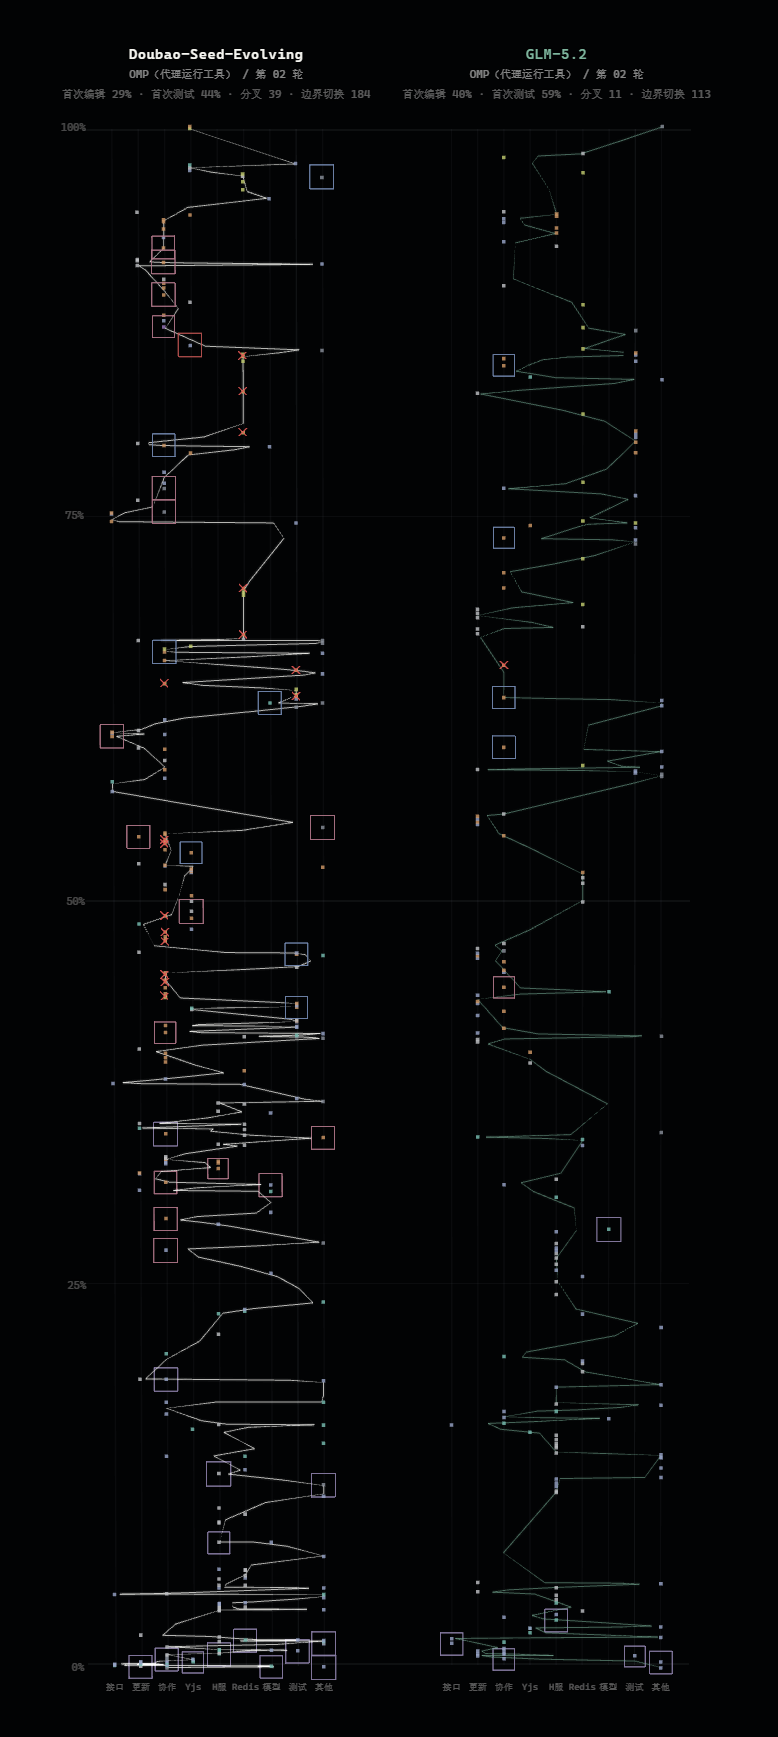
动作多不等于能力更强,它体现的是更高频的探索和试错。这样的路线能不能带来更好的结果,还要结合最终修复情况、Token 消耗和执行时间一起判断。
这和我日常使用豆包时感受到的“短平快、愿意多试几个方向”能对上。不过这次测试只覆盖了一个代码任务,也没有涉及 VLM,因此无法用它评价豆包的全部能力。
同一个 DeepSeek V4 Pro,换了 Harness 后路线也变了
换到 DeepSeek Harness 后,DeepSeek V4 Pro 明显更加偏向先读、先搜。
这条代表轨迹的前 41% 基本都在调查。首次修改前共有 96 个动作,其中 92 个是阅读或搜索,直到后半段才逐渐开始修改和测试。
这说明真实 Agent 的表现,需要把模型和 Harness 放在一起看。Harness 会影响模型能使用哪些工具、拿到什么上下文、按什么节奏推进任务。模型相同,工作台和执行规则变了,最后呈现出来的做事方式也会改变。
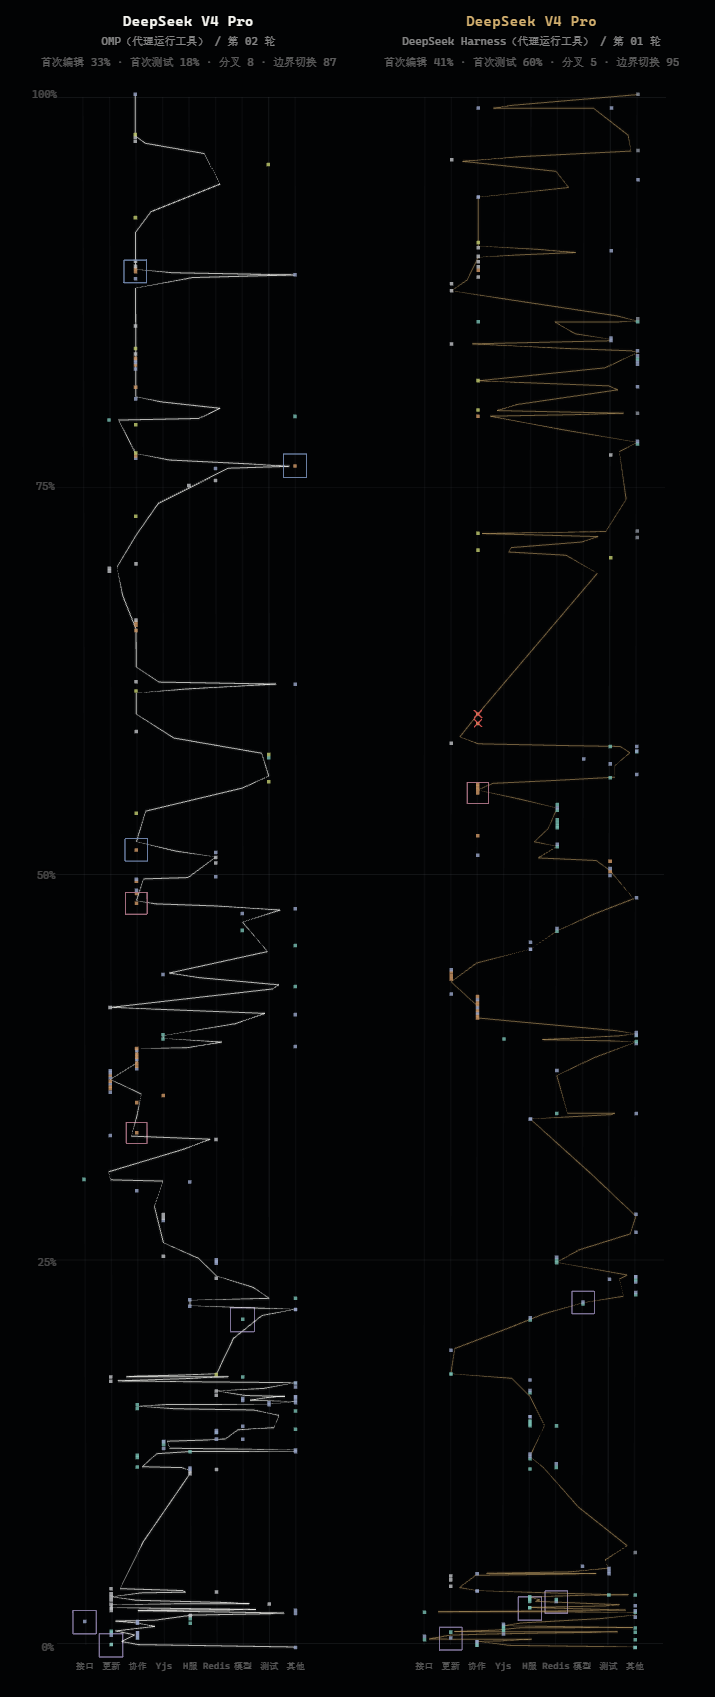
目前 DeepSeek Harness 仍处于预览阶段,也支持进一步定制。对企业 Agent 和 Workflow 来说,这一部分和模型本身同样重要。
最后,给这 5 个模型定个调
如果只根据这次任务给它们做一个定位,我会这样记:
DeepSeek V4 Pro:稳健主力
多次运行的情况下执行最稳定。它通常会先花时间把问题看清楚,再集中完成修改。遇到内容比较多、需要同时调整多个地方的任务,我会优先让它先试一轮。
Kimi K3:谨慎派
Kimi 动手最晚,前半段阅读和检查更多,修改集中在后半程。适合要求清楚、结果容易核对的任务。
DeepSeek V4 Flash:快攻手
Flash 上手很快,很早就开始修改,倾向于边改边检查,能较快产出第一版,适合想尽快拿到第一版的任务,不过质量上需要更多把关。
GLM-5.2:状态型选手
整体路线相对均衡,但是并不稳定,其中一轮表现亮眼,另外两轮属于平均水平,在有现成资料可以参考时,能很快找到方向。日常写方案、整理资料、修改已有内容,都可以先让它多跑两版。
Doubao-Seed-Evolving:高频探索派
动作最密,探索方向多,区域切换频繁,整个过程也最忙。这个特点也让他非常适合搜索场景,所以我觉得豆包APP 能火,符合大众的使用习惯,跟豆包模型在执行上一个劲尝试也有关系,这就非常适合短平快的任务,硬着头皮也得尝试各个方向去解决、回答用户问题。。。
它更适合目标清楚、步骤可以拆开、结果方便逐项检查的短任务。
这份定位只对应本次真实代码任务,覆盖不了写作、搜索和多模态等全部能力。
但它已经让一个问题变得很清楚:
同样是把 Bug 修好,有的模型先调查再动手,有的快速试错,有的不断换方向。最终得分相同,背后的可靠性和监督成本可能差得很远。
更有意思的是,同一个 DeepSeek V4 Pro 换到 DeepSeek Harness 后,执行路线也发生了变化。
做 Agent 时,模型决定基础能力,Harness、工具、上下文和反馈机制共同决定最终表现。以后企业选择 Agent,也不能只问用了哪个模型,还要看它被放进了一套什么样的工作环境。
结果表回答它能不能做完。
轨迹图回答你敢不敢把更长、更贵、更难回退的任务交给它。