豆包2.0(Doubao-Seed-2.0)年前发布,通常我们都是首发,这次赶了个“晚集”。
但,好饭不怕晚,这篇是有备而来。
在豆包大模型 2.0 发布前,我们词元团队就已经与官方深度合作,将 Seed 2.0 真正接入到企业级 Agent 架构中,去解决真实世界里的复杂问题。
比如本次官方发布中使用的:用OpenClaw和飞书搭建智能客服。
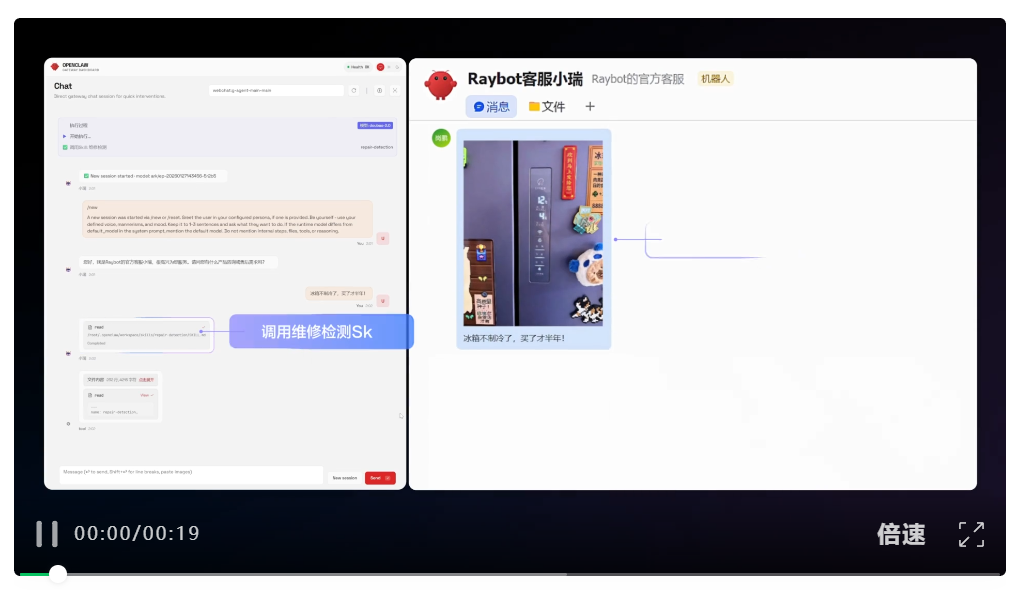
这是我们的实战 Case 之一,除此之外,我们还进行了大量深度的场景跑通。甚至,我们还利用 Seed 2.0 驱动,跑通了“一人公司”从内容营销到产品交付闭环的全流程自动化。
今天,这些硬核 Case 一并分享给大家。
在看实操 Case 前,老规矩,先给新来的小伙伴划一下本次更新的重点(已经了解的可以直接下滑到 Case 1):
Doubao-Seed-2.0 的核心设计目标是提升大模型在真实世界复杂任务(Real-World Complexity)中的表现,特别是在智能体(Agentic)范式下的应用。
- 1. 模型系列与定位
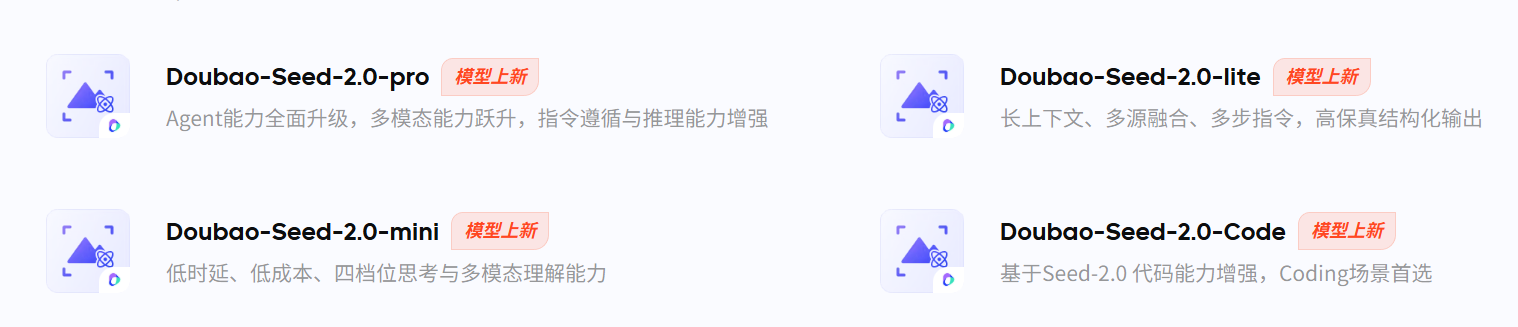
本次豆包模型发布的 Seed2.0 系列模型包括 Pro、Lite、Mini 三个版本,以平衡性能、速度和成本,还有一个专门面向开发者的 Code 模型,专为Coding场景加强:
- Seed2.0 Pro:针对复杂推理和长上下文任务,追求极致能力 。
- Seed2.0 Lite:通用型模型,平衡性能与效率 。
- Seed2.0 Mini:极低成本,适用于高通量、低延迟场景 。
- 2. 核心能力提升
视觉与多模态理解: 视觉推理大幅加强,幻觉显著减少,对文档、图表和混合媒体内容的结构化信息提取能力飙升。
复杂指令执行: 不再单纯依赖事实检索,而是将“可靠执行多步骤复杂指令”作为一级需求。
真实世界智能: 告别纯“做题家”,从解决“奥数竞赛”转向科研、工作级别的实际推理。
长尾专业知识: 系统性摄入专业领域知识,弥补了模型在特定职业背景下“不够懂行”的短板。
- 3. 性能指标(Benchmark 表现)
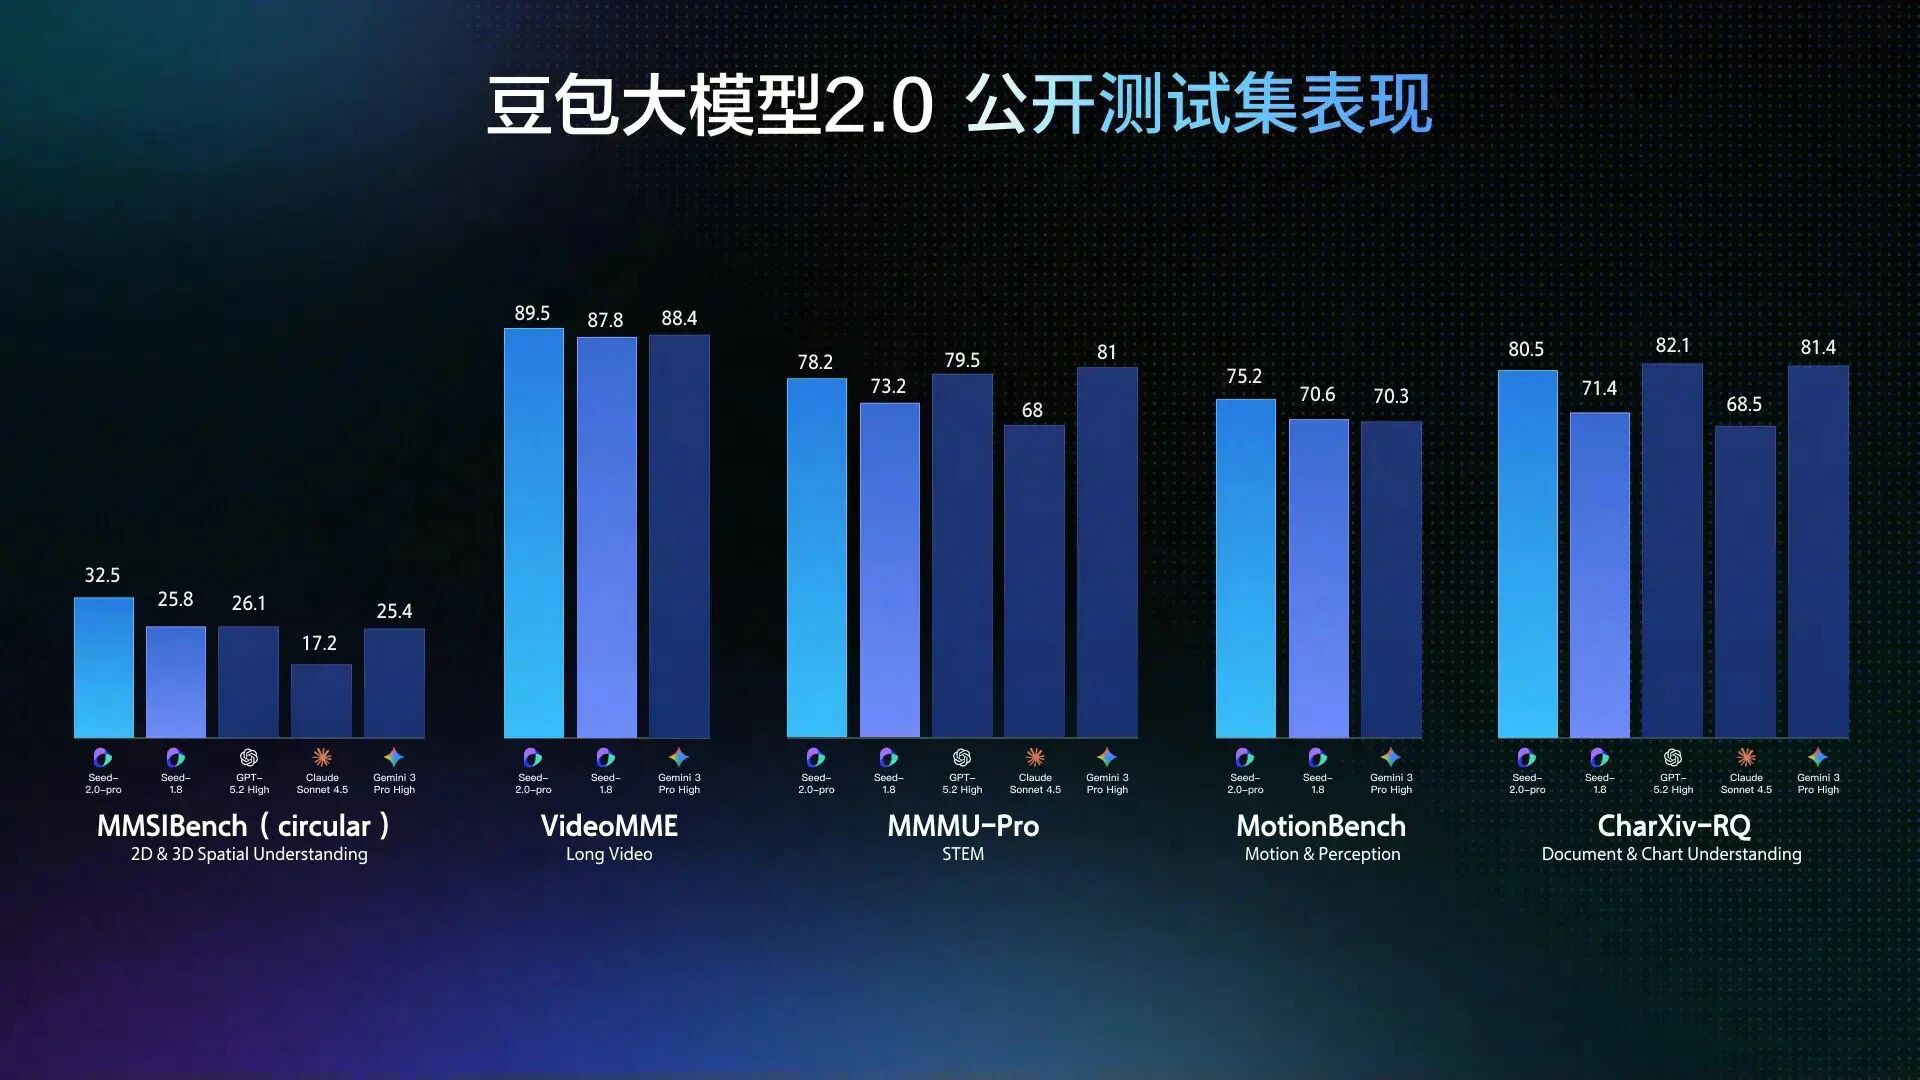
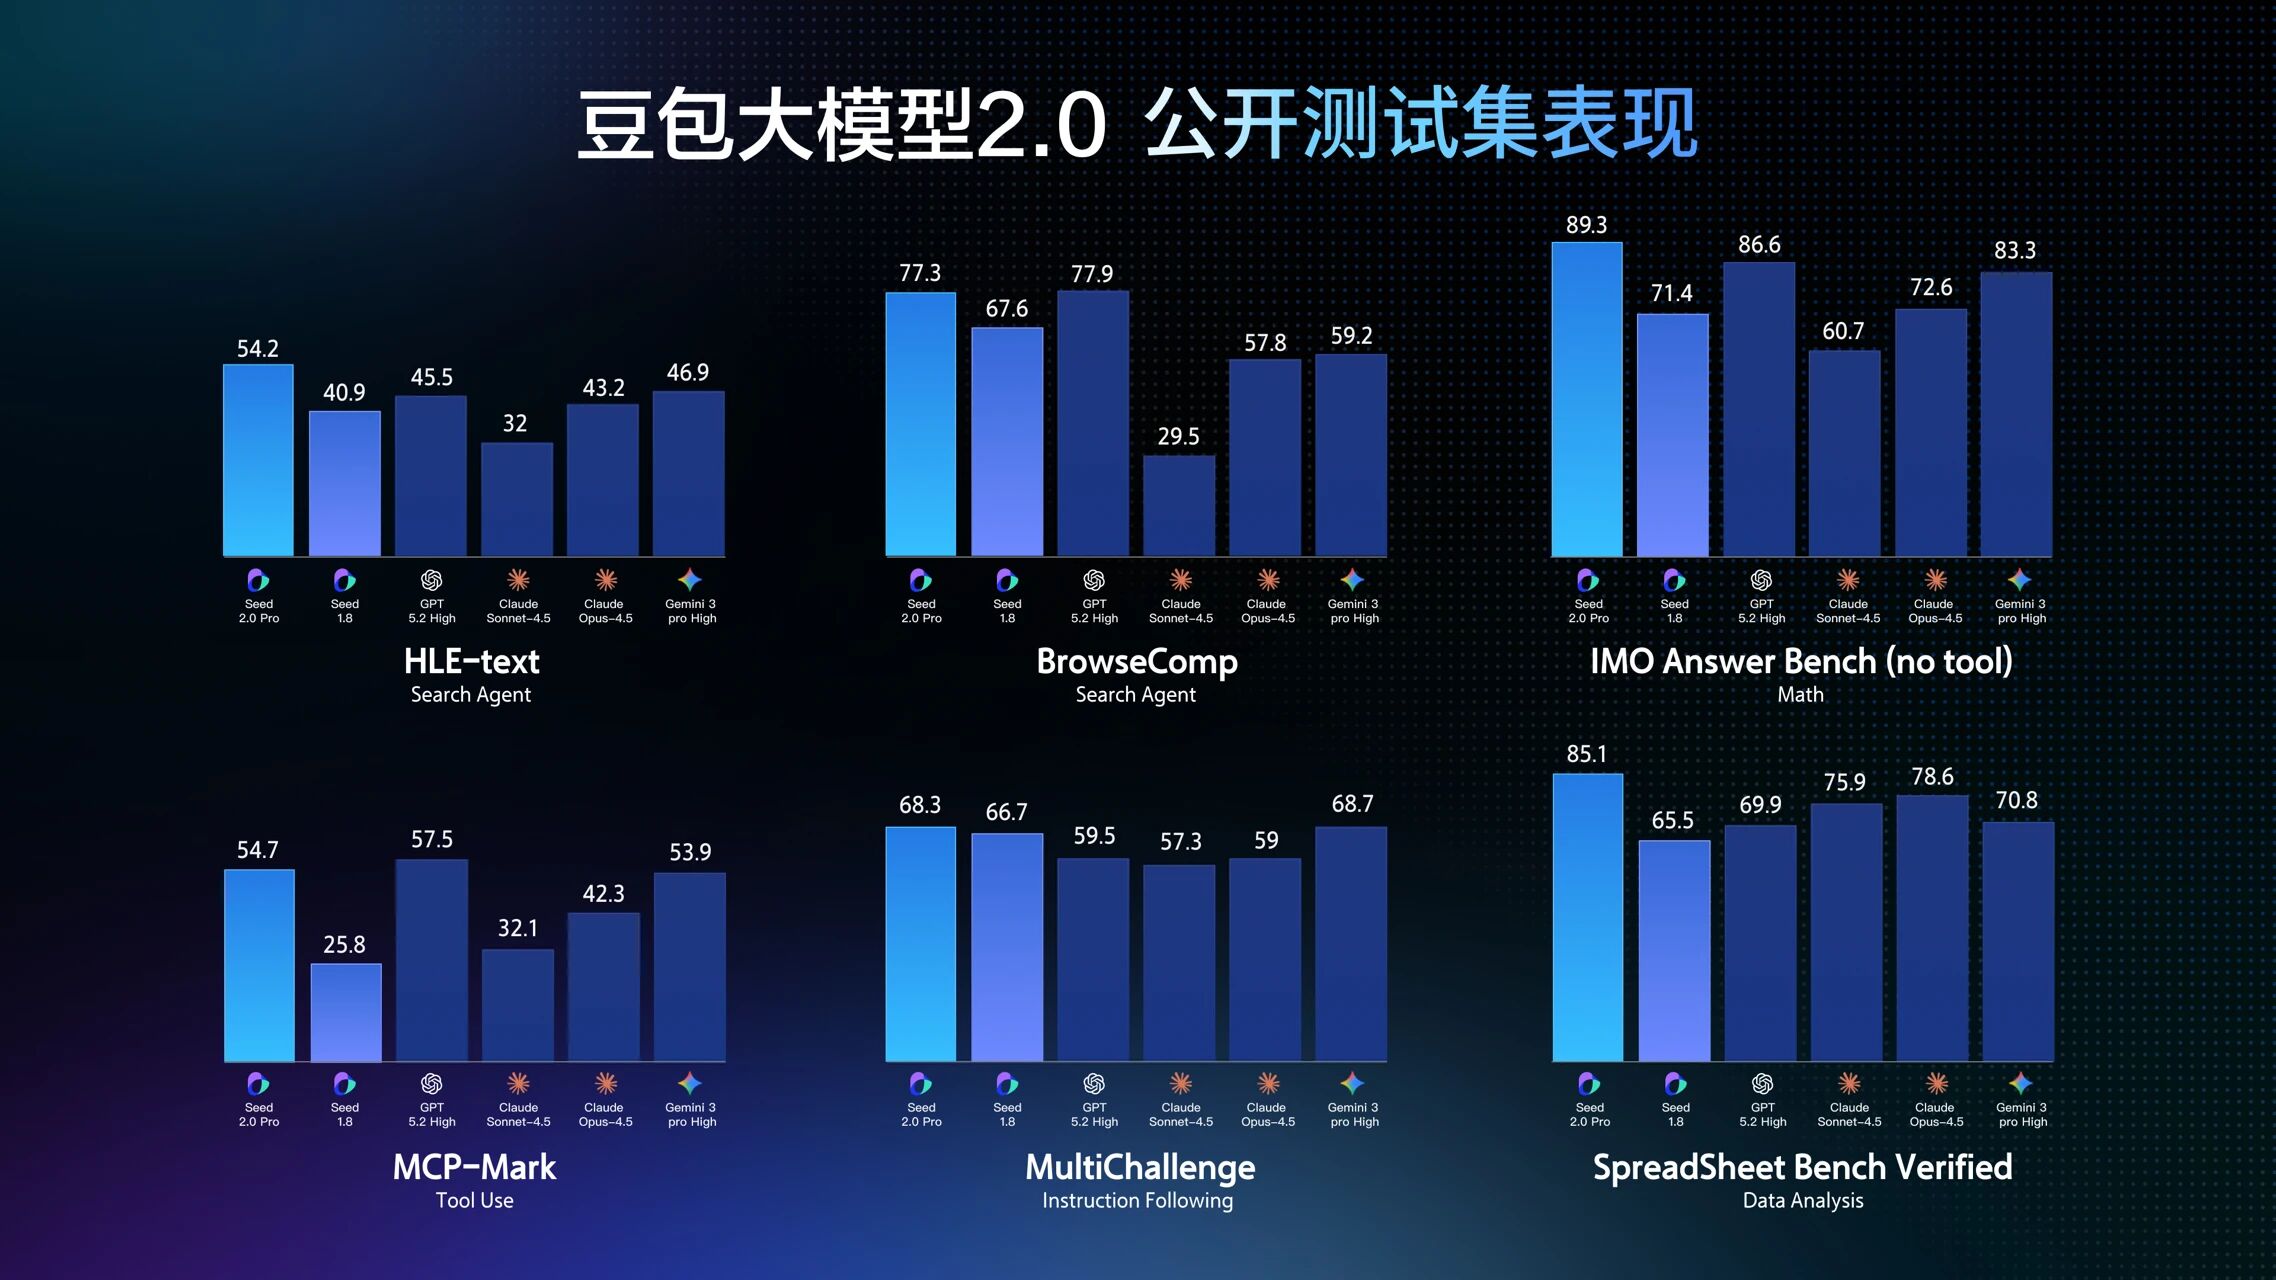
Seed2.0 Pro 在多个权威榜单上位居世界前列:
- 数学与编程:在 AIME 2025、HMMT 2025 等数学竞赛中表现优异 。在 2025 年国际奥数(IMO)和中国数学奥赛(CMO)中达到金牌水平 。Codeforces Elo 分数达到 3020 。
- 视觉理解:在 MathVision、MathKangaroo 等多个视觉语言基准测试中取得 SOTA(业界领先)成绩 。
- 视频分析:在 VideoMME 长视频理解中达到 89.5 的突破性高分 ,并具备 VideoCut 工具调用能力,可重放关键片段以精准识别动作 。
- 智能体能力:在搜索智能体(Search Agents)、深度研究(Deep Research)和视觉智能体任务中表现突出 。
既然本次 Seed 模型的目标是解决真实世界的复杂任务,我们在测试时,也抛弃了“跑分式”的评测,而是直接把它扔进业务流里,把模型代入真实世界场景进行体验,感受模型的综合能力。
硬核Case1:教辅AI校对
大家对教辅,想必都不陌生。但是大家可能不知道传统出版/教辅行业的“三审三校”制度。这是一个为了保证出版物质量的必要流程,但面对一本动辄几十万字的书,人工初校需要数周,成本高昂。且教辅对专业性要求极高,校对人员遇到不确定的物理常数、生僻历史,还需要手动查证,效率极低。
尤其是其中“一校”阶段,充斥着大量纠正错别字、核对常识、格式检查等低效重复劳动,消耗了资深编辑大量精力。
这是一个存在了多年的传统流程,时至今日,依然如此。
于是,我们借助豆包 2.0 强大的 Agent 架构、Grounding(事实溯源)能力、丰富的长尾知识和多模态理解,直接用 AI 接管了这个最耗时的“初校”环节。 让编辑把精力全放在高价值的“二校”和“终审”上。
同时,我们发现教辅引用课本材料时,需要严格与原教材对照,这原本需要人工一一对照保证一致,而AI联网、知识库核查的速度和广度是人类无法比拟的,AI拥有着比人更严谨的事实核查能力,所以我们一并加入了知识库和搜索能力供AI进行核查。直接让AI接管了这部分内容。
这并不是一个简单的事情,他极大的考验着模型本身的世界知识、低幻觉、检索和事实核查能力。
我们开发了工具利用Seed2.0,在用户上传待审校文档后,模型自动完成内容识别和分析:
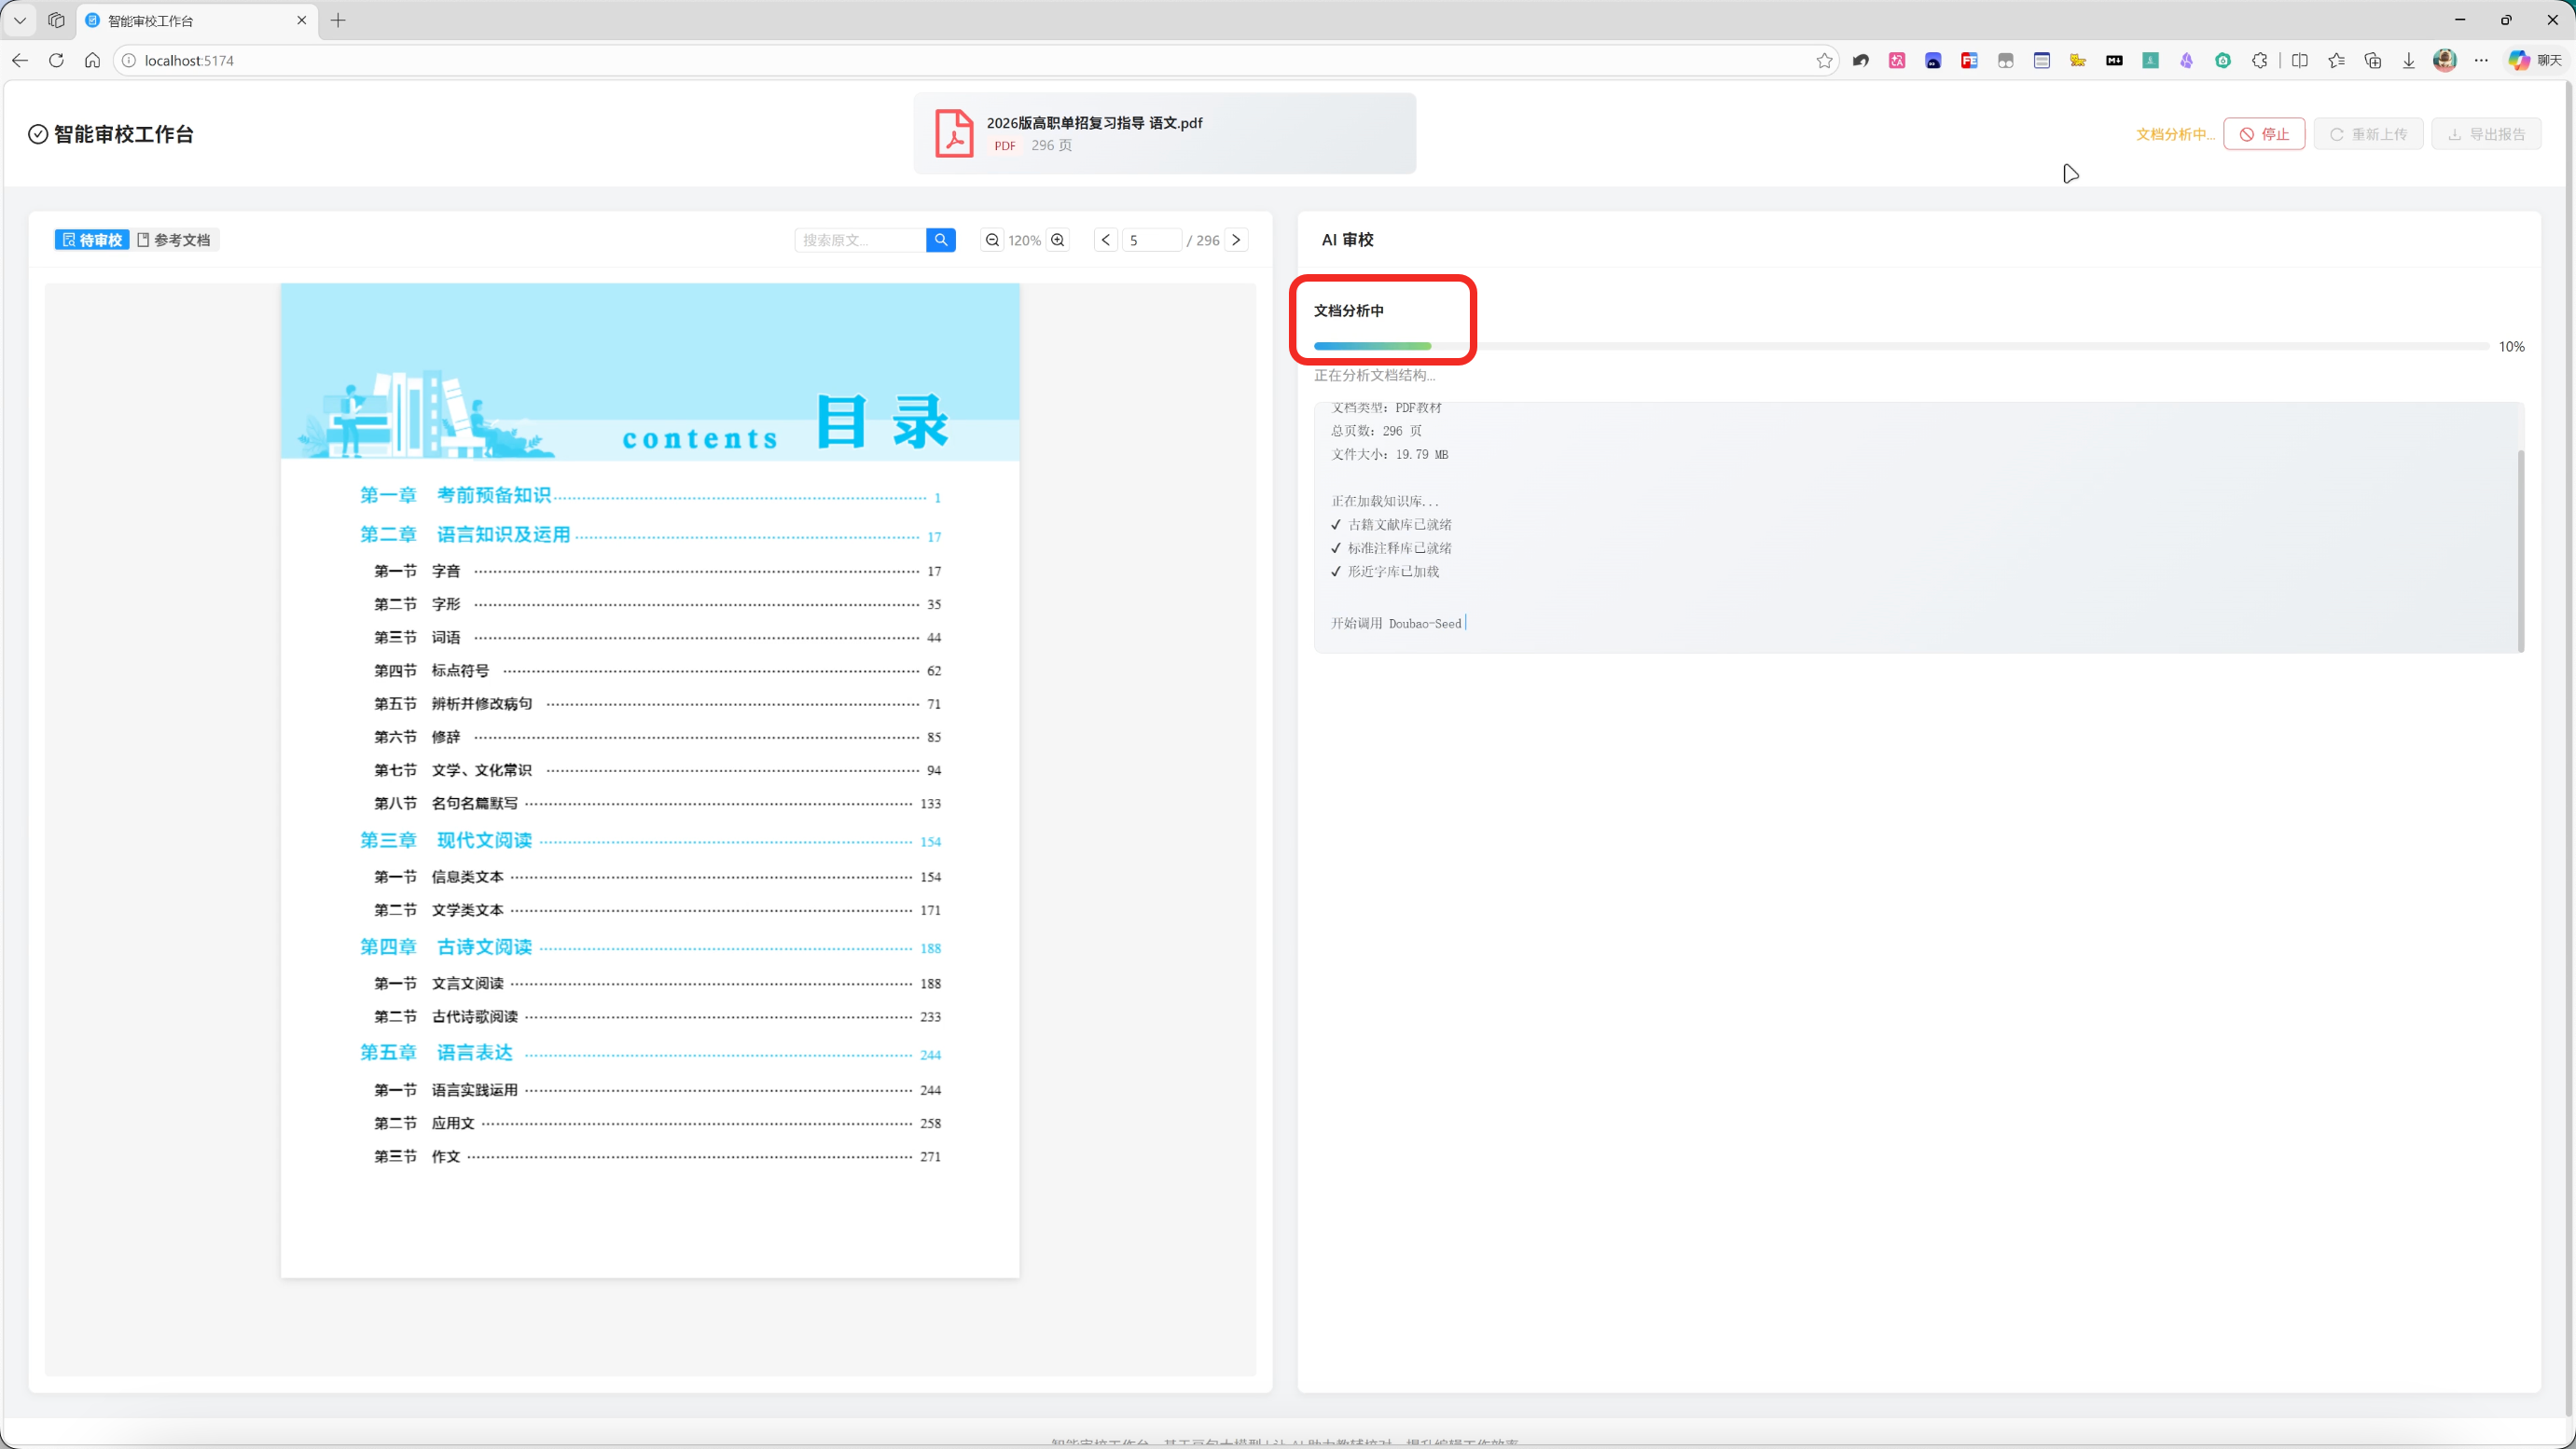
对比知识库和网络知识后,模型输出异常点,并在原文标记,同时支持查看正确的参考文档:
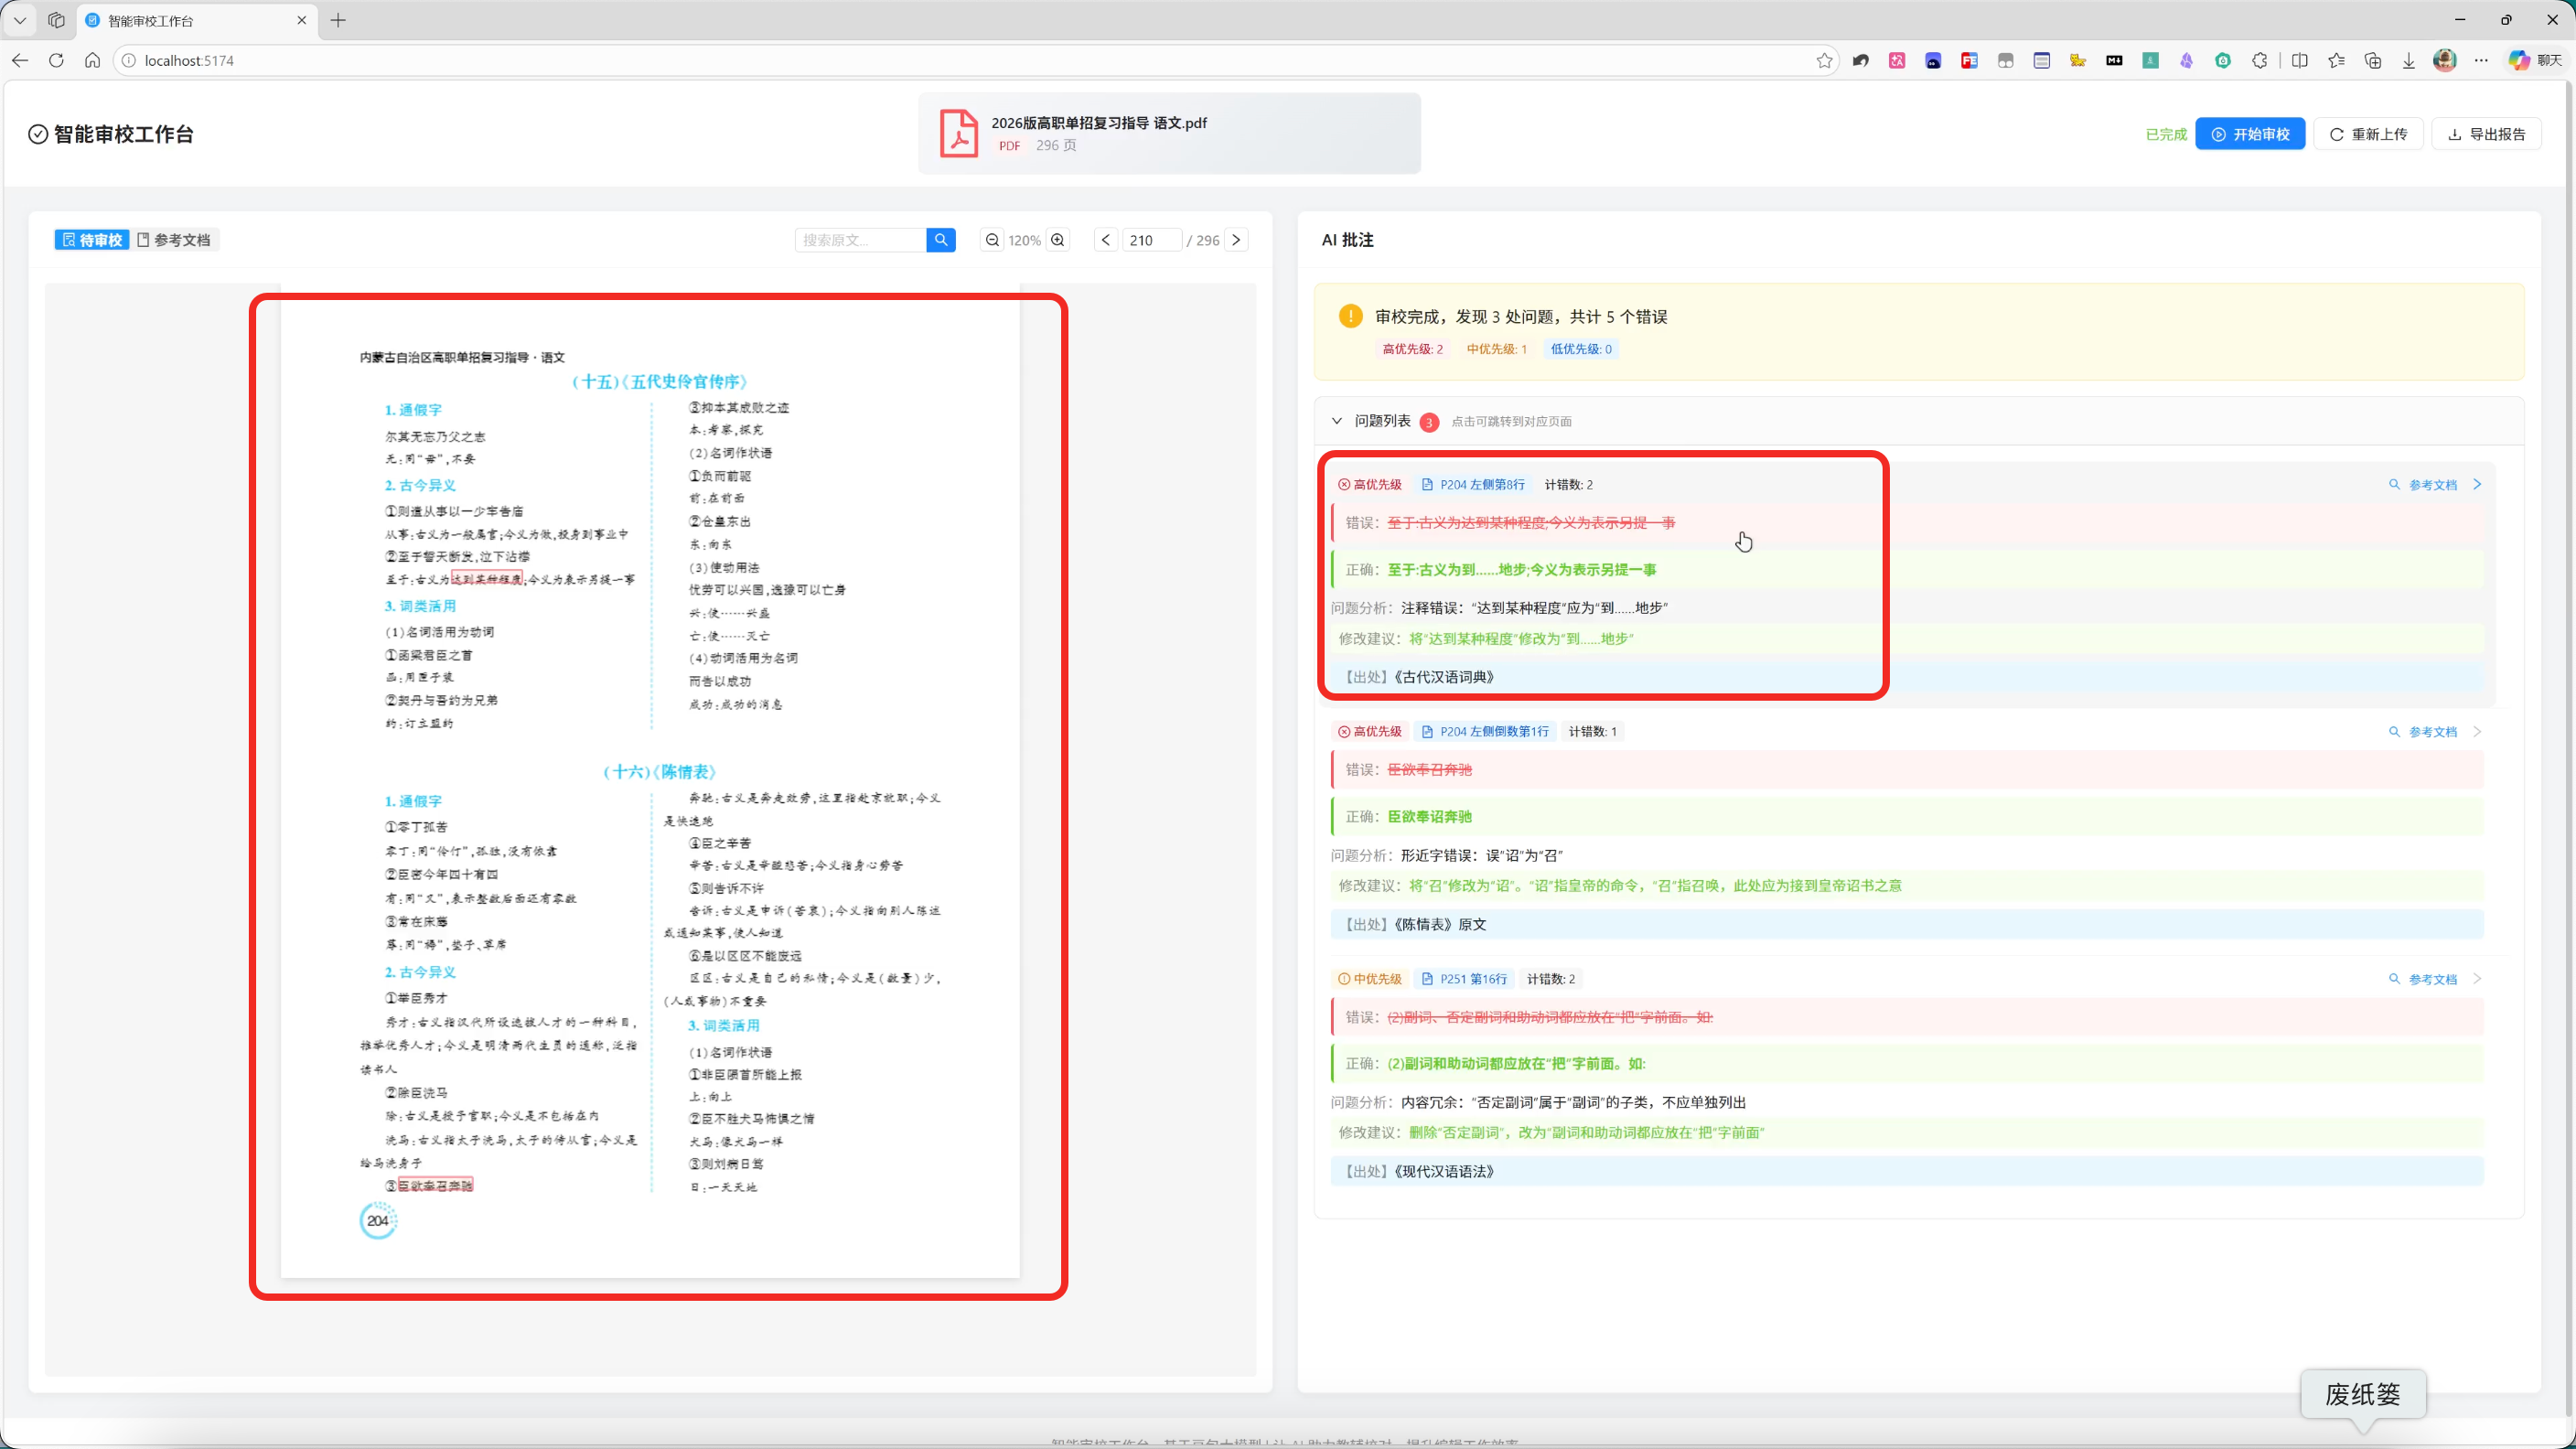
视频中更加详细了展示了整个过程:
豆包 2.0 完美展现了它的商业价值:把人从低效的找茬中解放出来,去做更重要的事情。
硬核Case2:设备监控预警与维修
在工业制造中,流水线的稳定性就是生命,任何环节的宕机都会造成巨大损失。实时的监控预警至关重要。
我们利用豆包的多模态理解、Agent能力结合产线本身的故障数据,模拟了一套“视觉监控+智能诊断+自动派单”的闭环系统。
我们构建的场景如下:使用一个大屏,来展示设备实时画面、备件库存预警、关键运行指标及设备状态。
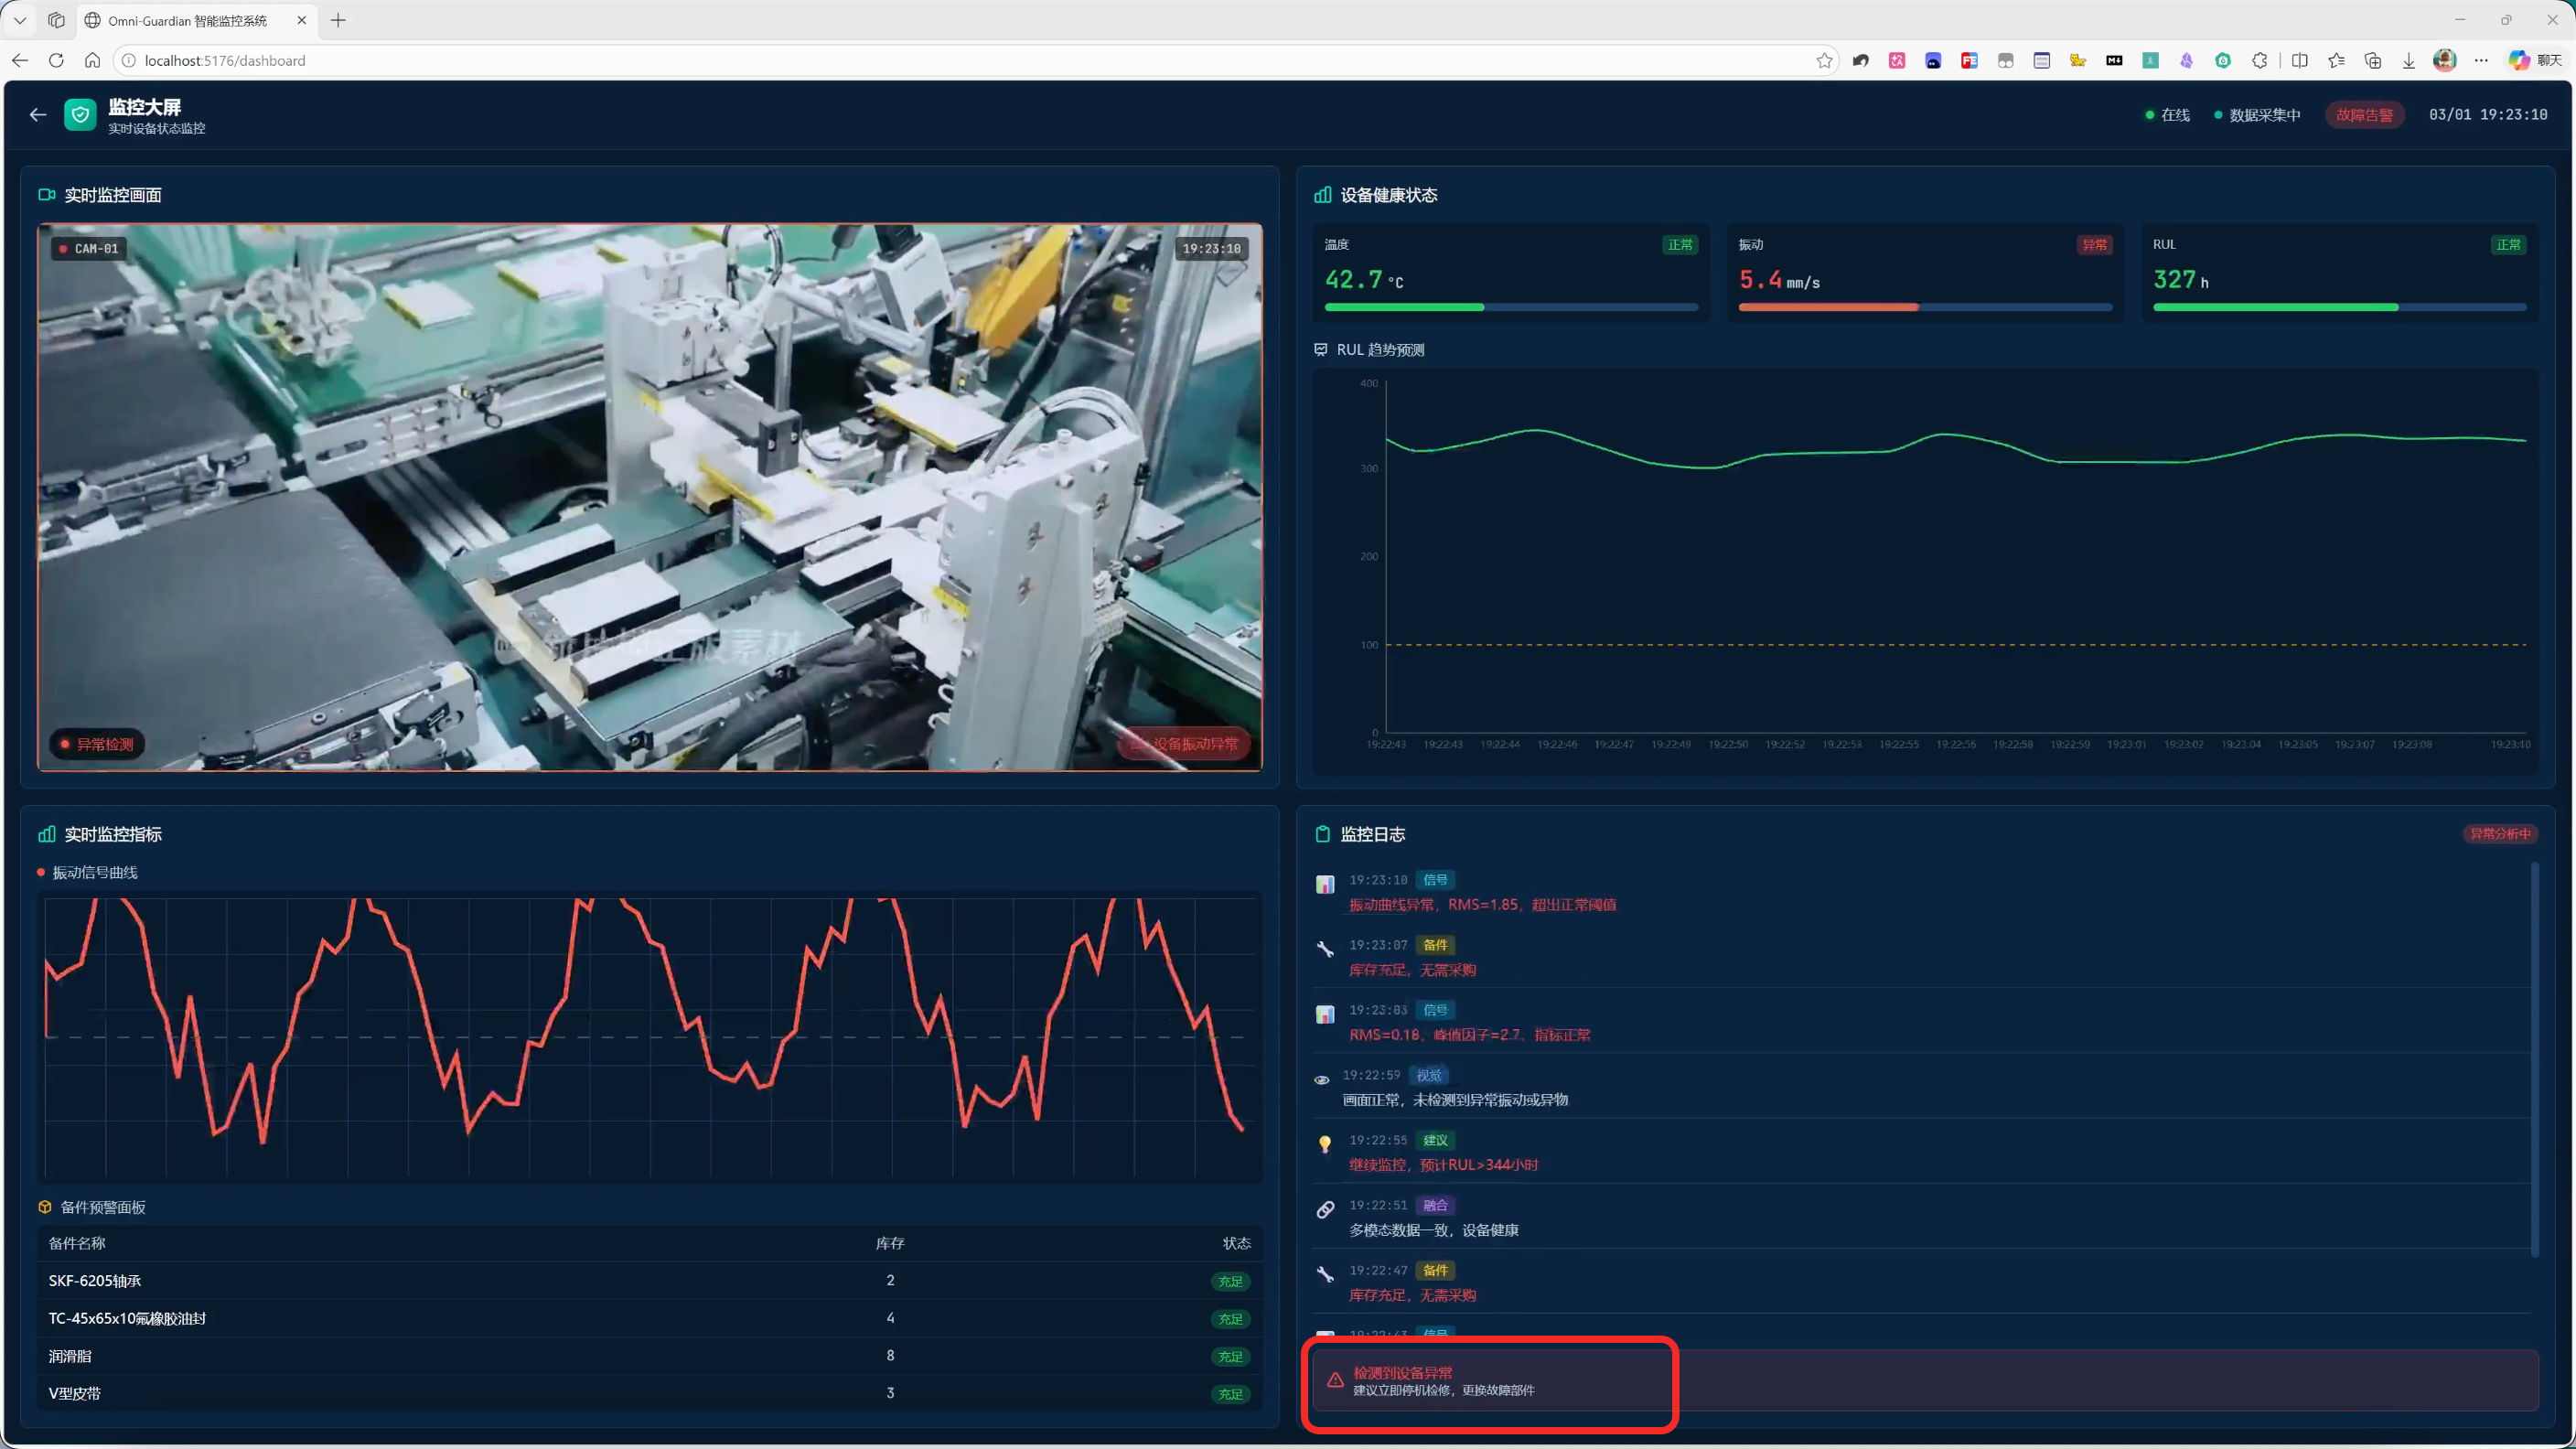
通过大屏,模型可以实时监测设备画面、备件库存预警和关键运行指标。它能基于知识库对视频画面进行一体化分析。一旦发现异常,自动触发告警并直接推送飞书通知。
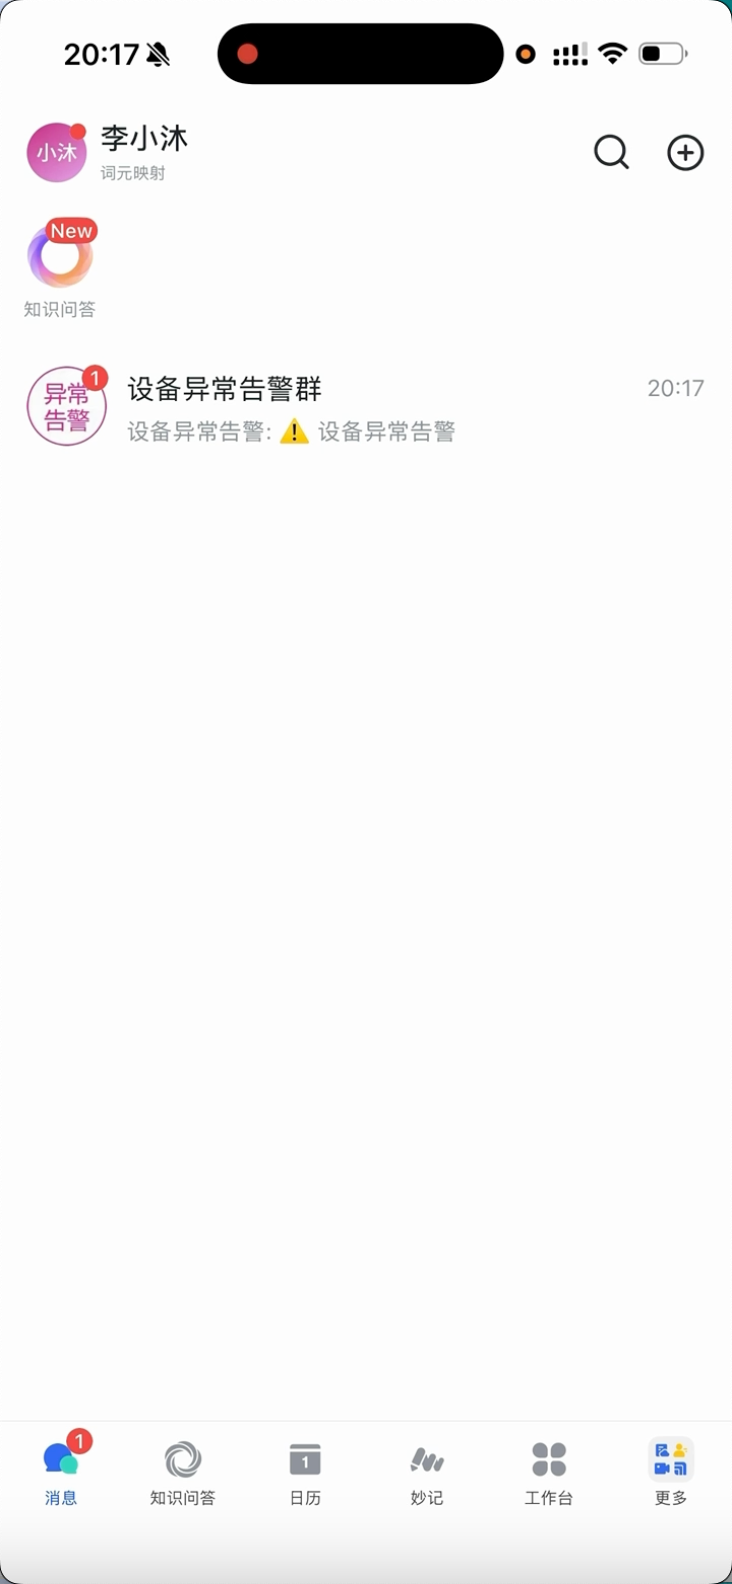
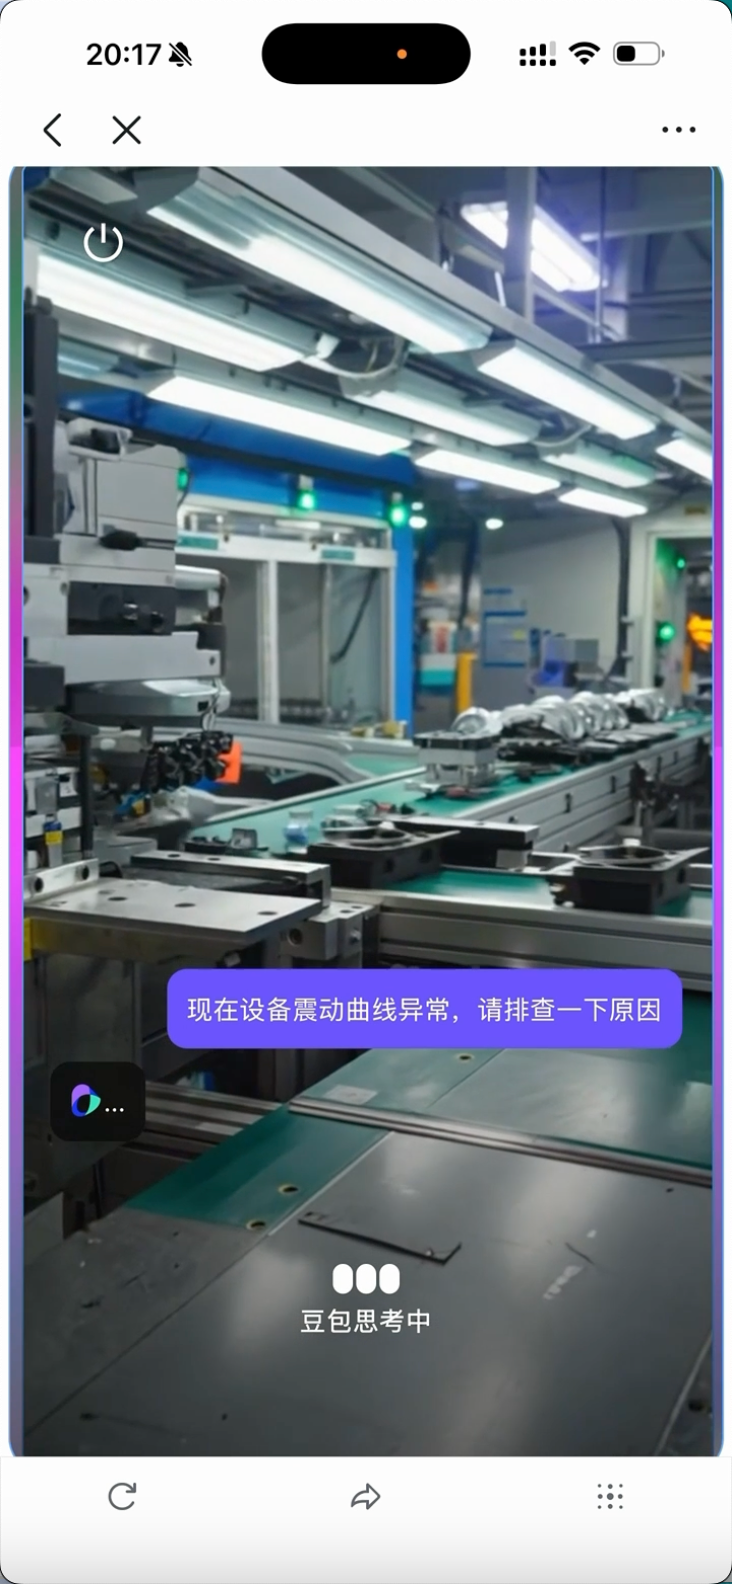
工程师在飞书收到告警后,点击链接即可进入“维修助手”,直接连线进行实时视频对话。AI 模型会基于企业知识库和特定 Skills,一步步指导问题排查和检修。
除了故障应急,这套系统在日常还能充当企业知识库的超能大脑,随时解答设备运维、标准流程等专业问题。
以下视频详细展示了这套工业 Agent 流程:
在企业面临全球化竞争的今天,除了生产线的稳定,出海合规与跨国财务 同样是让很多公司头疼的深水区。传统处理方式高度依赖人工,效率极低且极易出错。我们也可以借助AI的能力提升效率。
硬核Case3:一人公司“拼豆图”全自动商业闭环
这是我个人觉得,任何一个想做超级个体的朋友都可以尝试的落地案例。
我们基于OpenClaw的能力,由豆包Seed2.0驱动,完成了从内容营销到产品交付的全自动化闭环。
首先在飞书多维表格上每天自动采集热门拼豆画需求,看看大家对哪些图感兴趣:
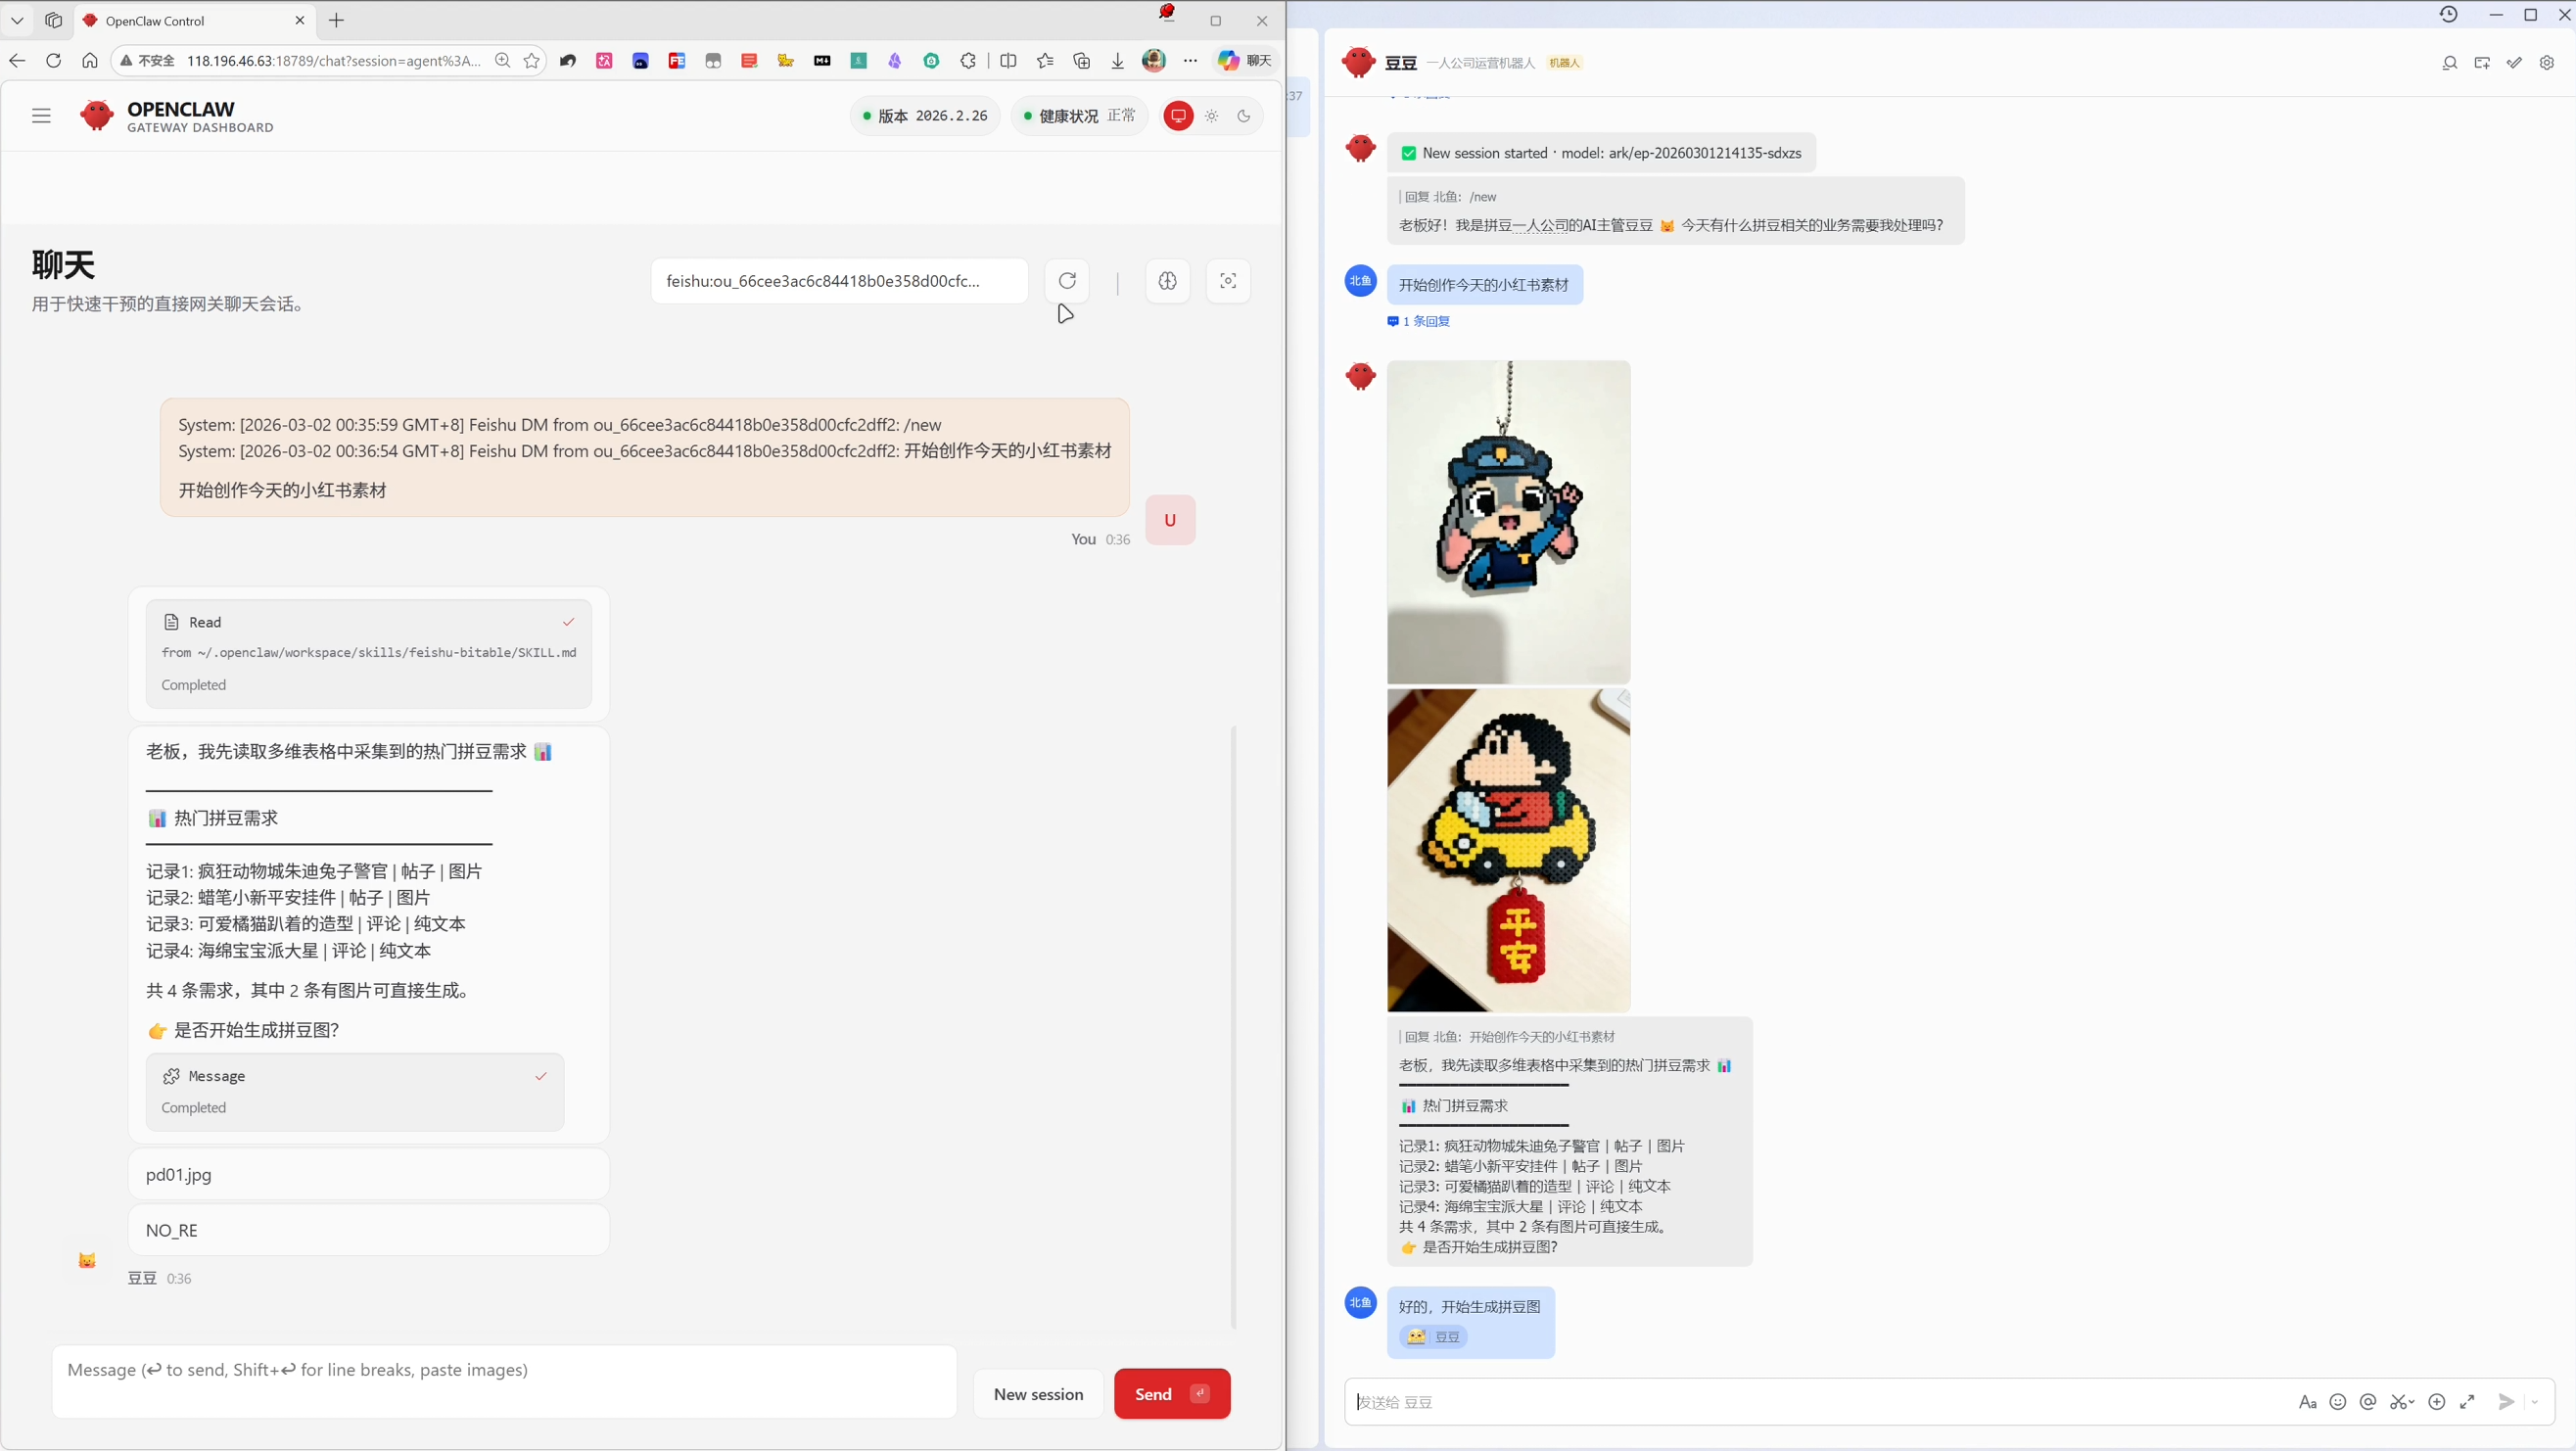
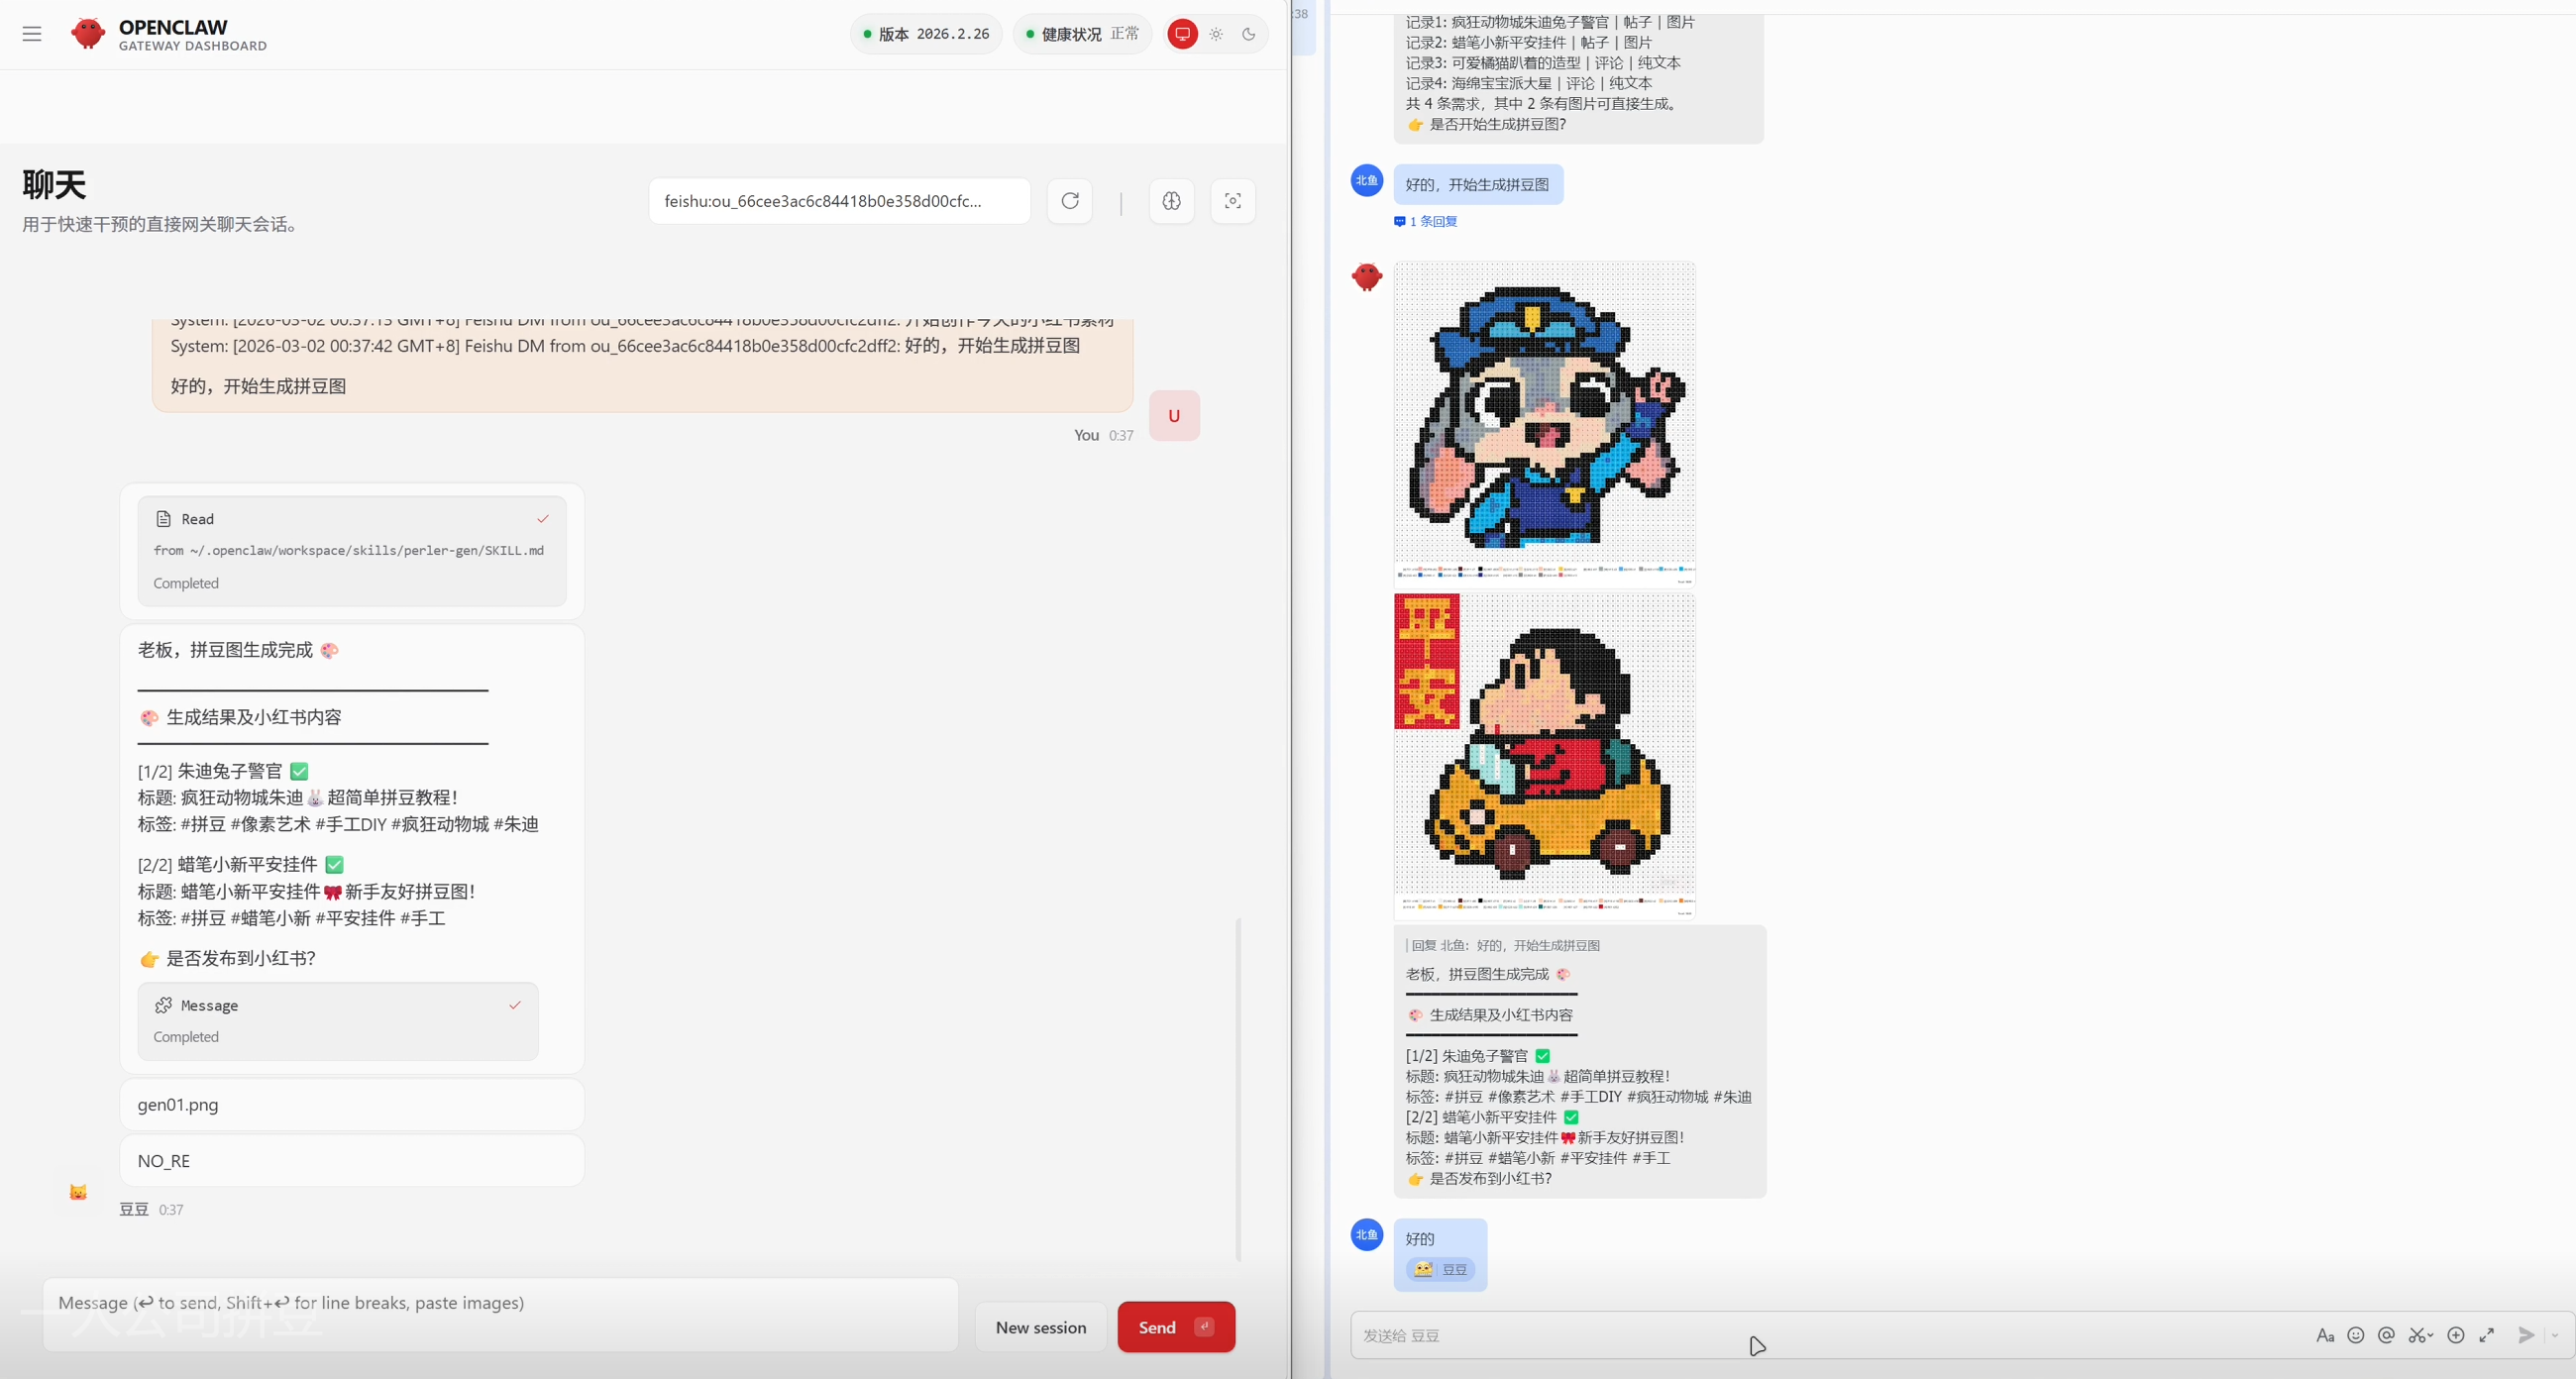
使用这些图,自动生成拼豆图、同时自动完成在哪社交平台的内容发布:
吸引到用户后,可自动成单并发送产品链接,用户自主完成图片转换:
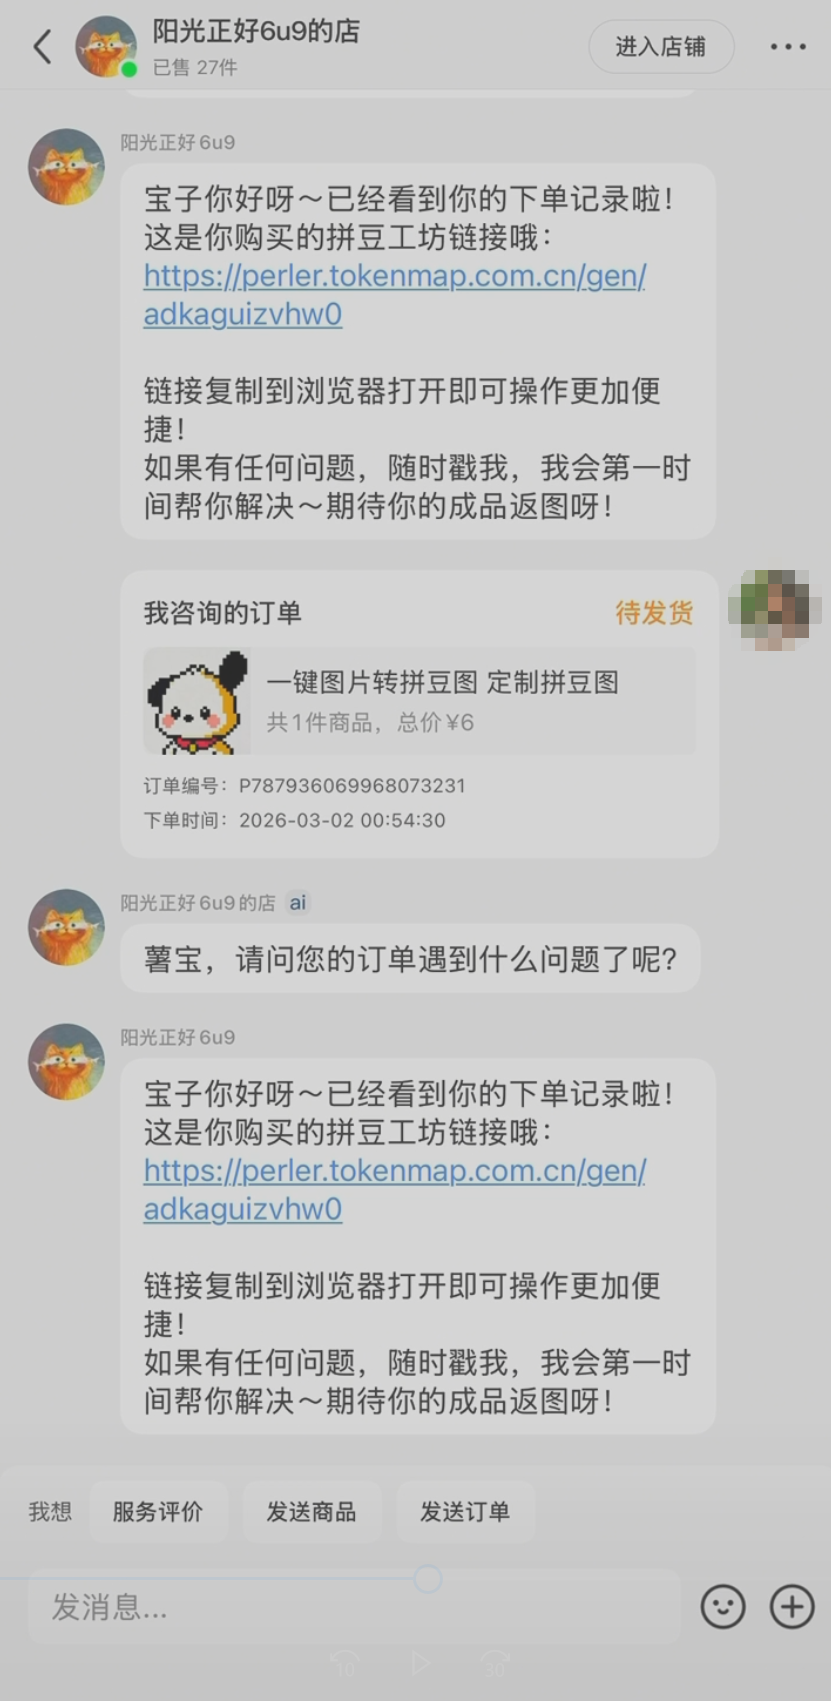
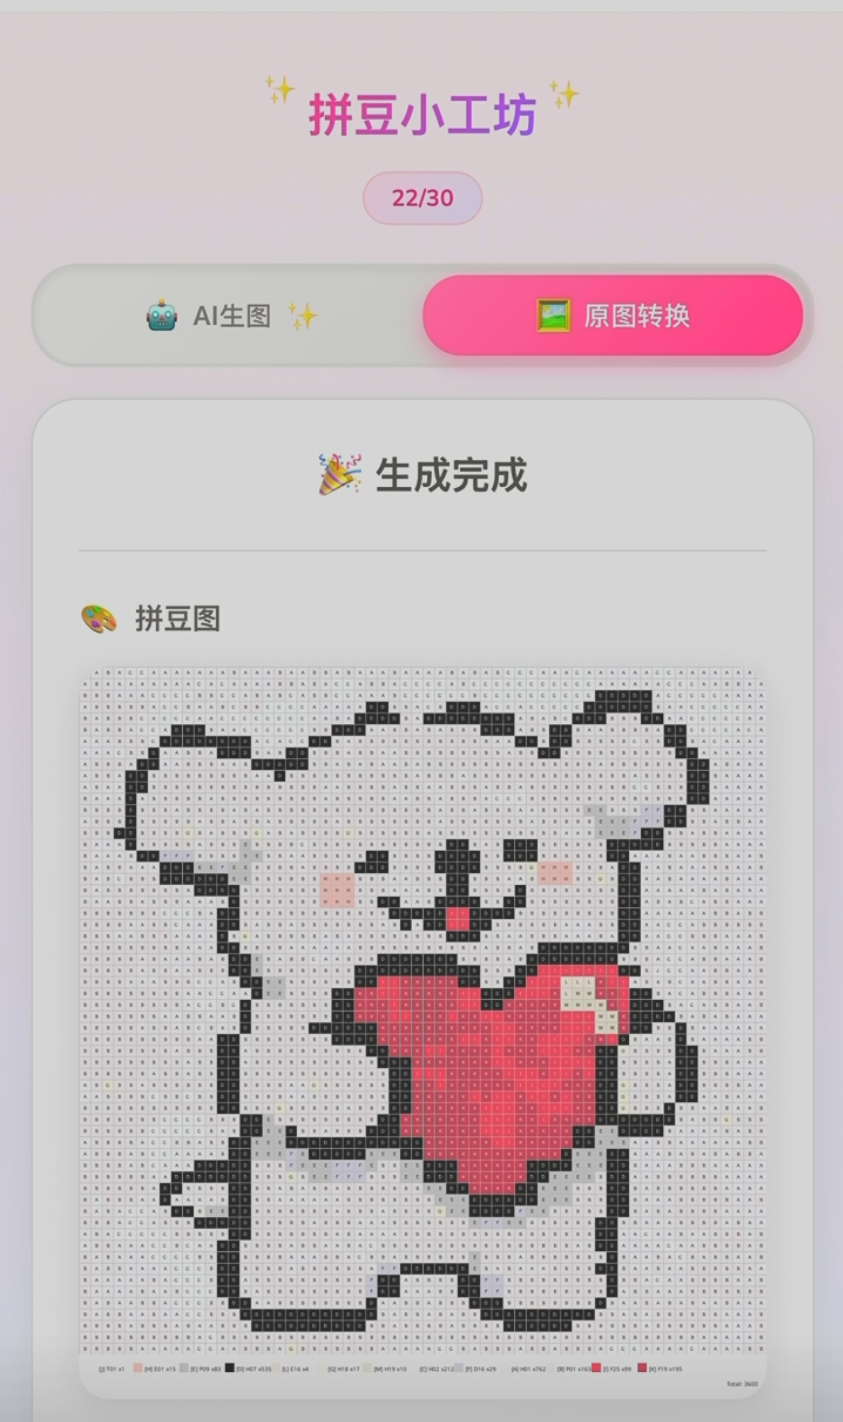
由此,完成从内容营销到产品交付的全自动化闭环,更深一步,还可以找到后端品都供应商,一件代发定制产品。
最后自动生成每日运营数据报告,向“老板”汇报战况。
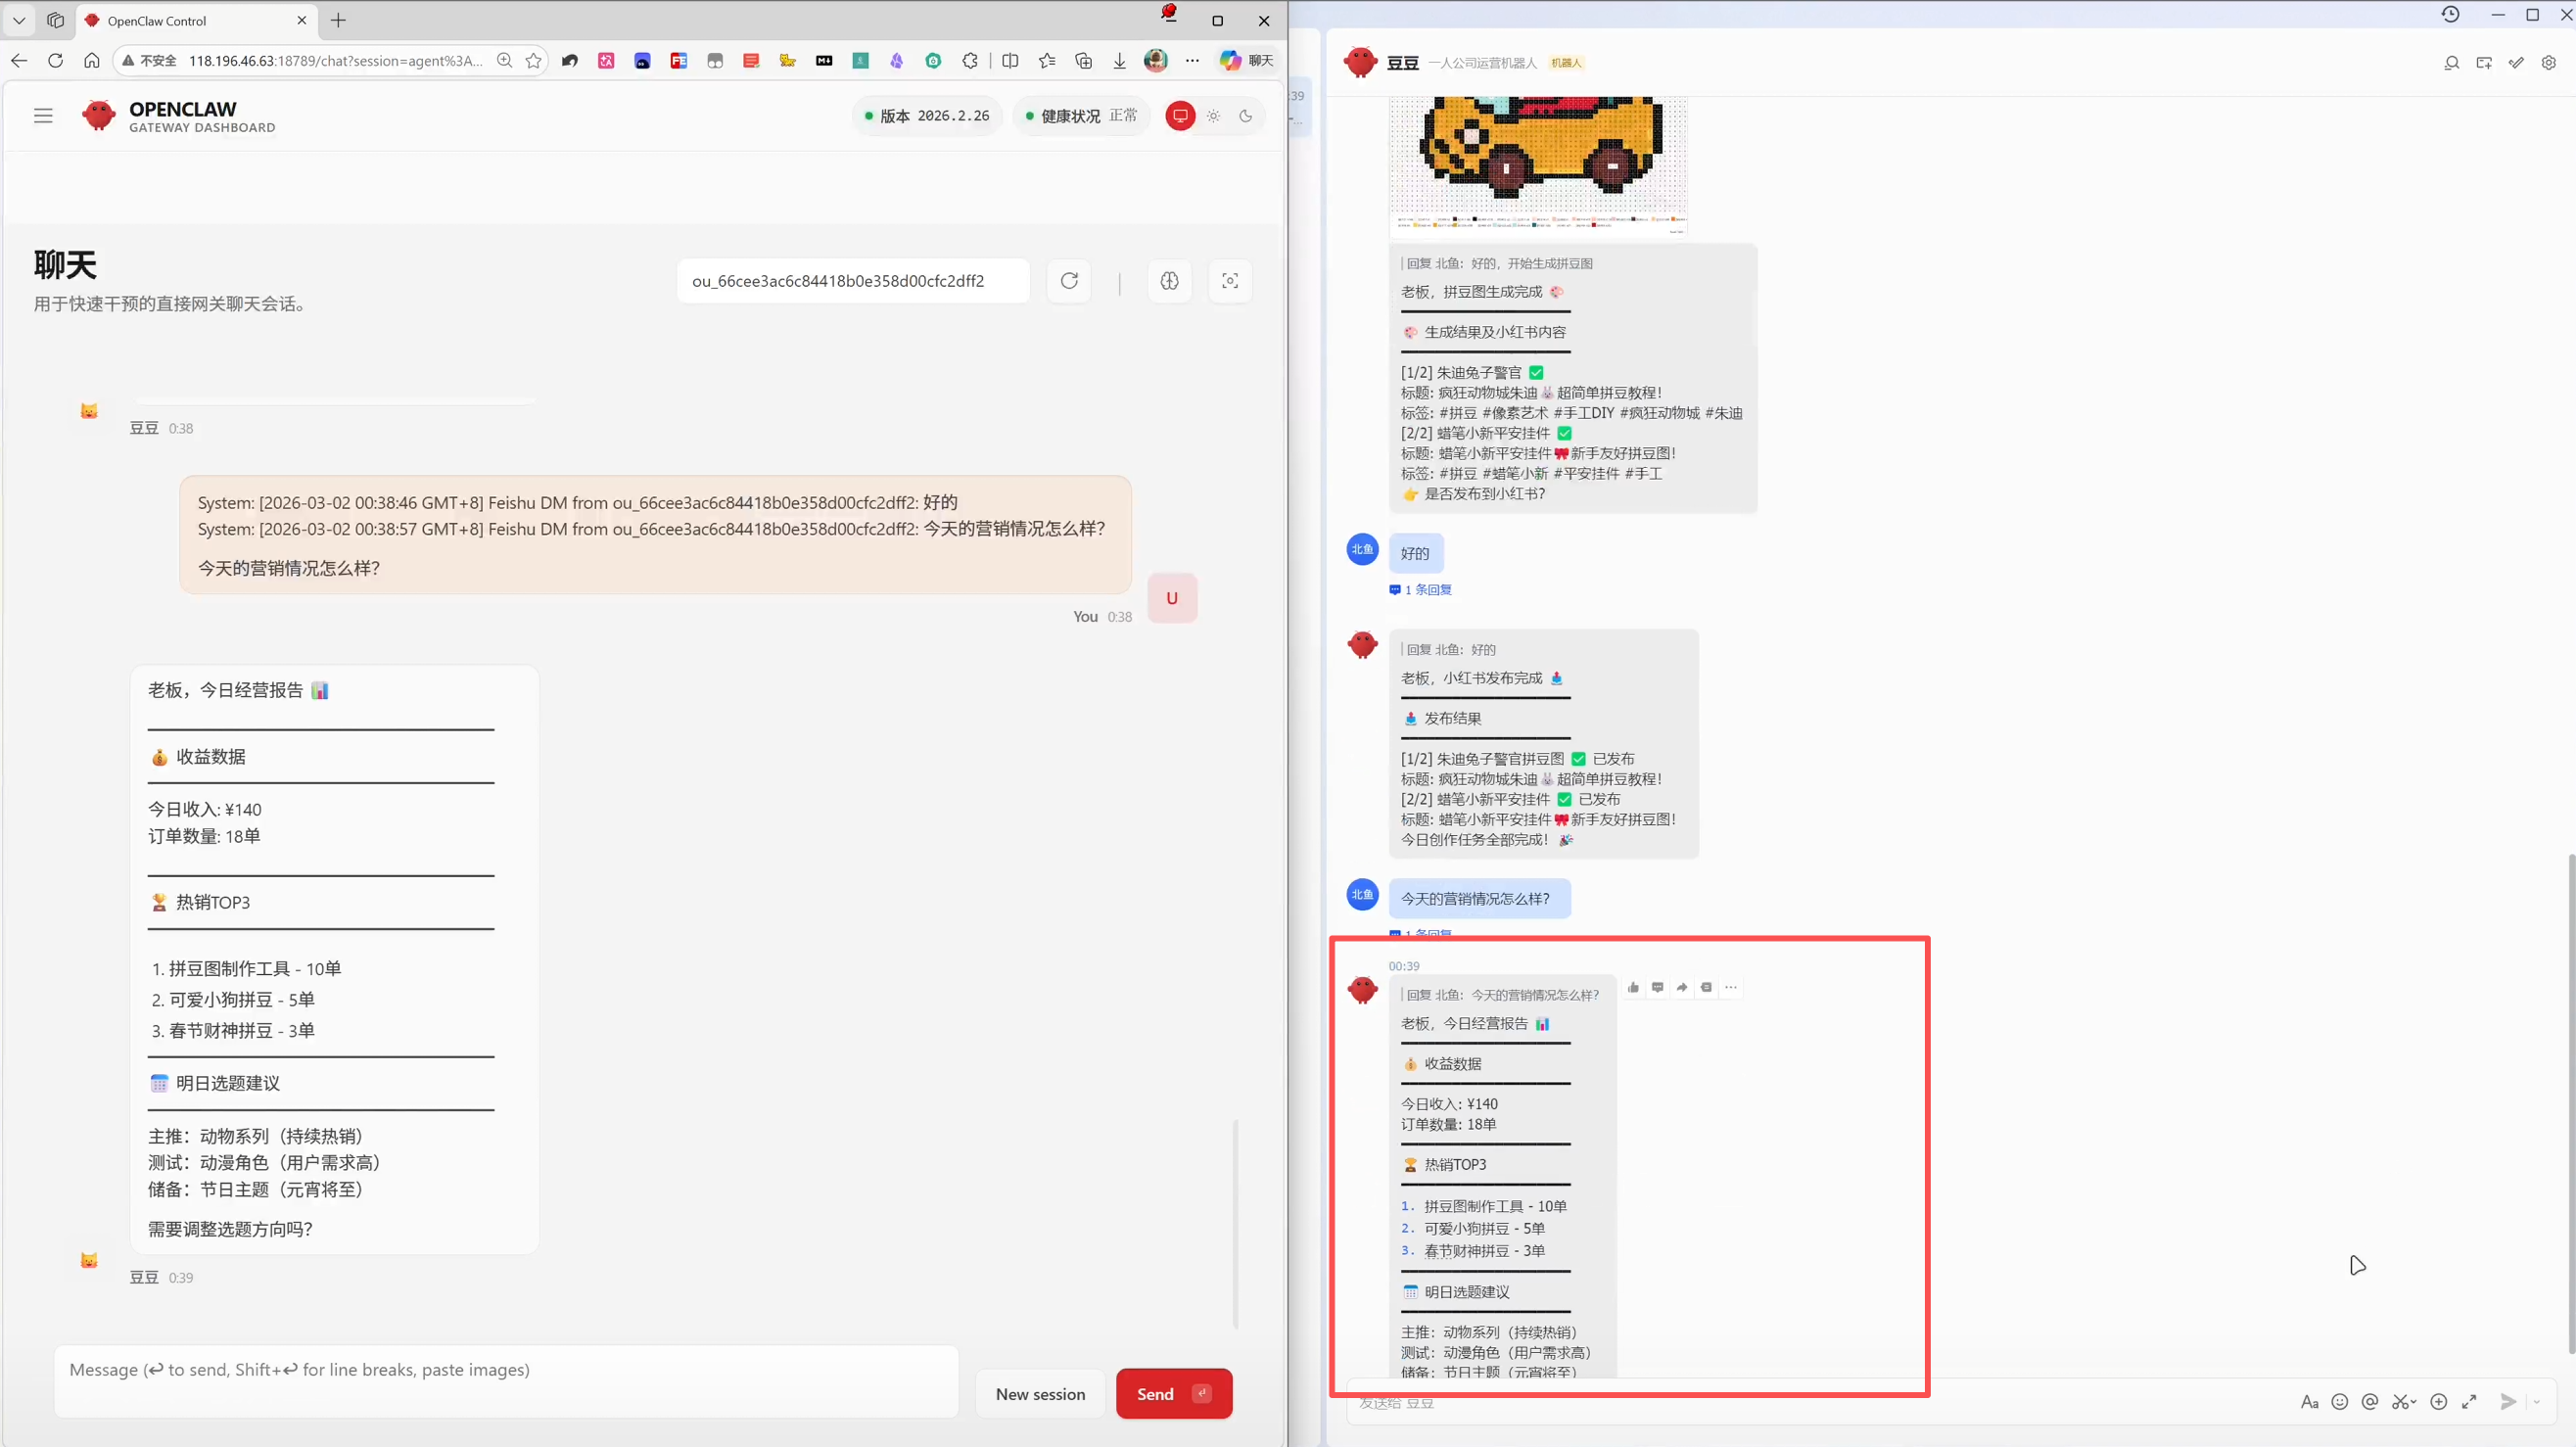
以下视频演示了,这个Agent是如何自主的完成一整套流程的。
其中驱动模型使用Doubao-Seed-2.0,拼豆图模型使用Seedream-4.5。
以上我们为了更方便查看,所以做了一定的页面开发,如果你觉得这太难了。其实,很多场景,并不需要任何的额外开发,只需要在扣子中,就可以完成,比如出海中的常见问题:
硬核Case4:物流海关码智能归类
企业大力推进出海业务,海关商品编码(HS 编码)归类工作是必不可少的一环,而海关编码归类极度依赖老关务人员的经验,在正常工作节奏下,专业人员一天大概也只能处理 50 颗物料。
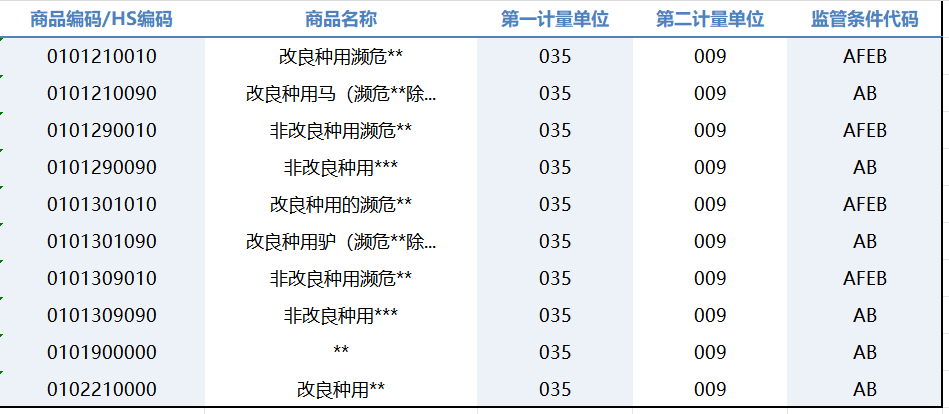
而现在,我们可以依托豆包2.0大模型的语义理解、强推理以及多模态技术,辅助海关编码归类工作。
不需要复杂的开发,只需要在扣子中,就可以完成:
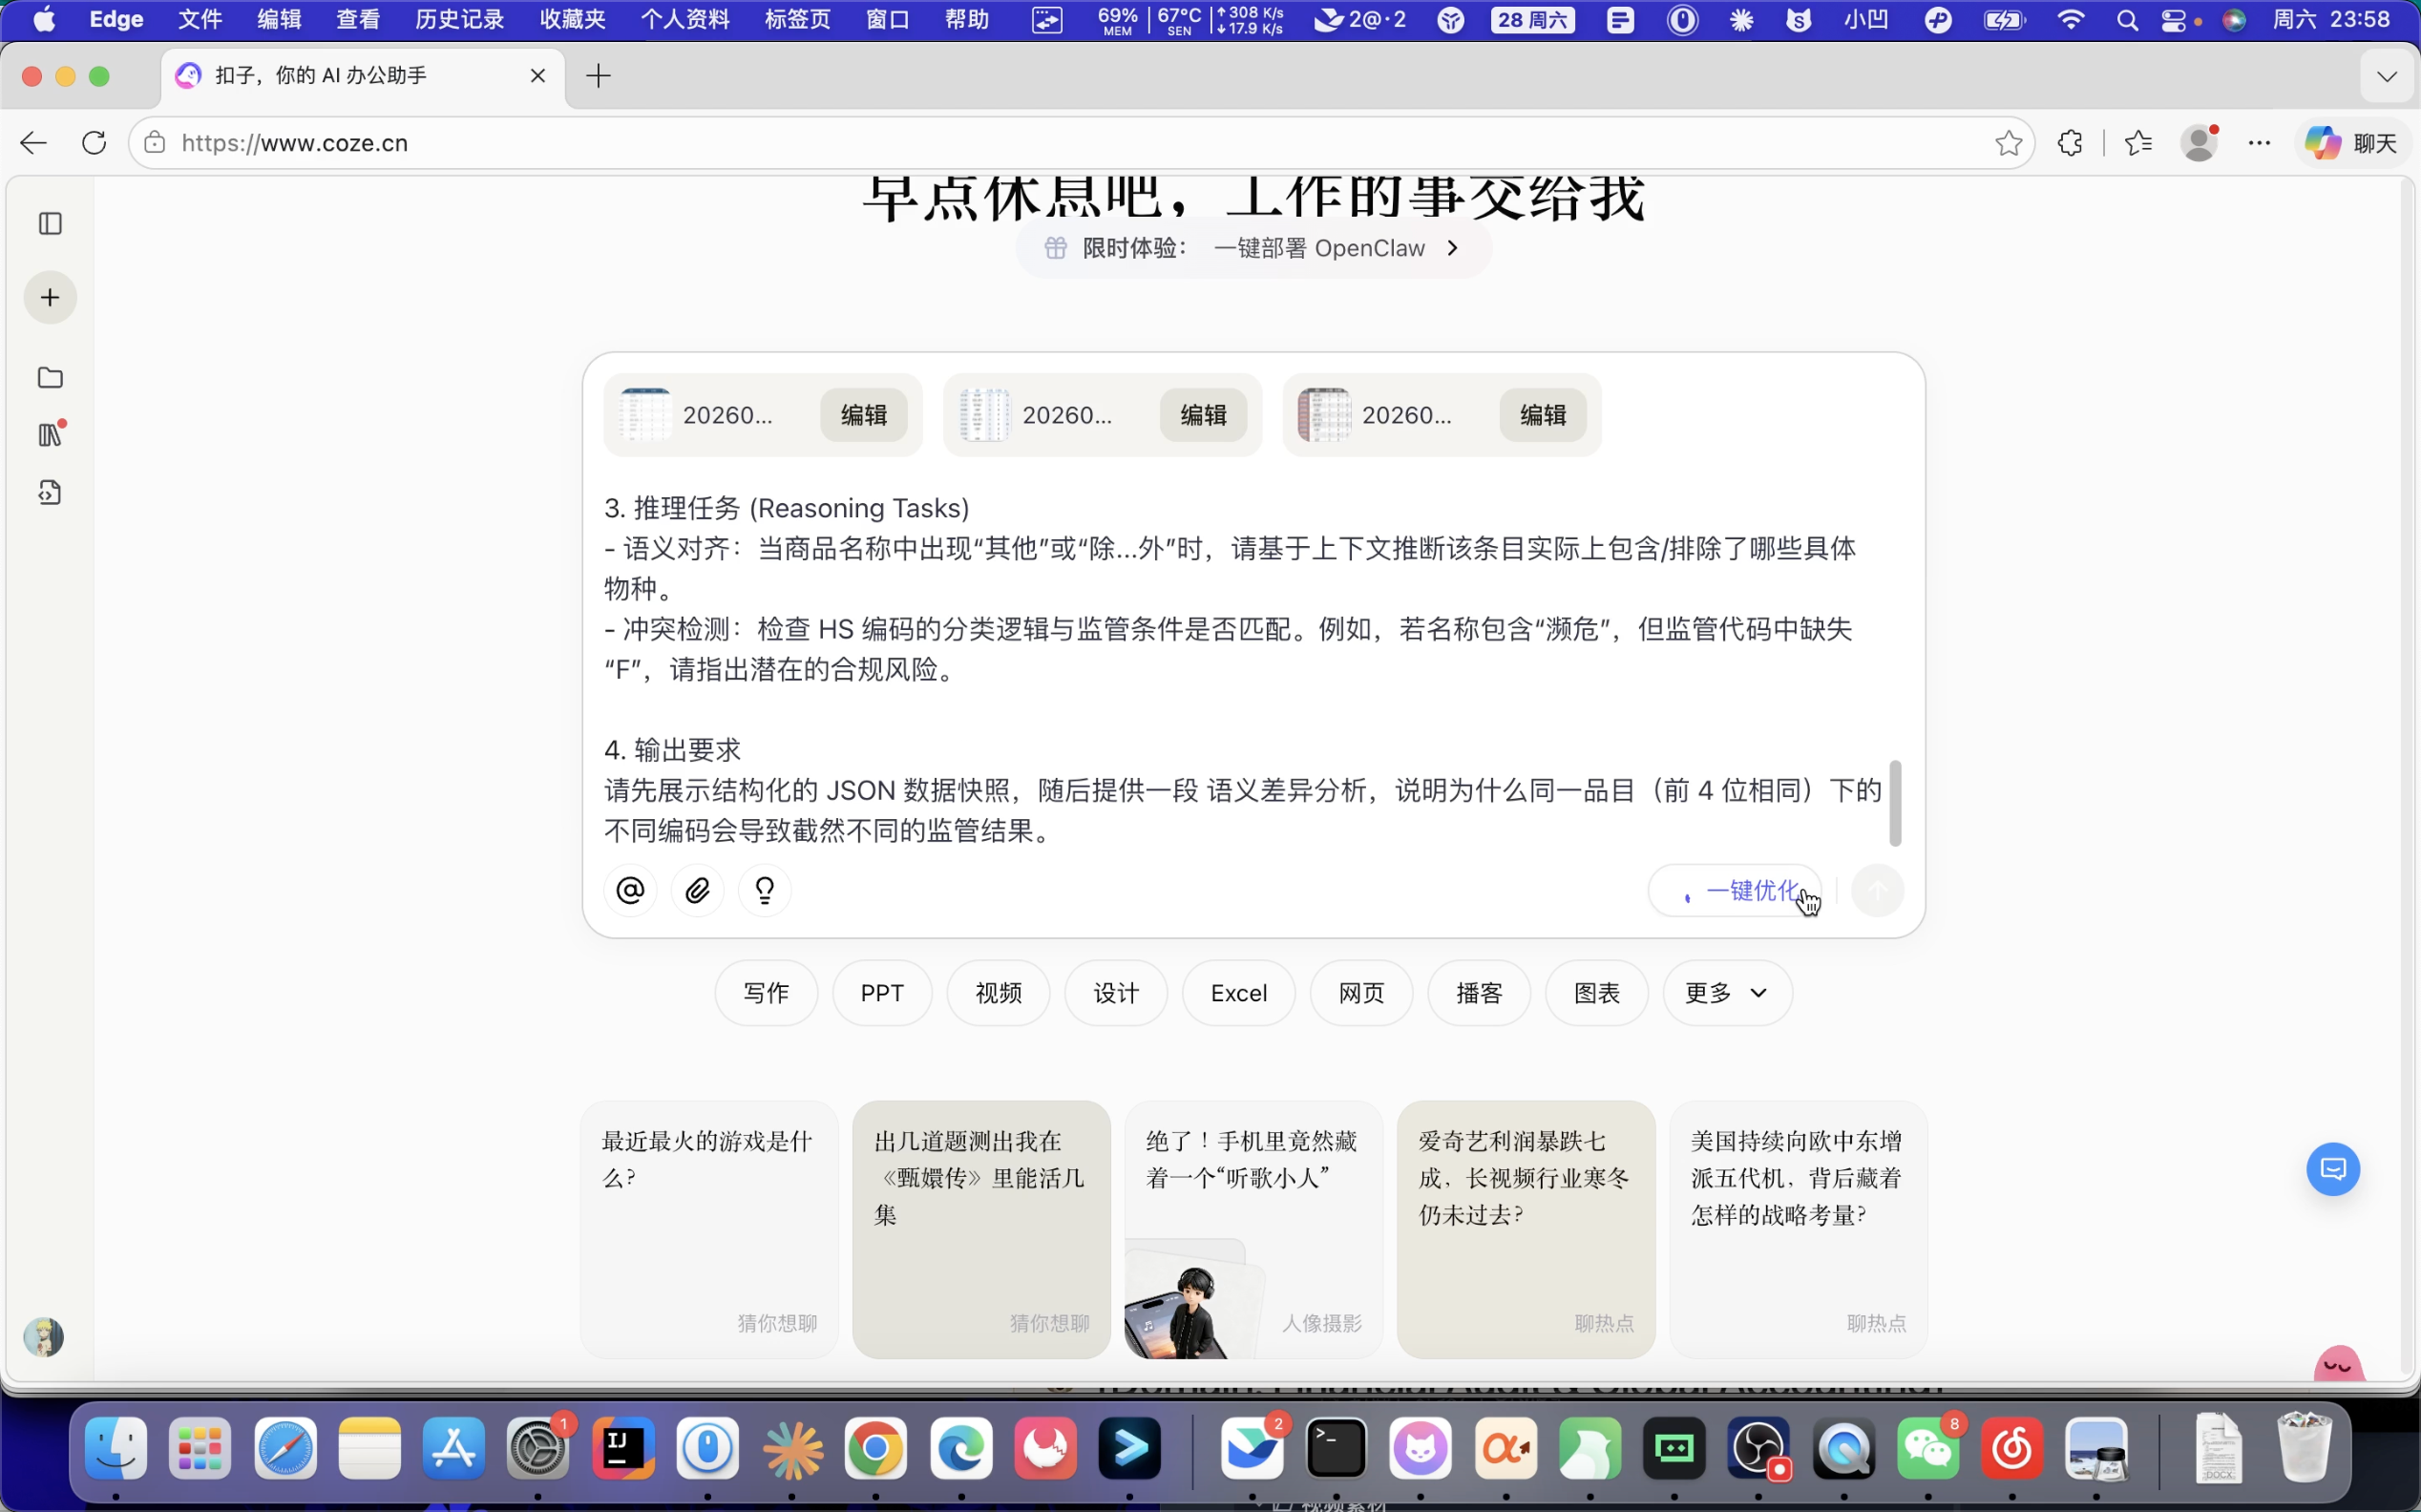
它能够将 PLM 里的物料信息、海关手册、规格说明书以及 TMS 历史数据作为依据,利用视觉等多模态技术深度解读商品实物图。提取特征后进行交叉验证,高效的为物料精准匹配对应海关码。
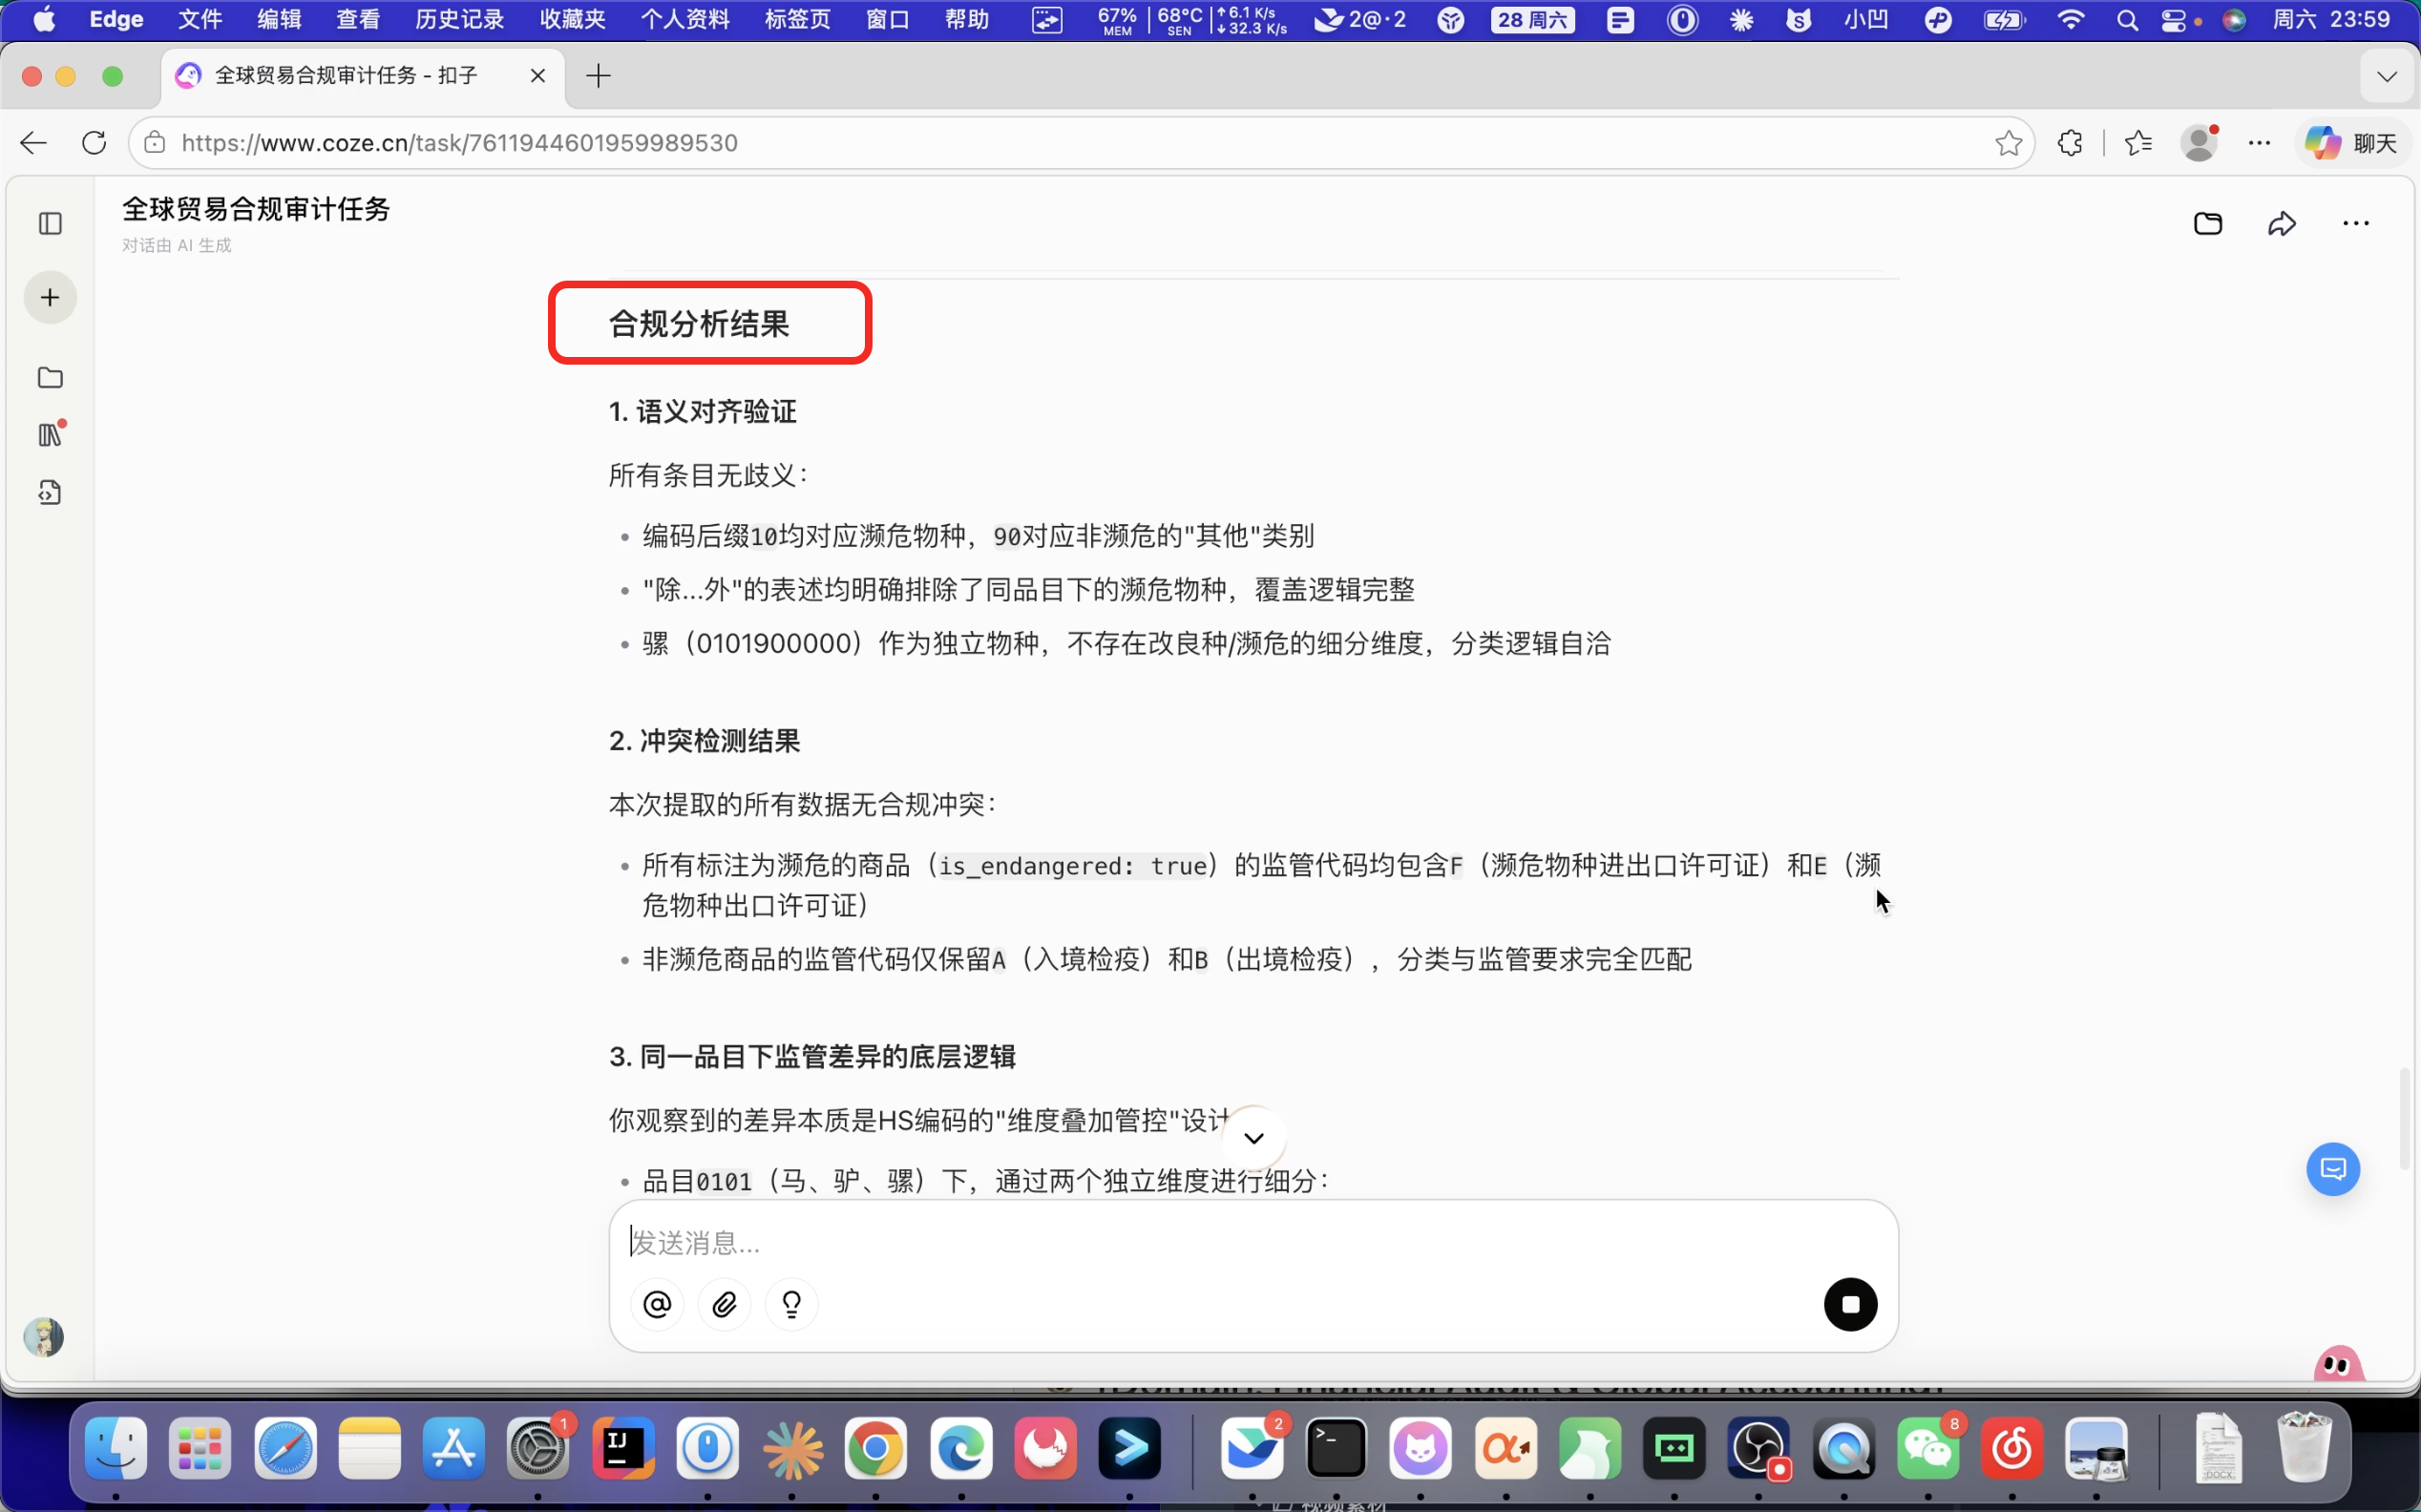
以下视频展示了完整的流程:
此案例来自:苍何&蜗牛。
硬核Case5:海外发票智能汇总与财务结构化
出海业务带来的不仅是通关挑战,同时还有满天飞的国外发票。各种语言、各种奇葩格式(机打、手写),让财务人员在录入和报销时苦不堪言。
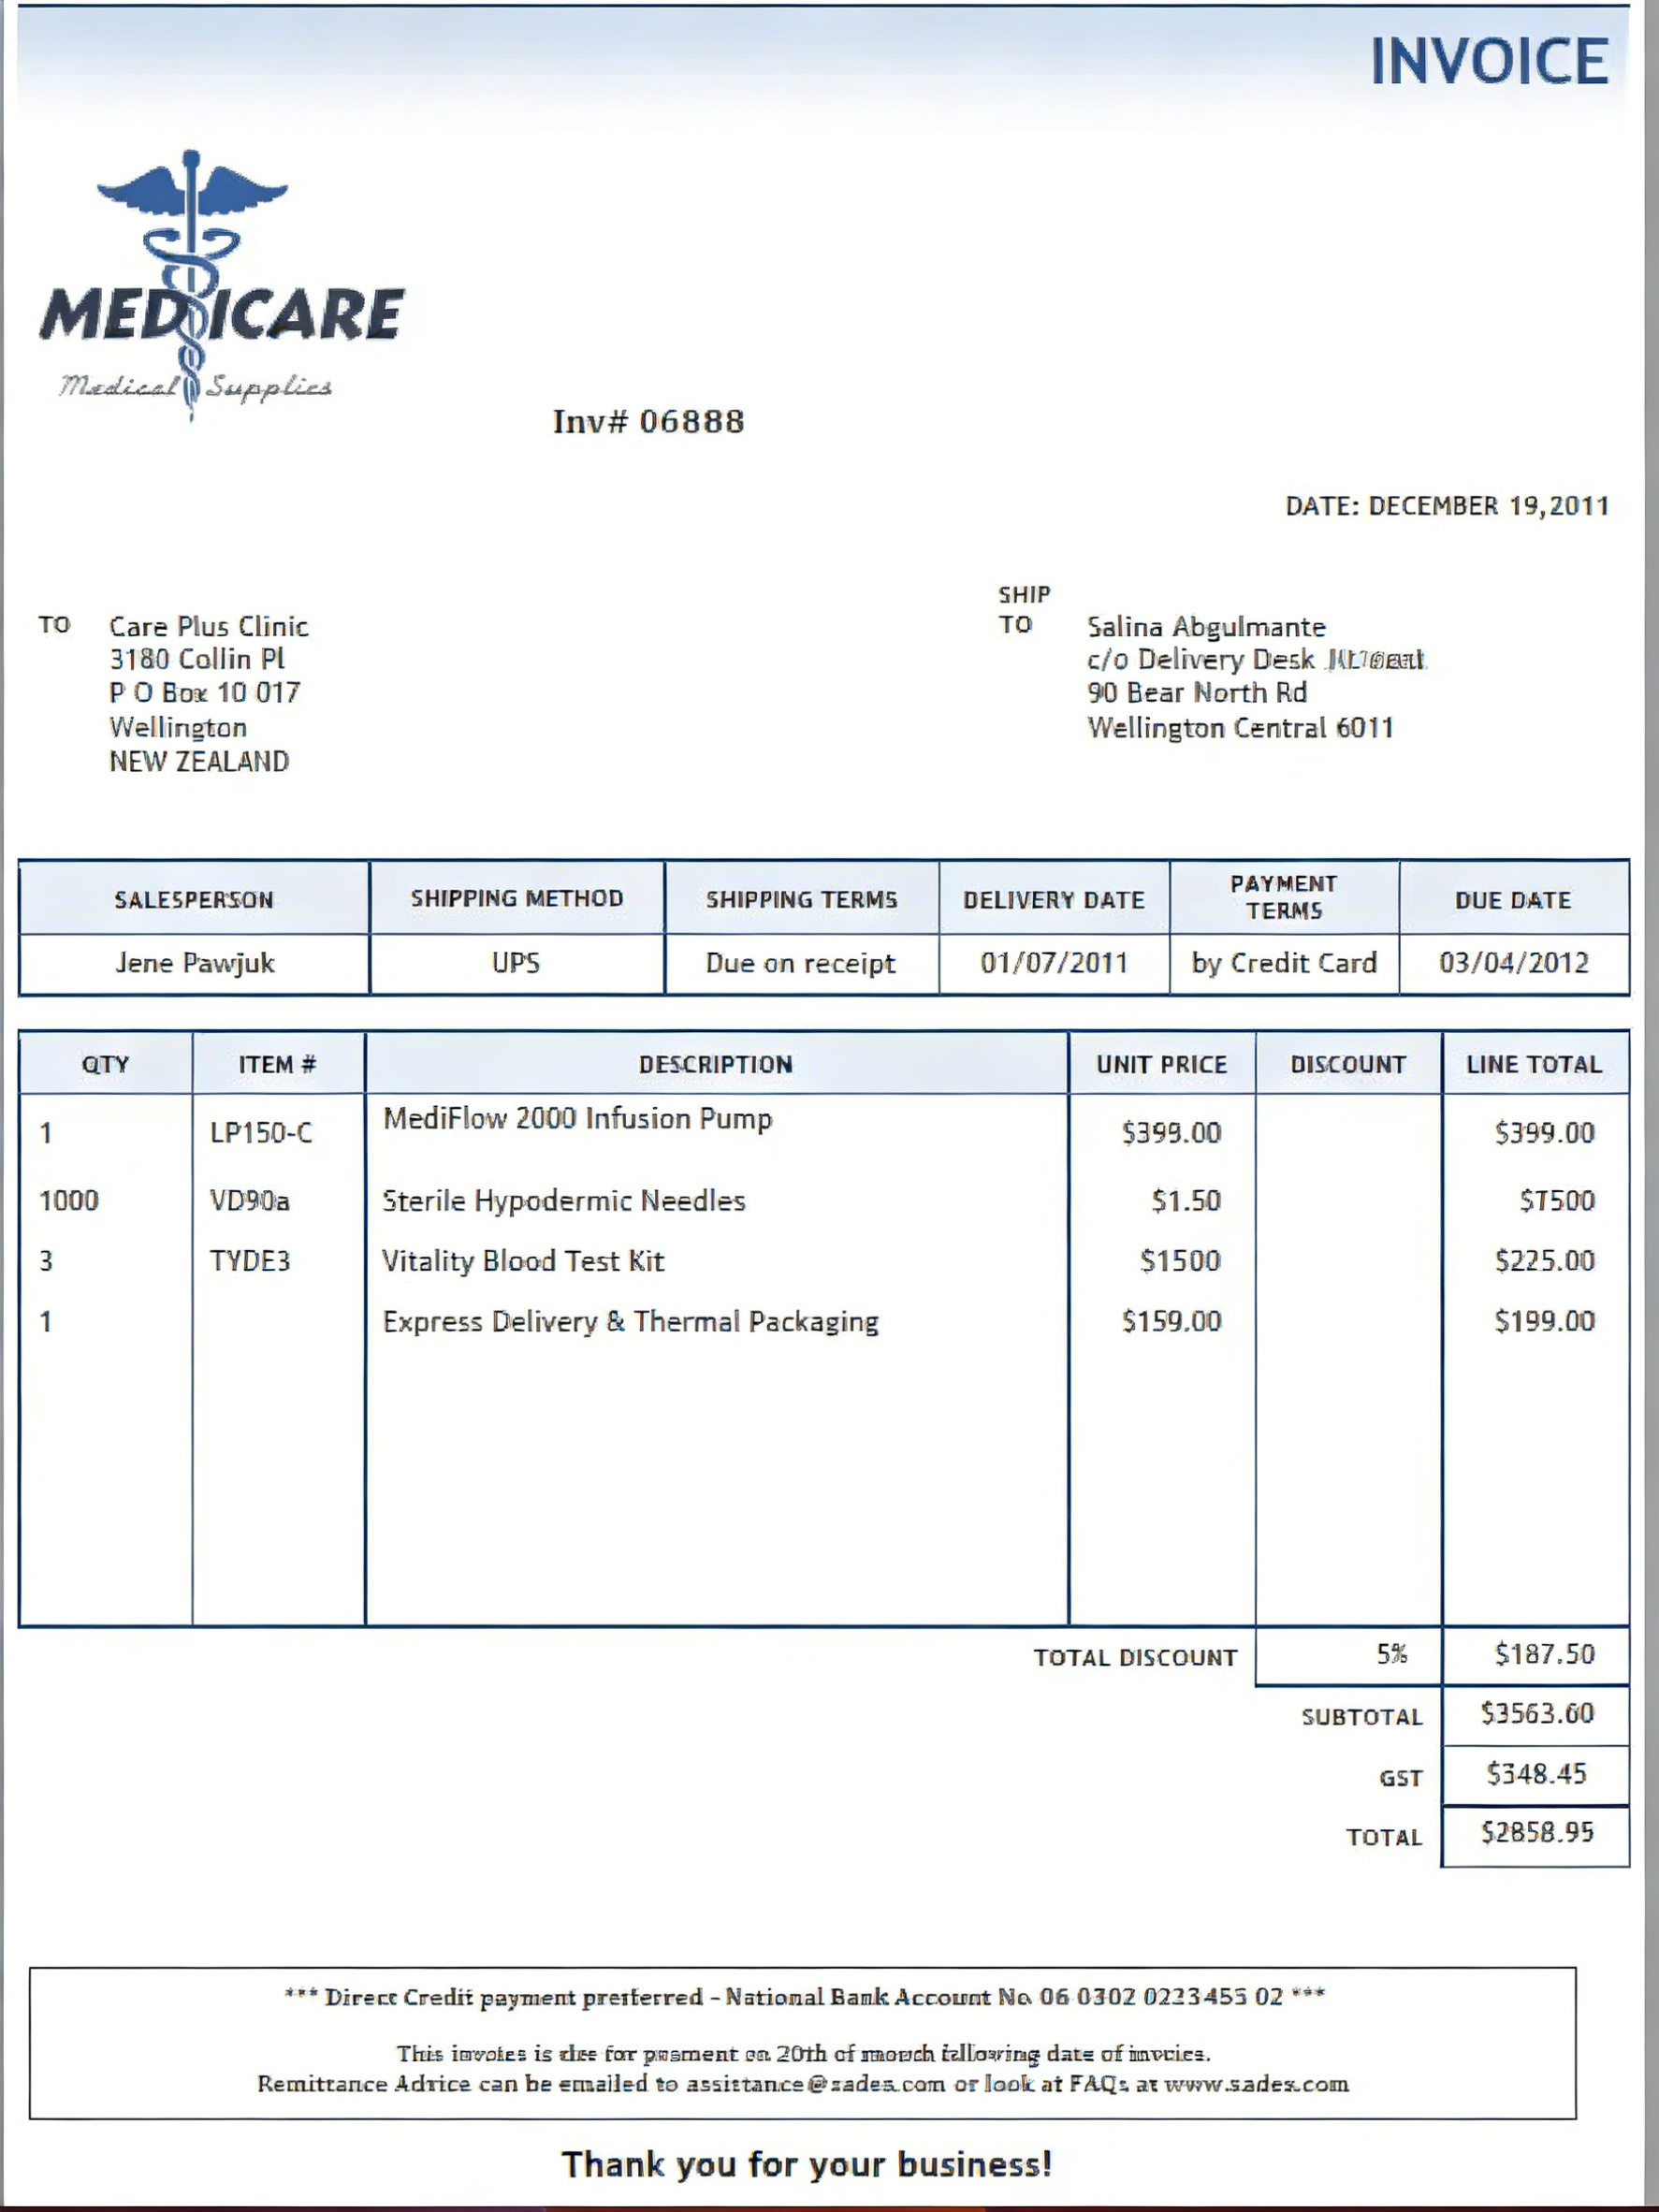
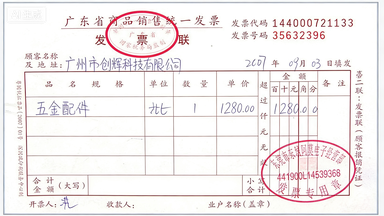
利用视觉模型强大的图像理解和分析能力,它能自动理解不同格式发票的特征,完全无需像传统 OCR 技术那样去逐一标注模板。
只需要在扣子中,就可以让AI 化身为“智能财务审计 Agent”。
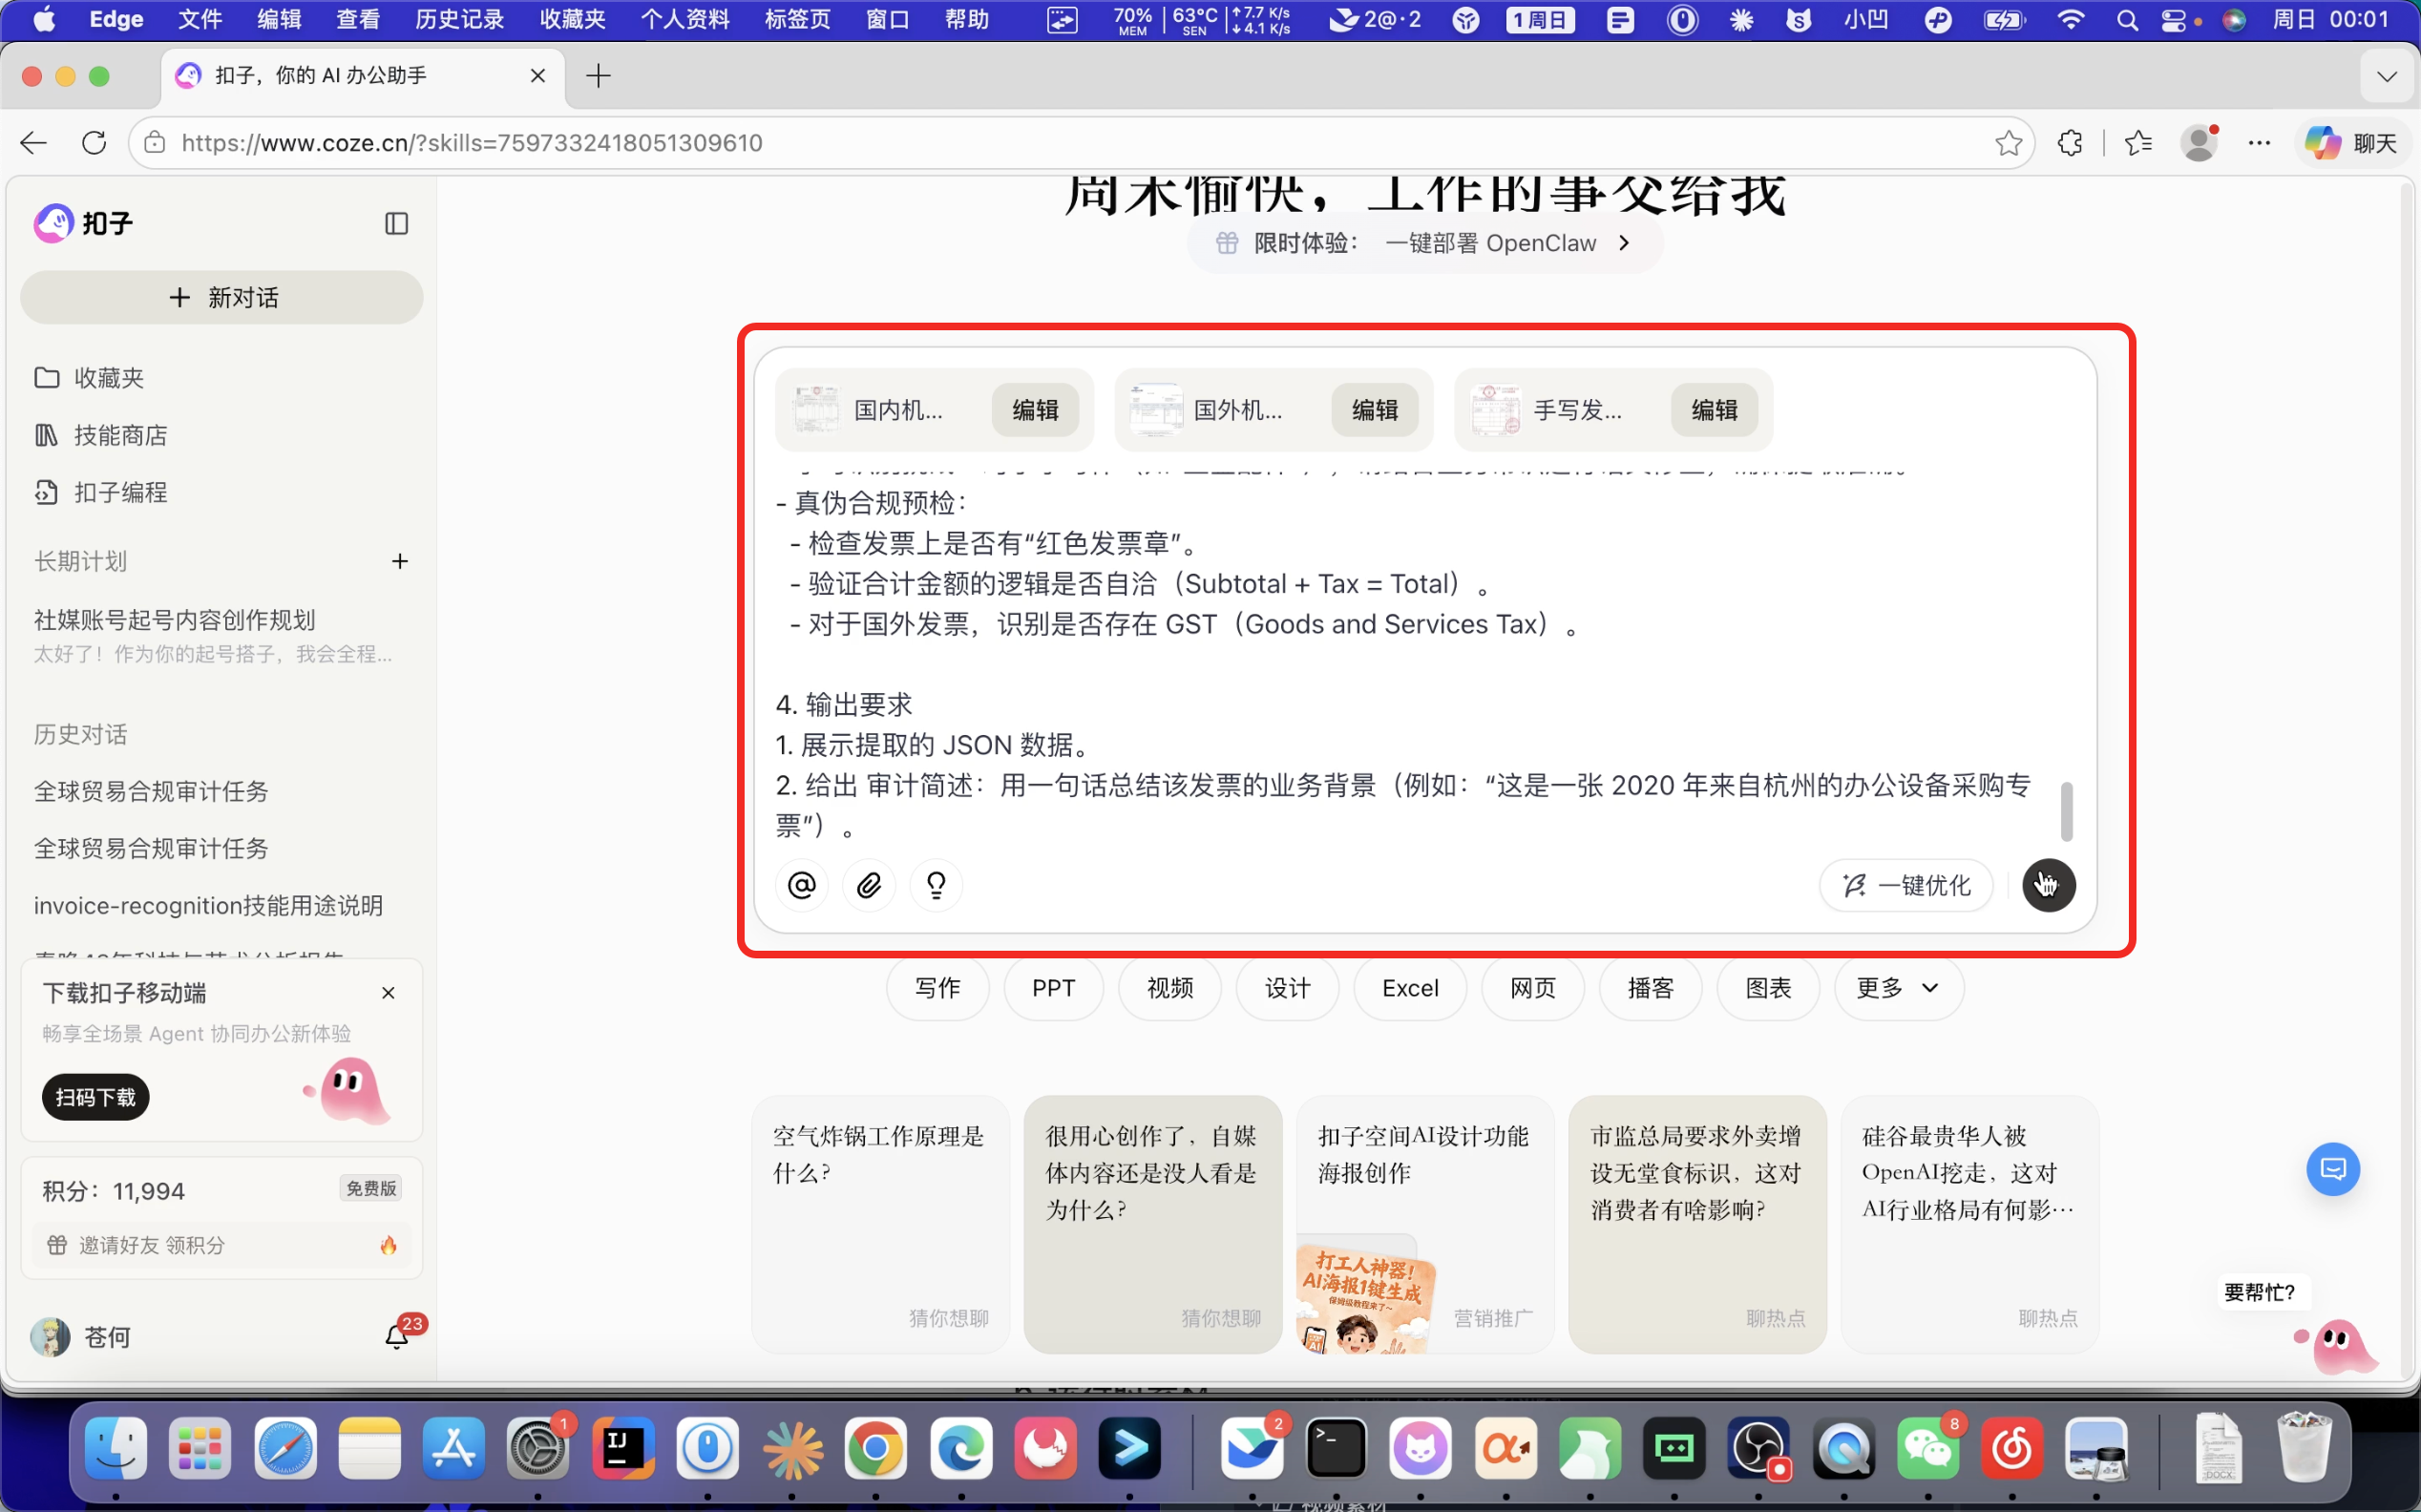
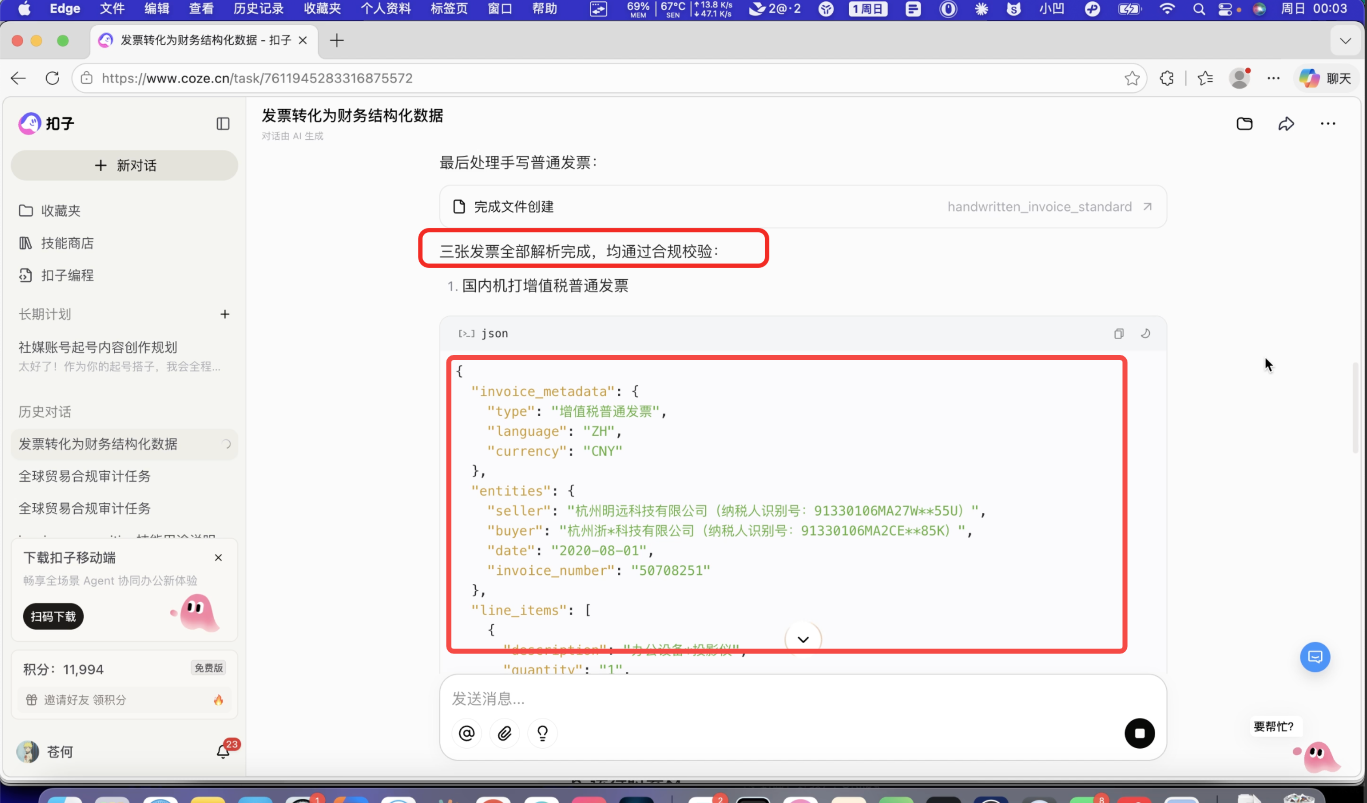
自动提取出买方卖方、税额逻辑、币种税种,甚至手写票也能精准识别印章和金额。然后直接输出标准的 JSON 结构化财务数据,大幅降低人力时间成本。
以下视频展示了完整的流程:
此案例来自:苍何&蜗牛。
当然,除了这些重磅的商业场景,我们还做了一些好玩的轻量级尝试:
Case6:健身姿势纠正
比如,基于 豆包Seed2.0多模态能力的健身姿势纠正,通过上传运动姿态图片→选择运动类型→AI 识别骨骼关键点→对比标准姿态→输出纠正建议 + 评分。
简直是随身私教。
Case7:手势追踪的飞机大战
我想,以上Case已经足以证明豆包在实际应用场景中的Agent能力,我们在内测的过程中也能够明显的感觉到,豆包的更新不是为了跑分,而是为了“真管用”。
最后,提一个在这次更新中让我们比较惊艳的模型,doubao-seed-2-0-mini。
虽然这款模型并非主测模型,但是在体验过程中我们发现这是一款非常“好用”的模型。
开启了“中度思考”之后,体感质量与doubao-1.6相当甚至超越,更夸张的是输出的速度能达到150tokens/s,速度快、质量高,价格还巨低。
这个生态位上,mini几乎没有竞品,推荐大家在文字处理场景下试试它。使用mini替代前两代的旗舰模型,绝对会给你大大的惊喜~