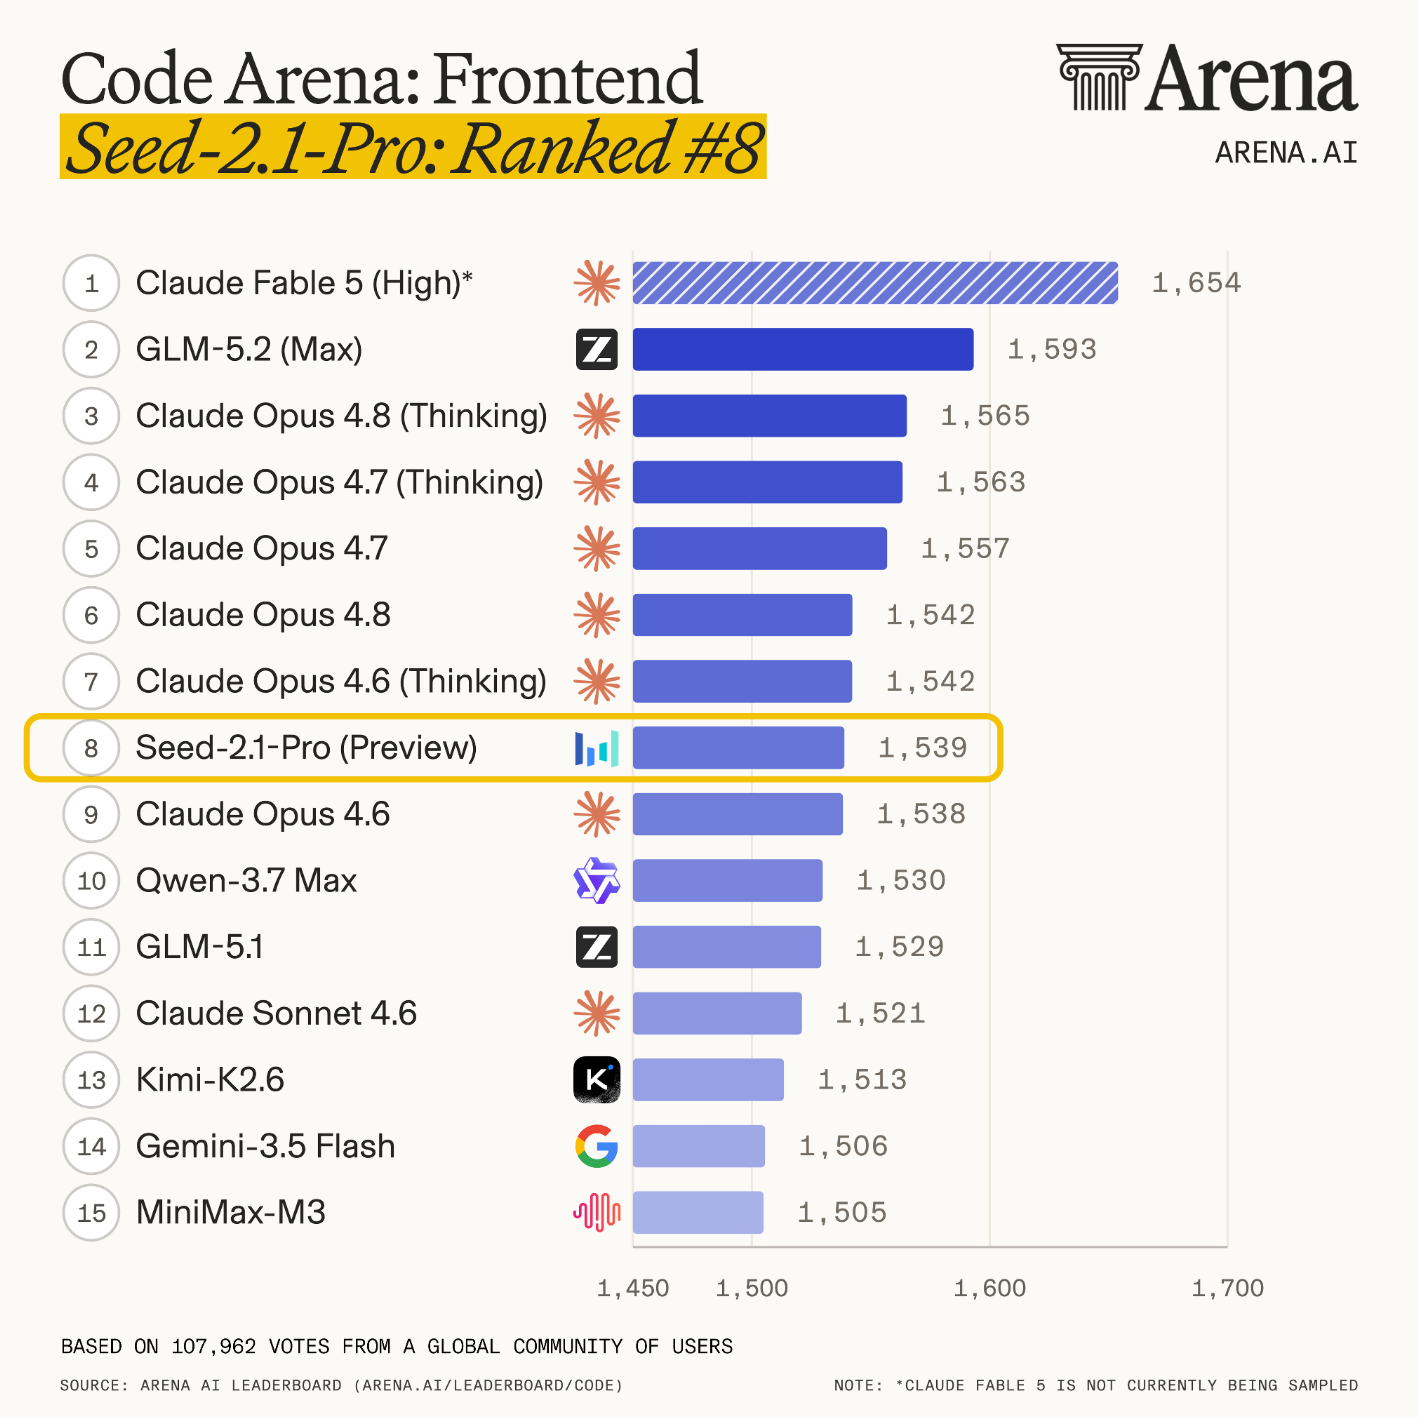
今天,Doubao-Seed-2.1-pro正式发布,在Coding、Agent和VLM能力上大幅提升。在全球竞技场上,豆包2.1 pro也取得了高度认可。根据第三方权威榜单Code Arena Frontend的最新结果,豆包2.1 pro的AI Coding能力已经超过Opus4.6,比肩4.7,跻身全球第一梯队。
我们选了一个非常硬核的生产场景测试——芯片设计 RTL。它是芯片设计里最核心、最严谨的环节,要把每个寄存器和信号线在每个时钟周期里怎么流动写清楚,通常要 3 到 5 名工程师做数周工作。豆包 2.1 pro 围绕一个 16×16 PE 的 Tiny NPU Tile,模型连续运行近18个小时,经历 9 轮迭代,最终完成了 6 个核心模块、1303 行 RTL 代码;还跑通了仿真、测试、综合检查等完整工程流程。我们能看到最终通过了手写数字识别验证,整体大大节省了工程师开发时间。这背后体现的,就是 豆包2.1 pro在真实工程场景里的生产级 Coding 交付能力。本文来简单介绍一下这个Case如何复现。
先说清楚:RTL 和 NPU 是什么
很多人第一次听 RTL,会以为它和普通代码差不多。其实差得很远。软件代码更像是在写步骤:先做什么,再做什么,最后返回什么。RTL 更像是在描述一台机器的节拍:每来一个时钟,哪些地方记住新值,哪些地方把数据送到下一站,哪些地方保持不动,都要交代清楚。
可以把芯片想成一个小工厂。软件像是在写操作手册,RTL 则是在画传送带、工位、暂存架和控制按钮。每一拍,材料从哪里来,谁加工,谁等待,谁把结果送出去,都要写明白。
这也是 RTL 难的地方。你写下的一行逻辑,最后会被综合工具翻译成真实的门电路和触发器。一个位宽写错、一个有符号数处理错、一个状态跳转漏掉,后面仿真、综合、时序、验证都会受影响。
所以在真实公司里,一块中等规模的 RTL 模块,通常要 3 到 5 名工程师连续推进数周。真正耗时间的地方,是每一步都要被工具和测试反复追问:这根线有没有接错,这个状态能不能退出,这个负数会不会把结果算偏。
NPU 是另一层背景。AI 模型里有大量矩阵乘加:一堆输入乘上一堆权重,再把结果累加起来。NPU 就是专门为这类计算设计的芯片,会把很多小计算单元并排摆开,让它们同时干活。
这次做的 Tiny NPU Tile,可以理解成 NPU 里的一个“计算小方块”。它不是完整芯片,但已经包含核心单元该有的几样东西:乘加阵列、片上小内存、寄存器、调度器、量化和后处理逻辑。
最核心的部分,是一个 16×16 的 PE 阵列。PE 可以先理解成一个小乘加单元,16×16 就是 256 个小单元排成方阵,用来做 AI 推理里最常见的整数乘加。
这次交给 AI 的,是一整套 RTL 流程
在最后用手写数字识别做验收,只是为了确认这块 tile 真的能把一条完整计算链跑通。输入一张手写数字图片,经过两层很小的神经网络,输出 0 到 9 里的一个数字。这个应用本身不复杂,它的作用更像一张终考试卷:只要指令、寄存器、片上内存、乘加阵列、量化和状态机中间有一个地方接错,最后结果就对不上。
真正的工作量在前面。
Doubao-Seed-2.1-pro 要先读完规格文档,弄清楚这块 tile 应该支持哪些指令,寄存器怎么排,数据怎么进出,量化规则怎么写。接着,它要把这些要求翻成架构和微架构设计,再往下写成 SystemVerilog 模块。
最终完成的是 6 个核心模块:mac_array、scratchpad、register_file、scheduler、requantize 和 tiny_npu_tile。它们分别负责乘加阵列、片上内存、寄存器访问、任务调度、量化收尾和顶层连接。
其中最底层的是 mac_array。它在 RTL 里摆出 16×16 个 PE,让它们在时钟边沿一起累加。简化看,核心就是把两个 INT8 当成有符号数相乘,再累加进 32 位结果:
product  = $signed(act_s8) * $signed(wt_s8);
acc_next = acc + product;
真实 RTL 里还要处理片上内存取数、符号扩展、阵列清零、累加和写回节拍。输入和权重是 INT8,累加要放到 INT32,什么时候清零、累加、写回,都要和调度器的状态对上。
RTL 为什么比普通代码更难写
让模型生成几个看起来像 Verilog 的模块并不稀奇,难的是让这些模块经得起工具检查,能在反复仿真和回归里慢慢收敛。
第一关是接口。外部怎么启动,状态怎么返回,寄存器地址怎么排,信号名叫什么,测试平台都会照着这些规则来。比如 host 会不断读 done、busy、error 这些状态位,判断上一条指令是否结束、下一条能不能发。如果 done 没清干净,下一条指令就可能被误判成已经完成。
第二关是计算细节。AI 推理用 8 位整数做乘加,累加完是 32 位,最后还得压回 8 位。这中间全是容易栽的地方,负数尤其麻烦:右移时不能把它当无符号数处理,压回 INT8 时范围少夹一次(把超出范围的值限制到边界),一个溢出就能把分类分数带偏。
第三关是连续指令。外部是一条一条发指令,先写参数,再启动,等完成,再清掉完成标志。如果完成标志没清干净,下一条指令可能误判状态;如果某个状态多停一拍,后面的数据就会错位。
最后还要过综合。仿真能跑,只说明行为对了;综合工具还会继续检查这段 RTL 能不能变成干净的电路,有没有意外锁存器,有没有工具不接受的写法。
不能只靠一句提示词
这类任务不能靠一句“请帮我设计一个 NPU”来开始任务。
我们给 Agent 准备的是一条明确的工程流水线:先读规格,再写架构和微架构,然后才进入 RTL、测试、仿真、调试、回归、综合和验收。
每一步都有边界,也都有验收。模型不能随手改接口,不能一遇到失败就大重构,也不能只盯着最后结果。它大部分时间都在做工程判断:当前卡在哪一步,接下来该调用什么工具、看哪份结果、改哪一小块。
模型是怎么跑完整个 RTL 流程的
1. 读 Spec,先把规则理解清楚
模型先读系统规格、模型规格、ISA 与编程模型、编码规范和验证计划。这里面最重要的是那些不能改的硬约束:指令有几条,寄存器地址怎么排,scratchpad 怎么存数据,requantize 怎么取整,非法指令怎么处理。
这些东西一旦后面随意变化,测试平台、参考模型和 RTL 就会互相打架。前期看起来慢,其实是在减少后面的返工。
接着是架构和微架构。架构回答外部怎么看这块 tile,微架构回答内部怎么实现:PE 阵列怎么接,scratchpad 的读写节拍怎么安排,调度器有哪些状态,量化在哪里收尾。这个阶段定清楚,后面的 RTL 才不会写散。
2. 写 RTL,把 6 个核心模块搭起来
架构定下来后,模型开始写 RTL。
先完成乘加阵列,再写量化、片上内存、寄存器文件、调度器,最后把所有模块接到顶层。每个模块都要遵守前面定好的接口和编码规则。状态编码、寄存器地址、位宽、复位方式,这些地方都不能随手改。
后面的 9 轮代码迭代,基本都发生在验证和调试阶段:发现失败,定位第一处不一致,回到相关模块,给出小补丁,再继续跑。
3. 跑前端仿真,再做回归
写完 RTL 以后,要先过编译,再跑前端仿真。
这里会先看核心模块能不能单独工作,再把整块 Tiny NPU Tile 拉起来。TB 会把输入、权重和偏置放进片上内存,再按指令顺序驱动 tile:第一层 DENSE,接 REQUANT,再跑第二层 DENSE,再 REQUANT,最后 ARGMAX。每一步结果都要和 Python 参考模型对齐,不能只看最后识别数字对不对。
这一关最容易暴露系统级小错:完成标志没有清、地址偏了 1、有符号数被当成无符号等。调这种问题,靠猜很慢,模型要检查日志和波形,先找到第一处不一致,再回到相关模块改最小的一块。
前端仿真通过以后,还要做回归。
回归可以理解成“不要只测刚刚修过的地方”。每次修改后,都要把已有测试重新跑一遍,确认旧功能没有被改坏。最后覆盖率报告里,行覆盖 94.4%,定义的功能覆盖点 100%。这说明大部分 RTL 代码和关键功能点都被测试触达过。
4. 过综合,看 PPA
回归和覆盖率过了,还要做综合。
综合可以理解成把 RTL 翻译成更接近真实电路的门级结构。前端仿真看的是“行为对不对”,综合还会继续看“这段写法能不能变成电路”。
综合以后再看 PPA,也就是频率、面积和功耗。这次估算结果里,最高频率约 202.44 MHz,面积约 0.538 mm²,估算功耗约 13.61 mW。这些数字不用展开讲太深,但它们说明这块 RTL 已经不只是“仿真跑通”,而是进入了工程评估。
5. 验证应用可用,确认交付
最后,用手写数字识别做应用级验收。
以其中一个样本为例,输入是手写6的图片,RTL 跑出的预测结果也是 6,输出分数和参考模型对齐。这个测试的重点不在识别数字本身,而在于它把指令、寄存器、片上内存、乘加阵列、量化模块和测试平台串成了一条完整链路。
最能看出差距的,是调试和收敛
接近 18 小时里,Agent 最关键的动作,是在失败之后继续往前走。
有的失败很浅,比如端口接错、位宽写错;有的失败很深,前端仿真跑到几十个周期以后才出现第一处不一致。每次失败后,模型都要先看日志,再对期望值和实际值,必要时调用仿真工具、测试工具排查问题。
这段时间也不全是在修 bug。模型还要继续优化芯片实现,让这块 tile 更像一个能交付的硬件设计。
比如矩阵尺寸不一定每次都刚好凑成 16×16,最后一块可能只剩几行、几列;输入和权重也都挤在片上内存里,一个 32 位字里可能塞了 4 个 8 位数,读错一个字节,后面整列结果都会偏。
量化边界、片上内存访问、综合检查,也都要跟着一起收敛。9 轮代码迭代,就是在这样的修复、优化、复测里走出来的。
Seed 2.1 强在哪里
这次任务能跑下来,光会写 RTL 代码还不够。
第一,是 Coding 细节够稳。它要处理状态机、位宽、有符号数、定点量化、寄存器地址、scratchpad 读写节拍,这些地方错一位就是错。
第二,是调试能力够用。前端仿真失败以后,模型要从日志、参考值、波形和最近改动里找线索,判断问题是在调度器、寄存器文件、片上内存、量化模块,还是顶层连接。
第三,是 Agent 执行能力。它要知道什么时候读规格,什么时候写代码,什么时候跑仿真,什么时候看覆盖率,什么时候查综合报告。步骤有顺序,顺序错了,跑再多也只是原地打转。
第四,是持续收敛。多轮失败以后,模型没有跑偏到解释概念,也没有随手改接口,而是继续围绕同一个目标推进。
其实就是写得动真实 RTL,调得动真实错误,用得好真实工具链。
最后
这次 Tiny NPU Tile 任务,把一条 RTL 工程流程跑成了闭环:规格有来源,架构有文档,RTL 有模块,测试有结果,失败有证据,综合有报告,最后还能完成应用验证。
对 RTL 这种容错率很低的任务,AI 光会生成答案还不够。它要能写代码,也要能改代码;要接受工具链检查,也要根据反馈继续往前推。
接近 18 小时只是背景。更能说明问题的,是 Doubao-Seed-2.1-pro 把 Coding、验证反馈和迭代修复串了起来,最后把任务推到了可交付状态。